
챗GPT는 어떻게 답할까?토큰부터 RAG까지, 그림으로 여는 AI의 속
챗GPT는 처음 보는 질문에도 답을 술술 써 내려간다. 그런데 가끔은 있지도 않은 논문을 지어내고, 막 바뀐 규정을 옛날 버전으로 설명하기도 한다. 말은 이렇게 잘하면서, 사실관계는 왜 틀릴까?
그 답은 챗봇 속을 한 칸씩 열어 보면 보인다. 글을 잘게 자르는 토큰, 다음 조각을 고르는 언어 모델, 비슷한 뜻을 찾아 주는 임베딩, 필요한 자료를 꺼내 읽게 하는 RAG까지. 직접 눌러 보고 만져 보는 체험 도구 12개와 그림을 따라, 답이 만들어지는 과정을 한 단계씩 구경해 보자. 마지막에는 이 기술들과 ‘초지능’ 사이에 어떤 물음표가 남아 있는지도 짚어 본다.
- 챗GPT, 클로드, 제미나이 같은 대규모 언어 모델(LLM)은 글을 토큰이라는 조각으로 자른 뒤, 다음에 올 토큰을 확률로 골라 가며 글을 쓴다. 그래서 말은 매끄러워도 내용이 틀릴 수 있다. 이런 현상을 환각이라고 부른다.
- 임베딩은 글의 뜻을 숫자 좌표로 바꾼다. 좌표가 가까우면 뜻도 비슷할 가능성이 크다. 질문과 관련된 자료부터 찾아 질문에 붙여 모델에 건네고, 그 자료를 보며 답하게 하는 방식이 RAG(검색 증강 생성)다.
- 초지능은 거의 모든 분야에서 사람을 크게 뛰어넘는 지능을 가리킨다. 오늘 다룰 기술이 곧 초지능이라는 말은 아니다. 언제쯤 가능할지는 전문가들 사이에서도 의견이 갈린다.
01AI 지도: 좁은 AI, AGI, 초지능
AI라는 말은 품이 아주 넓다. 사진 속 고양이를 찾아내는 프로그램도, 바둑 두는 프로그램도, 말을 걸면 대꾸하는 챗봇도 다 AI라고 부른다. 헷갈릴 때는 계단 세 칸을 떠올리면 된다.
정해진 일이나 좁은 범위만 잘하는 AI. 바둑, 번역, 스팸 거르기, 사진 분류처럼.
사람처럼 처음 보는 여러 일을 두루 해내는 수준. 무엇을 AGI로 볼지 공통 기준은 아직 없다.
거의 모든 분야에서 가장 뛰어난 사람도 크게 넘어서는 지능. 아직은 개념과 논쟁 속에 있다.
그럼 오늘의 주인공, 대규모 언어 모델(LLM)은 이 계단 어디쯤 서 있을까? 글쓰기, 요약, 번역, 코딩까지 할 줄 아는 일이 놀랄 만큼 많다. 2026년 9월에는 AI 업계 대표들이 ‘AGI 시대’를 입에 올리기도 했다(챗GPT 이후 4년 정리). 다만 이건 회사들이 쓰는 표현일 뿐, 무엇을 AGI로 볼지는 아직 합의된 기준이 없다. 반면 챗봇이 답을 만드는 기본 원리는 꽤 잘 알려져 있다. 이제 그 속으로 들어가 보자.
02LLM은 ‘다음 토큰 맞히기’ 챔피언
스마트폰 키보드에 ‘안녕’을 치면 ‘하세요’가 먼저 뜬다. 대규모 언어 모델(LLM, Large Language Model)이 하는 일도 뿌리는 같다. 지금까지 쓴 글을 보고 다음에 올 토큰으로 무엇이 가장 그럴듯한지 확률을 계산한다. 토큰은 단어 하나일 수도, 단어의 일부나 문장부호일 수도 있다(3절에서 자세히 다룬다). 차이는 규모다. LLM은 사람이 평생을 바쳐도 다 못 읽을 만큼 많은 글을 읽으며 이 확률을 다듬었다.
학습을 시작하기 전의 모델은 언어에 관해서라면 백지나 다름없다. 속에 든 수많은 숫자(가중치, weight)가 초깃값 그대로라 ‘안녕’ 다음에 뭐가 올지 감도 못 잡는다. 그러다 글을 읽으며 맞히고 틀리기를 셀 수 없이 되풀이하는 동안 숫자가 조금씩 고쳐진다. 그리고 마침내 ‘안녕’ 다음엔 ‘하세요’가 가장 자연스럽다는 패턴을 스스로 찾아낸다.
보기 쉽게 단어 단위로 나타냈고, 막대의 확률은 원리를 보여 주려고 정한 설명용 값이다. 실제 모델은 수만 개나 되는 토큰 후보 전부에 확률을 매긴다.
버튼을 누를 때마다 단어가 하나씩 붙고, 방금 붙은 단어는 다음 예측의 재료가 된다. 이렇게 자기가 쓴 글을 다시 읽으며 한 조각씩 이어 쓰는 방식을 자기회귀 생성(autoregressive generation)이라고 한다. 챗봇의 긴 답변도 결국 이 ‘한 조각 맞히기’를 수백, 수천 번 되풀이한 결과다. 화면에 답이 타자를 치듯 조금씩 흘러나오는 것도 그래서다.
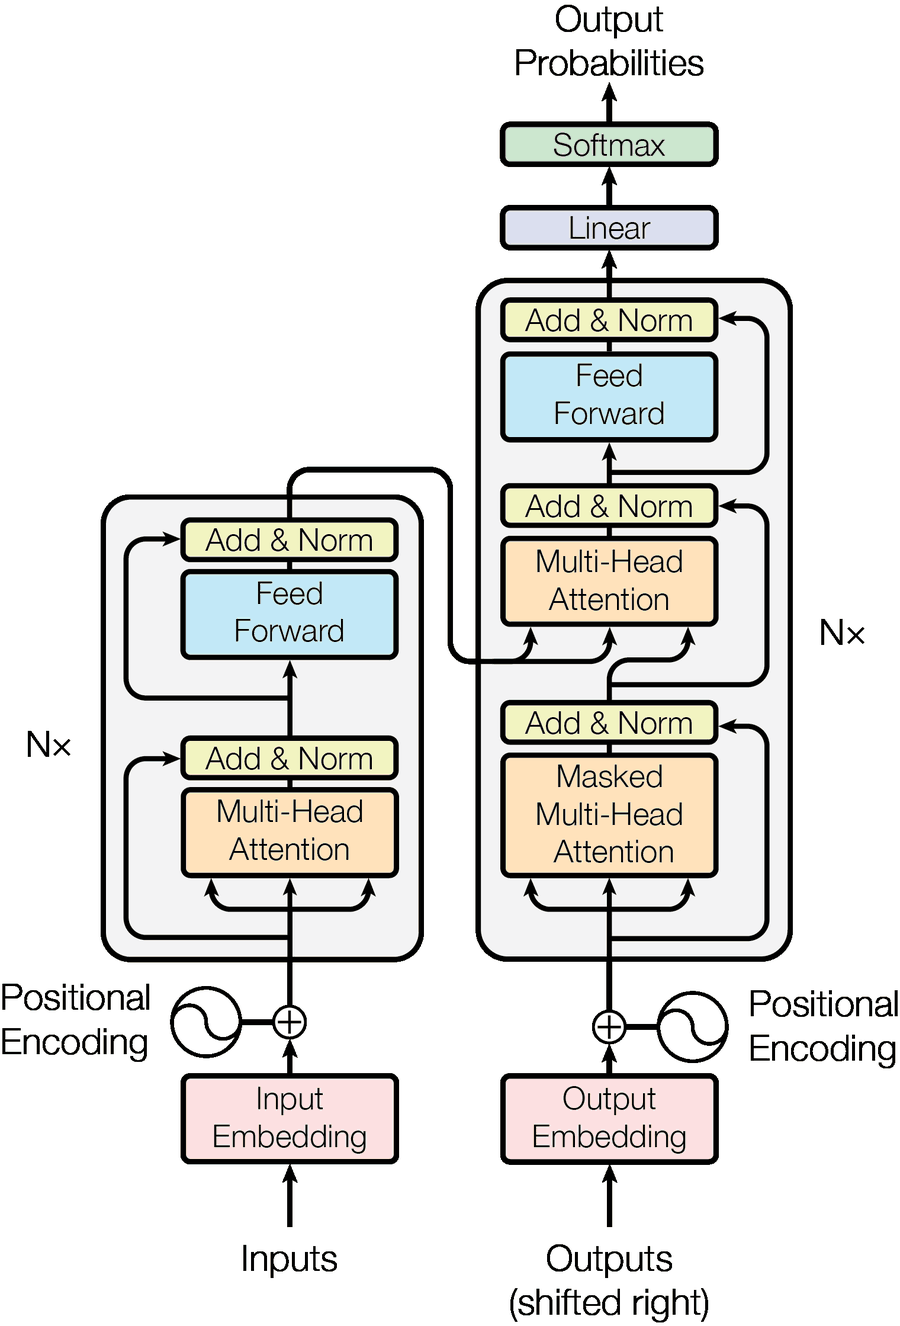
관건은 앞의 글을 얼마나 잘 읽어 내느냐다. ‘배가 아파서 병원에 갔다’의 배와 ‘배를 타고 섬에 갔다’의 배는 전혀 다른 배다. 2017년 구글 연구진이 논문 「Attention Is All You Need」에서 소개한 트랜스포머(Transformer)는 이 문제를 어텐션(attention)으로 풀었다. 문맥 속 어떤 토큰을 더 눈여겨볼지 계산하는 장치다. 글을 써 내려가는 쪽은 아직 쓰지 않은 뒤쪽 토큰을 미리 훔쳐보지 못하게 가려 둔다.[1] 오늘날 널리 쓰이는 LLM은 대부분 이 구조 위에 서 있다.
03토큰: AI가 먹는 레고 블록
AI는 글자를 사람처럼 읽지 않는다. 먼저 글을 작은 조각으로 자르고, 조각마다 번호표를 붙인다. 이 조각이 토큰(token)이다. 레고 블록을 떠올리면 쉽다. AI 눈에 문장은 번호 붙은 블록 한 줄이고, AI는 그 번호를 보고 다음 블록을 고른다.
그럼 어디서 자를까? 띄어쓰기마다 자르면(단어 단위) ‘킹받네’ 같은 신조어나 오타가 나왔을 때 사전에 없는 말이라 속수무책이다. 한 글자씩 자르면(문자 단위) 블록이 너무 잘게 쪼개져 줄이 한없이 길어진다. 그래서 요즘 모델은 중간을 택한다. 자주 나오는 덩어리는 큰 블록 하나로, 드문 단어는 작은 블록 여러 개로 나누는 하위 단어(subword) 방식이다.[2] 영어 ‘Unbelievably’가 ‘Un’+’bel’+’ievably’ 세 조각으로 나뉘는 식이다.
위 막대: 이 글에서 고른 같은 뜻의 한국어·영어 문장 5쌍을 두 인코딩(o200k_base, cl100k_base)으로 직접 쪼갠 토큰 합계. 회색 점은 한 글자가 여러 조각(바이트)으로 쪼개진 부분이다.
여기서 한국어 사용자라면 귀가 솔깃할 대목이 있다. 뜻이 같아도 언어와 토크나이저에 따라 블록 개수가 달라진다. 이 글에서 고른 같은 뜻의 한국어·영어 문장 5쌍을 쪼개 보니, o200k_base 인코딩에서는 한국어 토큰 수가 영어의 약 1.54배였다. cl100k_base에서는 2.44배까지 벌어졌다.[3] 어디까지나 이 예문들의 결과이고, 모든 한국어 문장에 들어맞는 고정 비율은 아니다. 다만 토큰 수로 요금을 매기는 API라면, 같은 말도 어느 언어로 하느냐에 따라 청구서가 달라질 수 있다. 참고로 OpenAI는 흔한 영어 문장에서 토큰 하나가 대략 4글자라고 안내한다.[4]
더 알아보기: 토큰 수는 이렇게 쟀다 (예문 5쌍)
2026년 10월 8일, 오픈소스 gpt-tokenizer 라이브러리로 o200k_base와 cl100k_base 두 인코딩으로 쟀다. 5쌍의 합계는 o200k_base에서 한국어 100개·영어 65개, cl100k_base에서 한국어 161개·영어 66개였다. OpenAI 공식 토크나이저 화면에 첫 문장을 넣어 보니 18토큰·31글자로 똑같이 나왔다. 어떤 모델이 어떤 인코딩을 쓰는지는 모델마다 따로 확인해야 한다.
- 인공지능은 다음 단어를 예측하는 방식으로 문장을 만든다. / AI builds sentences by predicting the next word. (o200k 18 / 9)
- 오늘 저녁에 아이와 함께 동네 도서관에 가서 공룡 책을 빌렸다. / This evening I went to the neighborhood library with my kid and borrowed a dinosaur book. (24 / 17)
- 검색 증강 생성은 인공지능이 시험을 볼 때 책을 펼쳐 보게 하는 방법이다. / Retrieval-augmented generation lets an AI open the book during the test. (23 / 16)
- 안녕하세요, 만나서 반갑습니다. / Hello, nice to meet you. (9 / 7)
- 환각은 인공지능이 모르는 것을 아는 척 그럴듯하게 지어내는 현상이다. / A hallucination is when an AI confidently makes up something it does not know. (26 / 16)
04온도: 모범생 모드와 시인 모드
같은 질문을 두 번 했는데 답이 달라서 고개를 갸웃한 적이 있다면, 안심해도 된다. 고장 난 게 아니다. AI는 다음 토큰을 고를 때 매번 1등 후보만 집지 않고, 확률에 따라 주사위를 굴리듯 뽑는다. 이 주사위를 얼마나 과감하게 굴릴지 정하는 손잡이가 온도(temperature)다.
온도를 낮추면 확률 높은 후보에 선택이 몰려 답이 덜 흔들린다. 높이면 확률이 고르게 퍼져 뜻밖의 후보도 곧잘 뽑힌다. OpenAI API 문서는 온도를 0에서 2 사이로 정하고, 0.8처럼 높이면 답이 더 무작위해지고, 0.2처럼 낮추면 더 집중되고 예측 가능해진다고 설명한다.[5]
후보마다 고정된 점수(로짓)를 정해 두고, 온도로 나눈 뒤 확률로 바꾸는 실제 계산식(소프트맥스)을 그대로 돌린다. 후보와 점수는 설명용이다.
여기서 흔한 오해가 하나 있다. 온도를 낮추면 답이 더 정확해질까? 그렇지 않다. 온도는 모델이 이미 매겨 둔 확률표에서 얼마나 모험할지를 정할 뿐, 확률표 자체를 고치지는 않는다. 모델이 ‘호주의 수도는’ 다음에 올 말로 ‘시드니’에 가장 높은 확률을 매겼다고 해 보자. 정답은 캔버라인데도 말이다. 온도를 낮출수록 1등인 시드니가 뽑힐 확률은 오히려 더 높아진다. 온도를 바닥까지 내리면 거의 매번 시드니라고 답한다. 한결같이 틀릴 뿐이다.
그래서 쓰임새가 갈린다. 매번 비슷한 형식의 답이 필요하면 온도를 낮게, 아이디어 회의나 이야기 짓기처럼 엉뚱함이 반가운 일에는 조금 높게 둔다. 너무 올리면 문장이 횡설수설할 수 있다. 정확성은 온도 손잡이가 아니라 근거 자료와 확인으로 챙겨야 한다.
05환각: 왜 AI는 모를 때도 답부터 할까?
LLM의 가장 유명한 약점은 환각(hallucination)이다. 사실이 아닌 내용을 사실처럼 당당하게 말하는 현상이다. 있지도 않은 논문 제목을 지어내거나, 받은 적 없는 상을 받았다고 우기기도 한다.
왜 그럴까? OpenAI는 2025년 9월 연구에서 흥미로운 답을 내놓았다. 지금의 훈련과 평가 방식이 ‘모르겠다’는 솔직함보다 찍어서 맞히는 쪽에 점수를 더 준다는 것이다.[6] 객관식 시험을 떠올려 보자. 모르는 문제를 비워 두면 0점이지만, 찍으면 운 좋게 맞을 수도 있다. 누군가의 생일을 몰라도 ‘9월 10일’이라고 찍으면 365분의 1 확률로 맞는다. 문제가 수천 개쯤 되면 찍는 쪽 점수가 더 높게 나온다.[6] 우리가 시험장에서 터득한 요령을 AI도 똑같이 배운 셈이다.
두 학생 모두 100문제 가운데 60문제는 확실히 안다. 나머지 40문제(4지선다) 앞에서 한 명은 전부 찍고, 다른 한 명은 ‘모르겠다’고 적는다.
찍어서 맞힐 확률을 4분의 1로 놓고 기댓값으로 계산했다. 찍는 학생은 40문제 중 평균 10문제를 맞히고 30문제를 틀린다.
그래서 연구진은 채점표부터 고치자고 제안한다. 자신 있게 틀린 답은 더 크게 깎고, 모를 때 모른다고 하면 부분 점수를 주자는 것이다.[6] AI를 쓰는 우리 쪽에도 꺼내 들 도구가 있다. 바로 아래의 프롬프트, 그리고 9절의 RAG다.
프롬프트: 룰북과 주문서
AI에게 건네는 지시문을 프롬프트(prompt)라고 한다. 여기서는 시스템 프롬프트와 사용자 프롬프트, 두 가지만 보자. 시스템 프롬프트는 대화 내내 지킬 역할과 규칙을 적어 둔 룰북이다. ‘너는 초등학생에게 설명하는 과학 선생님이다. 모르면 모른다고 말한다’ 같은 식이다. 사용자 프롬프트는 그 룰북 아래에서 그때그때 넣는 주문이다. 같은 주문이라도 룰북이 바뀌면 말투도, 조심하는 정도도 달라진다.
답변은 차이를 보여 주려고 직접 쓴 예시다.
06임베딩: 의미에 GPS 좌표를 붙이다
AI는 ‘강아지’와 ‘개’가 비슷한 말이라는 걸 어떻게 알까? 비결은 임베딩(embedding)이다. 단어나 문장을 숫자 여러 개로 된 좌표로 바꾸는 기술이다. 서울과 수원의 위도·경도가 비슷하듯, 뜻이 비슷한 말은 서로 가까운 좌표를 받는다. 말하자면 단어마다 주소를 붙여 주는 셈이다.
이해를 돕는 2차원 그림이다. 실제 임베딩은 수백에서 수천 차원이고, 단어 위치도 모델마다 다르다.
재미있는 건 좌표끼리 더하고 뺄 수도 있다는 점이다. 2013년 구글 연구진은 ‘King(왕)’의 좌표에서 ‘Man(남자)’을 빼고 ‘Woman(여자)’을 더하면 ‘Queen(여왕)’ 근처에 도착한다는 사실을 보여 줬다.[7] 뜻이 좌표 공간의 ‘방향’으로 저장돼 있다는 이야기다. 물론 늘 이렇게 깔끔하게 맞아떨어지지는 않는다. 위의 ‘왕 − 남자 + 여자’ 버튼으로 직접 확인해 보자.
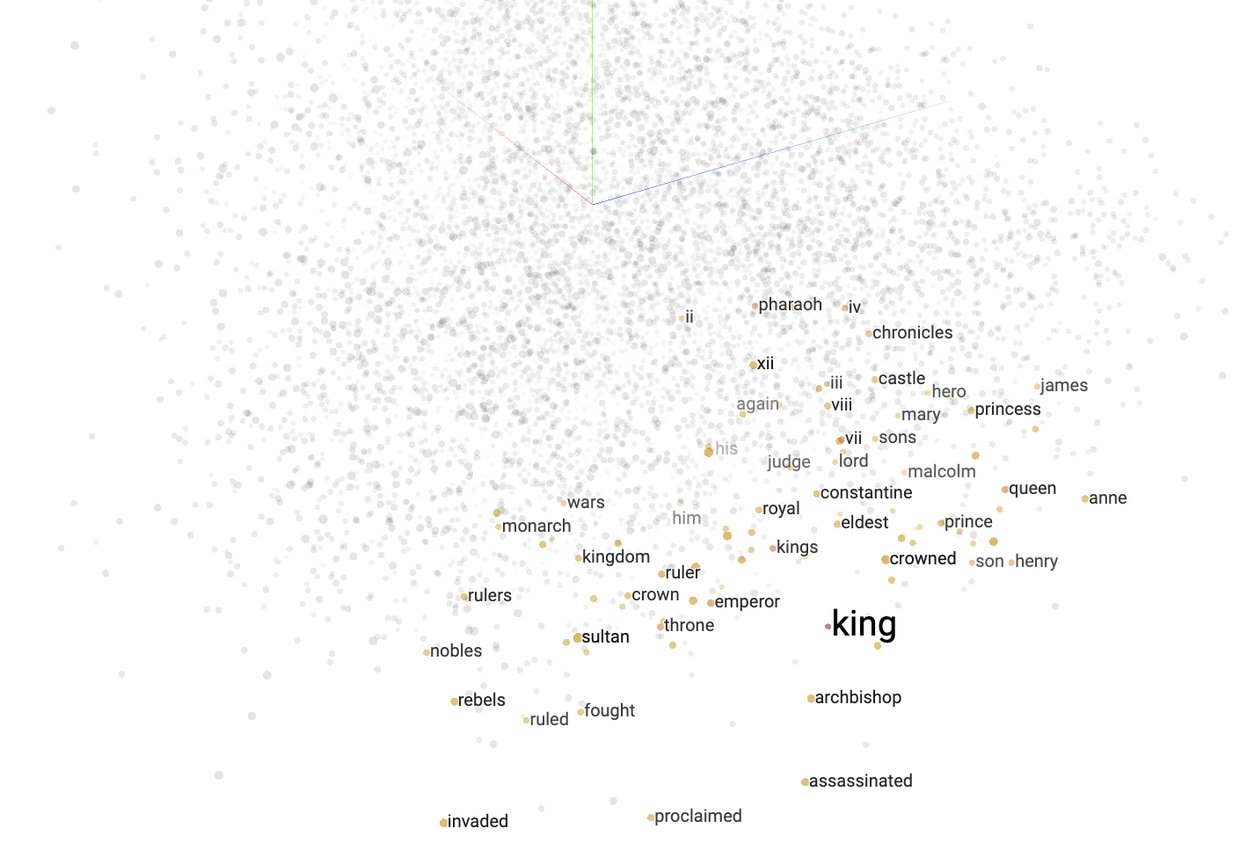
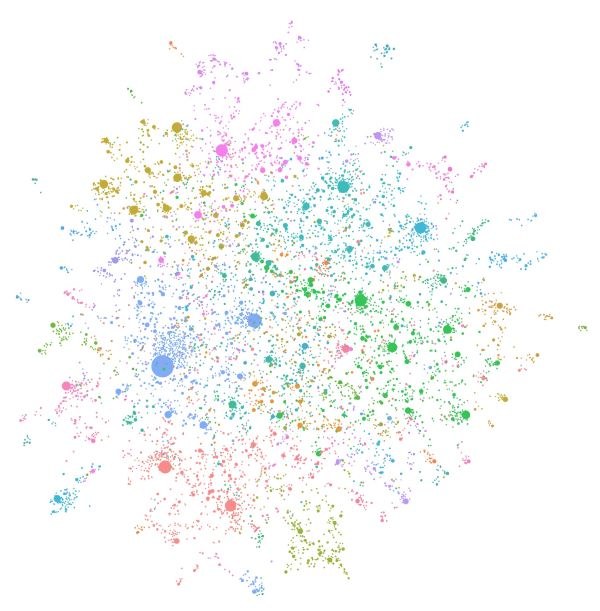
진짜 임베딩은 이 그림처럼 납작한 2차원이 아니다. 아래 그림 속 단어 1만 개는 저마다 숫자 200개짜리 좌표를 달고 있다. 200차원을 3차원으로 꾹 눌러 그렸는데도 ‘king’ 주변에 queen, prince(왕자), throne(왕좌), emperor(황제)가 옹기종기 모여 있다.
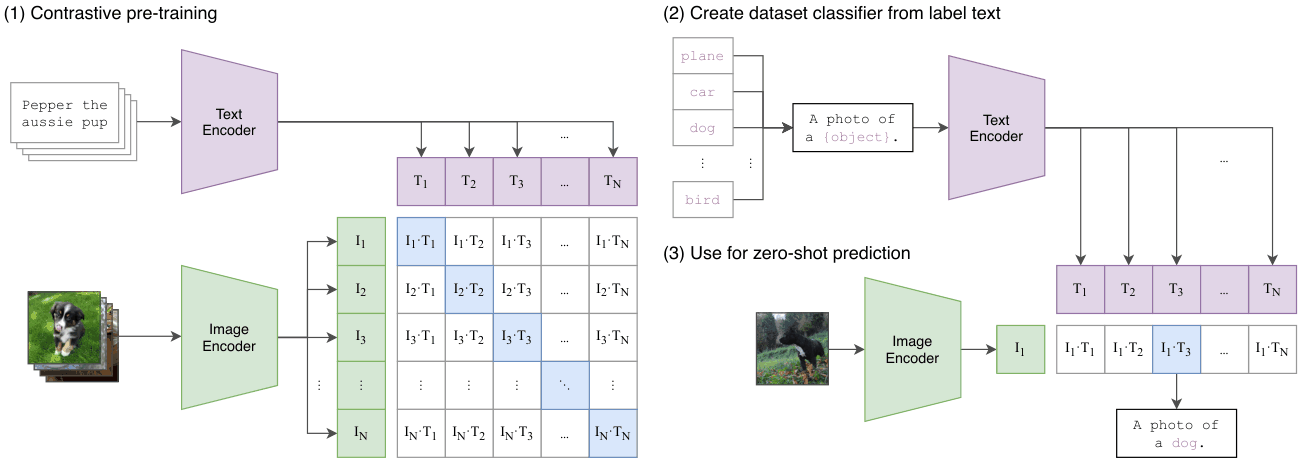
좌표는 글에만 붙는 게 아니다. 2021년 OpenAI가 공개한 CLIP은 사진과 설명 글을 한 지도 위에 올렸다.[9] 강아지 사진의 좌표와 ‘강아지’를 설명하는 글의 좌표가 가까워지도록, 수많은 사진과 글 짝으로 학습시켰다. 덕분에 글로 사진을 찾고, 사진에 어울리는 설명도 고른다. 이렇게 글과 사진처럼 형태가 다른 데이터를 한 지도에 담는 방식을 멀티모달(multimodal) 임베딩이라고 한다.
07코사인 유사도: 화살표가 같은 쪽을 보나
그럼 좌표가 ‘가깝다’는 건 어떻게 잴까? 글의 임베딩을 비교할 때 널리 쓰는 잣대가 코사인 유사도(cosine similarity)다. 원점에서 두 좌표로 화살표를 그린 뒤, 두 화살표가 벌어진 각도만 본다. 같은 쪽을 가리키면 1, 직각이면 0, 정반대면 -1이다.
파란 화살표가 기준 문장, 주황 화살표가 비교할 문장이다. 길이 슬라이더는 코사인이 화살표 길이에는 신경 쓰지 않는다는 점을 보여 준다.
코사인 유사도는 두 벡터의 크기가 아니라 방향이 얼마나 닮았는지를 본다. 길이 슬라이더를 아무리 움직여도 값이 그대로인 이유다. 다만 화살표 길이를 글자 수나 문서 분량으로 생각하면 안 된다. 아예 모든 벡터의 길이를 1로 맞춰 쓰는 임베딩 모델도 있다. OpenAI 임베딩이 그렇고, 이때는 코사인 유사도로 재든 직선거리(유클리드 거리)로 재든 검색 순위가 똑같이 나온다.[10] 그리고 코사인 값이 높다고 두 글의 뜻이 같다고 못 박을 수는 없다. 이 숫자는 ‘얼마나 같은 쪽을 보고 있나’를 알려 줄 뿐이다.
08벡터 DB: 수억 개 좌표에서 이웃 찾기
회사 문서 수백만 개를 전부 좌표로 바꿨다고 하자. 이제 질문과 가장 가까운 좌표를 재빨리 찾아야 하는데, 하나하나 거리를 재다가는 해가 진다. 이 일을 전문으로 하는 저장소가 벡터 데이터베이스(vector DB)다. 메타가 공개한 FAISS 같은 라이브러리부터 Milvus, Qdrant, Pinecone, Chroma 같은 전용 DB, 벡터 검색 기능을 더한 Elasticsearch까지 선택지가 많다.
빠른 비결은 근사 최근접 이웃(ANN) 검색이다. 100점짜리 정답을 고집하는 대신 ‘거의 가장 가까운 이웃’을 훨씬 빨리 찾는 방식이다. 그중 널리 쓰이는 HNSW는 ‘몇 다리만 건너면 누구와도 아는 사이’라는 작은 세상 아이디어를 빌렸다.[11] 맨 위층에는 점이 몇 개뿐이라 고속도로처럼 성큼성큼 건너뛰고, 아래층으로 내려갈수록 점이 촘촘해져 골목길을 따라 가장 가까운 이웃을 찾아간다.
좌표 하나에 숫자가 수백, 수천 개씩 붙으니 메모리도 많이 먹는다. 그래서 정밀도를 조금 낮춰 숫자를 압축하는 양자화(quantization)를 함께 쓰곤 한다. 작성일이나 부서 같은 꼬리표(메타데이터)로 범위를 먼저 좁히는 기능도 쓸모가 크다. ‘작년 마케팅팀 문서 중에서 이 질문과 비슷한 것’만 골라 찾는 식이다.
09RAG: AI에게 오픈북 시험을 허락하다
모델이 학습으로 익힌 지식에는 유통기한과 빈칸이 있다. 최신 자료나 검색 도구를 쥐여 주지 않으면 어제 바뀐 회사 규정이나 오늘 주가를 정확히 답하기 어렵다. 그런데도 물어보면 아는 척 대답하기도 한다. 앞에서 본 그 환각이다.
2020년 메타(당시 페이스북 AI 리서치)의 패트릭 루이스 연구진이 내놓은 해법이 RAG(Retrieval-Augmented Generation, 검색 증강 생성)다.[12] 모델의 머릿속 기억(파라미터)에 바깥 문서 저장소를 짝지어, 답하기 전에 관련 문서부터 찾아 읽게 한다. 찾은 문서는 다 쓴 답 뒤에 붙이는 부록이 아니다. 답을 쓰기 전에 질문과 함께 건네는 참고 자료다. 책을 덮고 치르던 시험(클로즈드북)을 책을 펴고 치르는 시험(오픈북)으로 바꾼 셈이다.
RAG의 장점은 세 가지다. 첫째, 모델을 다시 학습시키지 않아도 문서와 검색 인덱스만 갱신하면 새 정보를 쓸 수 있다. 물론 벡터 검색을 쓴다면 바뀐 문서의 임베딩은 새로 만들어 넣어야 한다. 둘째, 찾은 문서를 답의 근거로 보여 줄 수 있다. 셋째, 사용자 권한을 검색 필터에 연결하면 사람마다 볼 수 있는 문서를 다르게 정할 수 있다. 요즘은 LangChain 같은 도구 덕분에 코드를 많이 짜지 않고도 RAG를 꾸릴 수 있다.
문서를 얼마나 잘게 자를까: 청킹
긴 문서는 입력 한도와 검색 효율을 생각해 조각(청크, chunk)으로 나누는 경우가 많다. 김밥 썰기와 비슷하다. 너무 얇게 썰면 질문과 딱 맞는 조각을 찾기는 쉽지만, 한 조각에 든 맥락이 모자라 답을 엮기 어렵다. 너무 두껍게 썰면 맥락은 넉넉해도 상관없는 내용이 섞여 검색 순위에서 밀린다. 그래서 글자 수만 세어 기계적으로 자르기보다 문단과 문장의 경계를 살려 자르는 방법을 많이 쓴다.
막대는 경향을 보여 주는 설명용 그림이다. 알맞은 크기는 문서 종류와 질문에 따라 실험으로 정한다.
그렇다고 조각을 많이 넣는 게 능사는 아니다. 2023년 스탠퍼드대 등 연구진은 입력이 길어지면 한가운데 놓인 정보를 모델이 잘 써먹지 못하는 ‘중간 유실(lost in the middle)’ 현상을 보고했다. 같은 정보라도 맨 앞이나 맨 뒤에 있을 때 상대적으로 더 잘 쓰였다.[13] 긴 회의에서 처음과 마지막 말만 기억에 남는 것과 닮았다. 중요한 정보를 어디에 둘지, 문서를 어떤 순서로 넣을지 조정하고, 그 효과를 직접 평가해 봐야 하는 이유다.
10RAG와 파인튜닝: 유학 보낸 요리사, 주방 태블릿
우리 회사 자료를 AI가 쓰게 하는 대표적인 방법은 두 가지다. 파인튜닝(fine-tuning)은 모델의 가중치 자체를 더 학습시킨다. RAG는 모델은 그대로 두고, 필요할 때마다 문서를 찾아 건넨다.
시칠리아에서 유학하고 온 요리사는 레시피 없이도 그 지역의 조리법과 스타일로 척척 요리한다. 지식이 몸(가중치)에 밴 것이다. 대신 새 메뉴가 생기면 또 유학을 보내야(재학습) 한다.
요리사는 그대로다. 대신 오늘 재고와 최신 레시피가 뜨는 태블릿을 옆에 두고 요리한다. 요리사를 다시 가르칠 필요 없이, 레시피 파일과 목록만 바꿔 넣으면 새 메뉴도 바로 찾아본다.
| 비교 | RAG | 파인튜닝 |
|---|---|---|
| 새 정보 반영 | 모델 재학습 없이 문서와 검색 인덱스를 갱신 | 다시 학습해야 함 |
| 근거 보여 주기 | 찾은 문서를 출처로 제시 | 근거를 따로 보여 주기 어려움 |
| 사람별 접근 권한 | 사용자 권한에 따라 검색 결과를 제한하도록 설계 가능 | 가중치에 섞여 나누기 어려움 |
| 필요한 것 | 문서 검색 체계 (구성에 따라 임베딩·벡터 DB) | 학습 데이터와 학습 환경, 또는 관리형 학습 서비스 |
| 잘 맞는 일 | 사내 규정 Q&A, 최신 자료 요약 | 정해진 말투·형식, 전문 분야 문체 |
실제로는 둘을 함께 쓰는 경우가 많다. 업무 말투와 보고서 형식은 파인튜닝으로 몸에 익히게 하고, 정확한 숫자와 최신 규정은 RAG로 그때그때 가져오는 식이다. 유학 다녀온 요리사에게 태블릿까지 쥐여 주는 셈이다.
11더 똑똑한 RAG: 검색 둘을 합치고, 면접 보고, 지도 그리기 심화
하이브리드 검색과 RRF
뜻으로 찾는 임베딩 검색은 눈치가 빠르다. ‘호텔비’를 물으면 ‘숙박비 한도표’까지 찾아낸다. 그런데 ‘TRV-23’ 같은 규정 코드나 드문 고유명사는 오히려 놓칠 때가 있다. 이럴 땐 글자가 똑같은지 따지는 키워드 검색(BM25 등)이 강하다. 그래서 둘을 함께 돌려 결과를 합친다. 이게 바로 하이브리드 검색이다.
문제는 두 검색이 점수를 매기는 잣대가 다르다는 점이다. 100점 만점 시험과 5점 만점 평가를 그대로 더하는 꼴이라, 한쪽 점수가 결과를 좌우하기 쉽다. 그래서 점수 대신 등수만 쓰는 RRF(Reciprocal Rank Fusion)를 많이 쓴다.[14] 문서마다 1 ÷ (k + 등수)를 두 검색에서 각각 구해 더하면 끝이다. 처음 제안한 연구에서는 k를 60으로 썼다. 이렇게 하면 한쪽에서만 1등인 문서보다 양쪽에서 고르게 상위권인 문서가 맨 위로 올라오기 쉽다.
| 문서 (합친 순위) | 의미 검색 등수 | 키워드 검색 등수 | RRF 점수 |
|---|
문서와 등수는 설명용 예시다. k가 작을수록 1등 문서의 힘이 세지고, 클수록 순위가 고르게 섞인다.
리랭커: 서류 전형 다음은 면접
하이브리드 검색으로 출장비 질문의 후보 50개를 추렸다면, 이제 리랭커(reranker)가 순위를 다시 매길 차례다. 1차 벡터 검색은 질문과 문서를 따로따로 좌표로 바꿔 견주는 서류 전형이다. 빠르지만 단어 사이의 미묘한 관계는 놓칠 수 있다. 리랭커로 쓰는 크로스 인코더(cross-encoder)는 질문과 문서를 나란히 놓고 함께 읽으며, 둘이 얼마나 관련 있는지 점수를 매기는 면접관이다. 점수 범위는 모델과 설정에 따라 다르다.[15] 대개 더 정확하지만 느리다. 그래서 서류를 통과한 몇 명만 면접장에 부른다.
GraphRAG: 흩어진 점을 선으로 잇다
‘스티브 잡스의 친여동생은 학부를 어느 대학에서 마쳤을까?’ 이런 질문은 한 문서만 봐서는 답이 안 나올 때가 많다. 잡스를 다룬 문서에는 여동생 이름이, 여동생을 다룬 문서에는 학교 이름이 따로 들어 있기 때문이다. 비슷한 조각을 찾아 건네는 보통 RAG는 이렇게 징검다리를 두 번 건너야 하는 질문에 약하다.
마이크로소프트 리서치가 2024년 발표한 GraphRAG는 색인을 두 단계로 만든다. 먼저 문서에서 사람, 회사, 장소 같은 개체(노드)와 그 관계(엣지)를 뽑아 지식 그래프를 그린다. 그다음 서로 가까운 개체 무리(커뮤니티)마다 요약을 미리 써 둔다.[16] 질문이 들어오면 관계선을 따라가며 흩어진 사실을 잇고, 무리별 요약을 모아 자료 전체를 종합한다. 논문이 특히 겨냥한 건 ‘이 자료 전체의 주요 주제는?’처럼 문서 몇 조각으로는 답할 수 없는 질문이다.[16] 회사 규정집 전체를 놓고 ‘최근 1년 동안 가장 자주 바뀐 항목은?’을 묻는 경우가 딱 그렇다.
모나 심프슨은 스티브 잡스의 친여동생으로, UC 버클리에서 학사를, 컬럼비아대에서 석사(MFA)를 받았다.[17][18] 그래프는 관계를 따라가는 모습만 보여 주려고 단순하게 그렸다.
12잘하고 있나? RAG 채점표, RAGAS 심화
RAG를 만들었으면 성적표도 받아 봐야 한다. 답이 틀렸을 때 문서를 잘못 찾아서인지, 찾은 문서를 잘못 읽어서인지 알아야 고칠 곳이 보인다. 2023년 공개된 RAGAS는 LLM을 심판으로 세워 검색과 생성을 따로 채점하는 도구다. 논문은 사람이 만든 참조 답안 없이도 잴 수 있는 지표를 앞세웠다.[20] 지금 라이브러리에는 참조 답안을 쓰는 지표와 쓰지 않는 지표가 함께 들어 있다.[21] 여기서는 검색과 답변 품질을 살피는 지표 네 가지만 보자.[22]
쓸모 있는 조각이 위쪽에 잘 놓였나. 참조 답안과 견주는 방식도 있고, 참조 답안 없이 생성된 답변과 견주는 방식(Context Utilization)도 있다.
답에 필요한 정보를 빠짐없이 찾아왔나. 무엇을 빠뜨렸는지 판단할 참조 답안이나 참조 문서가 필요하다.
답에 담긴 주장이 찾아온 문서로 뒷받침되나. 검색 문서와 답변을 맞대 본다.
묻는 말에 제대로 답했나. 딴소리하거나 빠뜨린 부분은 없나. 질문과 답변이 얼마나 맞닿는지 본다.
출장비 질문으로 예를 들어 보자. 답에 ‘숙박비 한도 1박 15만 원’이 나왔는데 찾아온 문서 어디에도 그 숫자가 없다면 충실성 점수가 떨어진다. 이럴 때는 문서로 뒷받침되지 않는 주장이 답에 섞였는지 살펴본다. 그리고 모델이 문서를 쓰는 방식을 손보고, ‘근거 문서에 없는 내용은 단정하지 말 것’ 같은 지시문을 더한다. 컨텍스트 정밀도가 낮으면 리랭커를 붙여 보고, 재현율이 낮으면 청킹 방식을 고치거나 조각을 더 많이 찾아오게 한다.
다만 충실성과 답변 관련성이 높다고 현실의 사실까지 다 맞는다는 보장은 없다. 찾아온 규정이 낡은 버전이라면, 그 문서에 충실한 답 역시 성실하게 낡은 답이 된다.
13그래서, 초지능은 언제 올까?
초지능이라는 아이디어는 의외로 오래됐다. 1965년 통계학자 I. J. 굿은 ‘아무리 영리한 사람의 모든 지적 활동도 훨씬 뛰어넘는 기계’를 상상했다. 그런 기계는 더 나은 기계를 설계할 수 있고, 그러면 ‘지능 폭발’이 일어나 사람의 지능은 한참 뒤처질 것이라고 썼다. 그는 이런 기계가 인류에게 필요한 마지막 발명이 될 수 있다고 하면서도 조건을 하나 달았다. 그 기계가 자기를 통제하는 법을 우리에게 알려 줄 만큼 고분고분하다면 말이다.[23]
철학자 닉 보스트롬은 초지능을 ‘모든 중요한 인지 영역에서 가장 뛰어난 인간의 두뇌를 크게 능가하는 범용 지능’이라고 설명했다.[24] 체스처럼 한 분야에서만 사람을 이기는 프로그램은 아무리 강해도 여기에 끼지 못한다.
다시 오늘의 부품으로 돌아가 보자. 지금의 대화형 AI 서비스는 다음 토큰을 고르는 LLM, 뜻을 좌표로 바꾸는 임베딩, 바깥 문서를 찾아오는 RAG 같은 부품을 엮어 일한다. 이렇게 짠 AI 시스템은 이미 여러 작업을 사람보다 빠르게 해치운다. 그래도 여전히 모르는 걸 지어내고 문서를 잘못 짚는다. 그래서 채점표로 꾸준히 점검받아야 한다. 이런 시스템이 초지능까지 갈 수 있을지, 간다면 언제일지는 전문가들 사이에서도 의견이 크게 갈린다. 이 글이 날짜를 점치지 않는 이유다. AI 에이전트가 실제로 금지선을 넘은 사례가 궁금하다면 AI 에이전트 통제 사고 정리를 펼쳐 보자.
이제 AI의 답이 수상할 때 어디부터 들여다볼지 감이 조금은 잡혔을 것이다. 최신 자료가 없었던 걸까? 엉뚱한 문서를 찾아온 걸까? 아니면 자료에도 없는 이야기를 덧붙인 걸까?
원리를 안다고 모든 오류를 막을 수는 없다. 그래도 말이 매끄럽다는 이유만으로 덜컥 믿어 버리는 일은 줄일 수 있다. 중요한 답이라면 출처를 열어 보고, 날짜와 숫자를 한 번 더 확인하자. 초지능이 언제 올지는 몰라도, 오늘의 AI를 더 똑똑하게 쓰는 일은 지금 당장 시작할 수 있다.
읽고 나면 생기는 질문 5가지
AI는 질문의 뜻을 사람처럼 이해하고 답할까?
사람과 같은 방식은 아니다. LLM은 앞의 글을 보고 다음 토큰이 무엇일지 확률을 계산해 한 조각씩 이어 쓴다. 그 과정에서 뜻을 꽤 잘 다루는 패턴을 익혔지만, 여전히 그럴듯하게 틀린 말을 할 때가 있다.
한국어로 물어보면 요금이 더 나올까?
토큰 수로 요금을 매기는 API라면 그럴 수 있다. 같은 뜻이어도 언어와 토크나이저에 따라 토큰 수가 달라지기 때문이다. 이 글에서 고른 예문 5쌍에서는 o200k_base 기준으로 한국어가 영어의 약 1.54배였다. 다만 어디까지나 이 예문들의 결과이고, 고정된 비율은 아니다.
온도를 가장 낮추면 환각이 사라질까?
아니다. 온도는 모델이 이미 매겨 둔 확률표에서 얼마나 모험할지를 정할 뿐, 무엇이 사실인지는 바꾸지 못한다. 온도를 가장 낮추면 모델은 거의 매번 1등 후보만 고른다. 그런데 모델이 사실을 잘못 알고 있다면 그 1등 후보부터가 오답이라, 같은 오답을 매번 되풀이할 뿐이다. 환각을 줄이려면 근거 자료를 함께 건네는 RAG와 출처 확인이 필요하다.
RAG를 쓰면 AI가 절대 틀리지 않을까?
아니다. 문서를 잘못 찾거나, 찾은 문서를 잘못 읽거나, 찾은 문서 자체가 낡았을 수 있다. 그래서 리랭커로 순위를 다듬고, RAGAS 같은 채점표로 검색과 생성을 따로 점검한다.
초지능은 벌써 나왔거나 곧 나올까?
정해진 답이 없다. 초지능은 거의 모든 분야에서 가장 뛰어난 사람을 크게 넘어서는 지능을 가리키는 개념이다. 업계에서 AGI 시대라는 말이 나오지만, 무엇을 AGI로 볼지조차 합의되지 않았다. 초지능이 언제 가능할지도 전문가 사이에서 의견이 크게 갈린다.
출처
- [1]Vaswani et al. · Attention Is All You Need (2017)
- [2]Sennrich, Haddow, Birch · Neural Machine Translation of Rare Words with Subword Units (2015)
- [3]gpt-tokenizer (GitHub) · o200k_base, cl100k_base
- [4]OpenAI · Tokenizer
- [5]OpenAI API Reference · Responses: temperature
- [6]OpenAI · Why language models hallucinate (2025.09.05)
- [7]Mikolov et al. · Efficient Estimation of Word Representations in Vector Space (2013)
- [8]TensorFlow · Embedding Projector
- [9]Radford et al. · Learning Transferable Visual Models From Natural Language Supervision (CLIP, 2021)
- [10]OpenAI Help Center · Embeddings FAQ: Which distance function should I use?
- [11]Malkov, Yashunin · Efficient and Robust Approximate Nearest Neighbor Search Using HNSW Graphs (2016)
- [12]Lewis et al. · Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- [13]Liu et al. · Lost in the Middle: How Language Models Use Long Contexts (2023)
- [14]Cormack, Clarke, Büttcher · Reciprocal Rank Fusion (SIGIR 2009)
- [15]Sentence Transformers · Cross Encoder usage
- [16]Edge et al. · From Local to Global: A Graph RAG Approach to Query-Focused Summarization (2024)
- [17]Wikipedia · Mona Simpson
- [18]Bard College · Mona Simpson, faculty profile
- [19]Microsoft Research Blog · GraphRAG: Unlocking LLM discovery on narrative private data (2024.02.13)
- [20]Es et al. · RAGAS: Automated Evaluation of Retrieval Augmented Generation (2023)
- [21]Ragas docs · Context Precision and Context Utilization
- [22]Ragas docs · Available Metrics
- [23]I. J. Good · Speculations Concerning the First Ultraintelligent Machine (1965)
- [24]Nick Bostrom · Superintelligence (2009 Edge Question answer)
논문과 공식 문서를 먼저 확인했다. 토큰 수는 2026년 10월 8일 직접 잰 값이다. 환각의 원인 설명은 OpenAI 연구진의 주장이며, 기업 블로그와 문서는 각 회사의 설명이다. 그림과 화면은 출처를 밝혀 설명 목적으로 실었다.
다음 AI 테크 노트도 받아보기
새 글 알림을 원한다면 홈의 구독 신청을 이용할 수 있다.
구독 안내 보기 ↗
