
말하지 않는 AI가 뜬다: Jev·OpenAI·AWS의 ‘판단 AI’ 경쟁, 진짜 승부는 따로 있다 싸고 빠른 판단을 어디까지 믿고 실행해도 될까
“정산금이 사흘째 입금되지 않았어요.” 이 문의를 재무팀에 보낼지 영업팀에 보낼지 고르는 데 긴 설명은 필요 없다. 필요한 건 빠른 분류, 그리고 애매할 때 멈춰 설 기준이다. TypeSafe AI가 9월 15일 공개한 Jev는 바로 이런 작은 판단만 맡는 결정 모델(decision model)이다. 해설 없이 휘슬만 부는 심판처럼, Jev는 글을 쓰지 않는다. 정해진 질문을 받으면 선택 결과와 확률·점수를 소프트웨어가 바로 쓸 수 있는 형태로 돌려줄 뿐이다.
경쟁자는 금방 나타났다. 그 뒤 16일 사이에 OpenAI는 Decisions API를 발표했고, AWS는 내려받아 직접 돌릴 수 있는 Strands Decider 2B를 공개했다. OpenAI는 10월 6일 이 API를 모든 개발자에게 열고 요금까지 내놓았다. 한쪽은 남이 운영해 주는 API의 편리함을, 다른 쪽은 직접 돌리고 고칠 수 있는 자유를 내세운다. 그런데 더 중요한 질문은 누가 가장 빠르냐가 아니다. 판단이 싸고 빨라졌을 때, 우리는 그 판단에 어디까지 실행을 맡겨도 될까?
공개 자료 해설·분석 · 편집: 단단한 아빠 · 작성 기준
가격과 응답 시간은 TypeSafe 공식 블로그와 문서 기준이다. 투자와 기업가치는 모델이 아니라 TypeSafe라는 회사의 숫자다. 시드 투자는 보도 자료와 포브스 기사, 100억 달러 이상 논의는 The Information의 유료 기사가 출처다. 이 논의는 10월 6일까지 확정 발표가 나오지 않았다.[1][2][3][4][5]
성능 비교, 보안 연구, 사람 검토, 운영 방식을 차례로 따라가며 답을 찾아본다.
Jev는 정해진 질문에 선택 결과와 확률·점수를 돌려준다. 입력 100만 토큰당 0.042달러, 출력은 무료다.
Laya(9/18), OpenAI Decisions API(9/29), AWS Strands Decider 2B(10/1)가 잇따라 나왔다. Decisions API는 10/6 공개 베타로 열렸다.
한 독립 평가에서 일부 언어 분류는 Claude Haiku와 비슷했고, 숫자·날짜 비교는 약했다.
문서에 덧붙인 가짜 증거에 판단이 바뀌었다. 실행 권한은 코드에 둬야 한다.
01. 글 대신 확률: 결정 모델은 무엇이 다른가
흔히 쓰는 생성형 언어 모델은 답을 토큰 하나하나 이어 붙여 만든다. 설명 없이 짧은 분류 결과나 JSON만 내놓게 할 수는 있지만, 그 짧은 답도 결국 생성 과정을 거친다.[6] Jev는 자유로운 글쓰기를 내려놓는 대신, 개발자가 정한 질문의 선택지마다 확률이나 점수를 한 번에 계산해 돌려주는 데 집중한다.[1] 핵심은 말수가 적다는 데 있지 않다. 처음부터 소프트웨어의 작은 판단을 빠르게 처리하도록 설계했다는 데 있다.
TypeSafe는 이런 모델을 ‘시스템 원(System One) 모델’이라고 부른다. 대니얼 카너먼이 말한 빠르고 직관적인 ‘시스템 1’ 사고에서 따온 이름이다. 질문 형식은 하나를 고르는 Choice, 정도를 재는 Score, 정답이 ‘예’일 확률을 0~1 사이 숫자로 돌려주는 Noul 세 가지다.[1] Choice와 Score는 답과 함께 확신도(confidence) 값을 주지만, Noul은 ‘예’일 확률 하나만 준다. 그러니 두 값을 같은 잣대로 읽으면 안 된다. 특히 Noul 값이 0에 가깝다고 해서 모델이 망설인다는 뜻은 아니다. 답이 ‘아니오’일 가능성이 높다는 뜻이다.[7] 쓰는 법은 Jev 사용법 글에 정리해 두었으니, 여기서는 생성형 모델과 결정 모델이 같은 질문을 어떻게 다르게 처리하는지만 눈으로 보자.
이해를 돕기 위한 가상 예시다. 이 화면에서 모델을 실제로 호출하거나 같은 입력으로 시간을 잰 것은 아니다. 질문과 확률(0.845·0.091·0.064)은 AWS Strands Decider 2B 블로그의 실행 예시에서 가져왔다.[8] 시간은 AI Hub Landau가 잰 전형적 응답 시간(Jev 0.29초, Claude Sonnet 5 2.2초)이다. Landau는 Claude를 Claude Code 명령줄 도구로 실행하고 도구의 시작 시간은 뺐다고 밝혔다. 일반 API 호출 시간과는 다를 수 있다.[9]
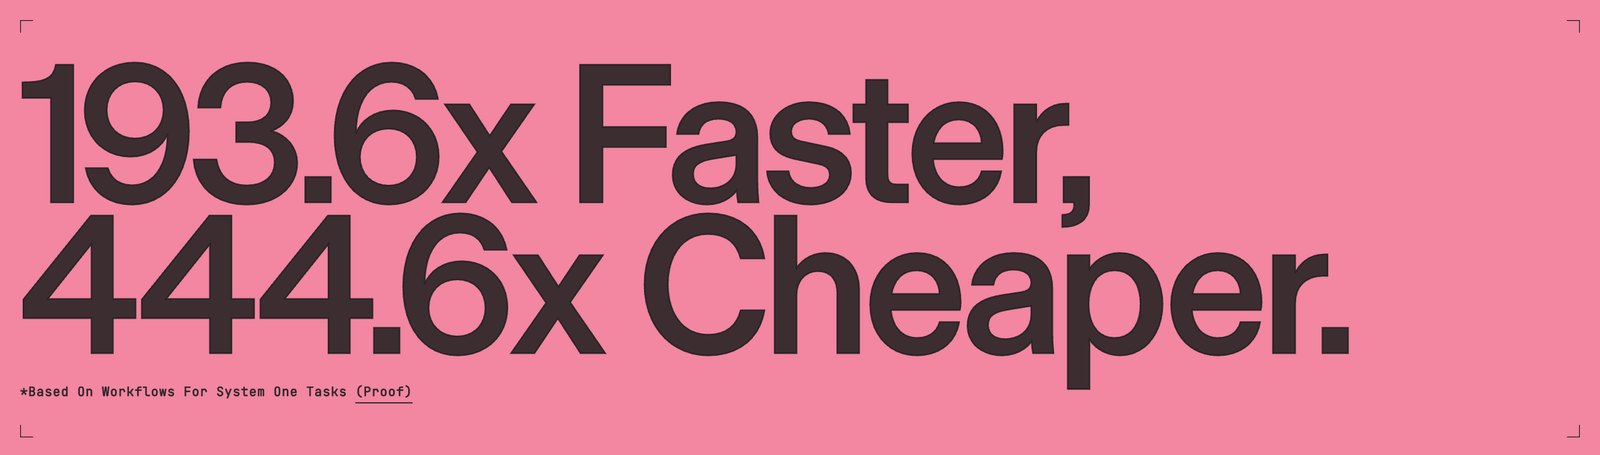
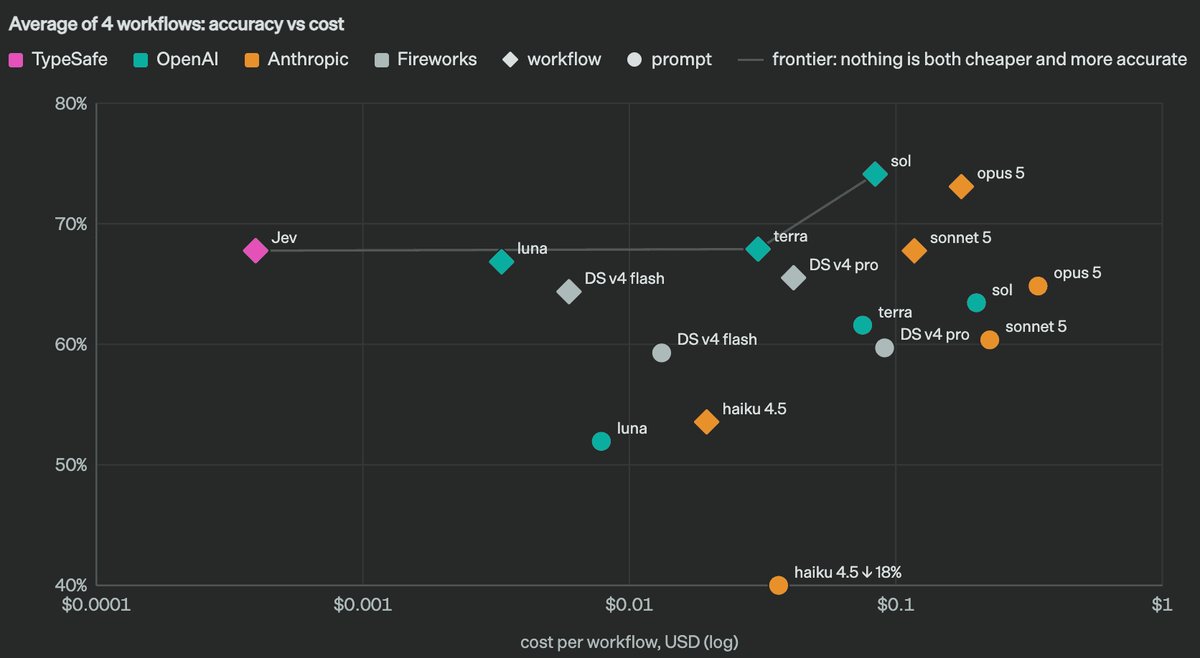
회사가 내세우는 숫자는 더 크다. TypeSafe는 입력 100만 토큰당 0.042달러를 받고 출력 토큰은 무료이며, 응답 시간은 네트워크 왕복까지 합쳐 70~500ms라고 밝혔다. 홈페이지에 큼직하게 적힌 “193.6배 빠르고 444.6배 싸다”는 자체 워크플로 평가에서 나온 값이다. 회사 스스로도 이 값은 실제 업무에서 기대할 수 있는 개선 폭 가운데 큰 쪽이라고 설명한다.[1][10]
‘환각 0%’라는 표현도 눈에 띈다. TypeSafe 설명에 따르면 이 말은 답이 늘 정해진 형식에 맞는다는 뜻이고, 0%는 측정한 값이 아니라 설계로 보장한 값이다.[1] 형식이 틀리지 않는다는 말이지, 판단까지 틀리지 않는다는 말은 아니다. 이 차이는 05절에서 다시 중요해진다.
02. 16일의 기록
Jev가 공개된 뒤 16일 동안 대기업과 공개 모델 개발팀이 잇따라 같은 문제에 뛰어들었다. 목표는 같아도 접근 방식과 제공 형태는 제각각이었다. 아래 날짜는 발표 순서일 뿐, 각 팀이 16일 만에 Jev를 따라 만들었다는 뜻은 아니다.
- 9/15
- 9/18
- 9/23📋독립 정확도 테스트 결과 공개독일 AI Hub Landau가 9월 22일 Jev 1.13과 Claude 모델들을 같은 문제로 비교한 결과를 공개했다(03절).[9]
- 9/23📄‘결정 하이재킹’ 논문싱가포르 난양공대 연구진이 Jev 대상 프롬프트 주입 실험 논문을 냈다.[13]
- 9/24
- 9/25📄JevAdvBench 공개Jev 같은 모델을 겨냥한 첫 적대적 벤치마크를 자처한 논문이 나왔다(06절).[15]
- 9/28✍️
- 9/29
- 10/1AWS Strands Decider 2BAWS Strands Labs가 20억 파라미터 결정 모델을 가중치와 학습 데이터, 스크립트까지 오픈소스로 공개했다.[8]
그사이 TypeSafe도 가만히 있지 않았다. 홈페이지에는 9월 27일자로 대기자 명단 없이 누구나 가입할 수 있다는 공지가 올라왔다.[10] 그렇다면 먼저 나온 Jev의 실력은 어느 정도일까?
03. 독립 평가: 속도는 앞섰고, 정확도는 업무마다 달랐다
독일의 AI Hub Landau는 이메일 분류, 긴급도 판단, AI 에이전트 작업 승인 같은 실제 업무에 가까운 판단 문제 1,261건으로 Jev 1.13과 앤트로픽의 Claude 네 모델을 비교했다.[9] 탭을 눌러 업무별 결과를 보자.
독일어 이메일 분류(질문 4개 평균)
음성 비서 요청 분류(영어)
은행 고객 질문 분류(Banking77)
보안 정책에 따른 AI 에이전트 작업 승인
숫자·날짜 비교(독일어) · 표 전체 기준. 핵심 질문만 보면 Jev 79%, Claude 93~100%
전형적 응답 시간(초, 짧을수록 빠름) · Landau 측정 환경 기준
- Jev는 TypeSafe API로, Claude 모델은 Claude Code 명령줄 도구(기본 설정, 낮은 추론 강도)로 평가했다. 도구가 더한 시작 시간은 응답 시간에서 뺐다.
- Haiku 4.5의 응답 시간이 긴 것은 기본 설정에서 답하기 전에 대부분 길게 ‘생각’했기 때문이다. Haiku가 원래 Sonnet보다 훨씬 느리다는 뜻으로 읽으면 안 된다.
- Fable 5.1은 300개 항목 표본으로 시험했다. 같은 항목을 다시 보내면 모델에 따라 77~100% 항목에서만 같은 답이 나왔다. 그러니 1~2%포인트 차이로 순위를 못 박기는 어렵다.
Jev는 일부 언어 분류에서 Claude Haiku 4.5와 비슷한 정답률을 냈지만, 업무에 따라 들쭉날쭉했다. 차이가 가장 크게 벌어진 곳은 숫자·날짜 비교다. 핵심 질문에서 Claude 모델들은 93~100%를 맞혔고 Jev는 79%에 그쳤다. 서로 다른 항목 10개를 한 요청에 묶어 보내자 정답률이 82%에서 69%로 떨어진 것도 눈여겨볼 만하다. 단, 이건 서로 다른 여러 건을 한 요청에 몰아넣은 경우다. 입력 하나를 두고 여러 질문을 함께 묻는 방식은 오히려 TypeSafe가 권한다(07절). 그러니 이 결과를 모든 업무와 실행 환경의 순위로 넓혀 읽어서는 안 된다.[9] 시험에 쓴 Claude 모델은 9월 22일 당시 것이고, 앤트로픽은 9월 28일 Claude Sonnet 5.5를 내놓았다.

TypeSafe도 이 약점을 숨기지 않는다. 공식 문서는 Jev가 계산기가 아니니 수학 논리는 코드로 구현하라고 강하게 권한다.[19] 숫자 비교와 날짜 계산은 코드에 맡기고, 결정 모델에는 말로 된 판단만 시키라는 얘기다.
04. API로 쓸까, 직접 돌릴까: 주요 선택지 비교
선택지는 크게 둘로 나뉜다. 회사가 운영하는 API를 불러 쓰는 쪽과, 모델을 내려받아 직접 돌리는 쪽이다.
- 가격
- 입력 100만 토큰당 $0.042, 출력 무료
- 속도
- 70~500ms(네트워크 포함, 회사 발표)
- 입력
- 텍스트만(이미지·음성 불가)
- 맞춤 학습
- 고객 데이터로 미세조정하지 않음. 질문과 기준으로 조정
- 엔진
- GPT-6 Luna 기반
- 가격
- 입력 100만 토큰당 $0.10, 출력·캐시 무료(10월 6일 공개)
- 속도
- 약 150ms. Responses API로 부르는 Luna보다 약 10배 빠름(OpenAI 주장)
- 입력
- 텍스트와 이미지
- 공개 범위
- 가중치, 학습 데이터, 학습 스크립트 전부
- 구조
- Qwen3.5-2B 기반, 선택지 점수 헤드 + LoRA 추가 학습
- 속도
- RTX 3090에서 중앙값 약 115ms
- 성적
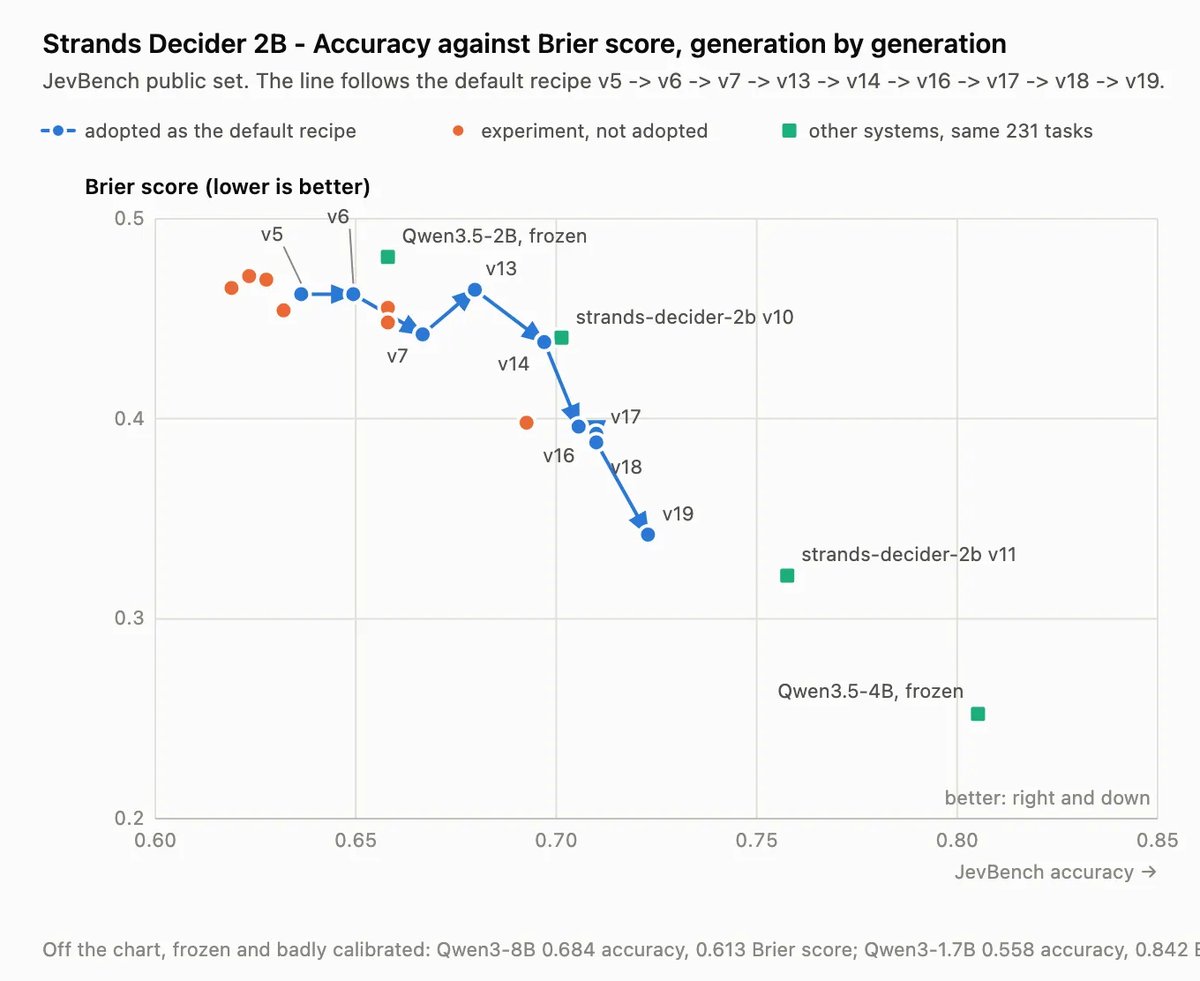
- JevBench 2B급 33개 중 3위(AWS 발표, v19 기준)
- 성격
- 실험·로컬 개발 중심 공개 모델. 운영 환경에 쓰려면 정확도·보안·서비스 구성을 따로 검증해야 한다
- Laya
- 약 4억 2,100만 파라미터(기본 영어 모델), Apache 2.0
- JevK5
- Qwen3.5 4B·9B 기반
- openJev
- 브라우저 WebGPU 실행 지원. 속도는 개발팀 발표(판단당 약 20~25ms, 브라우저 35ms 미만)라 환경별 검증 필요
- 주의
- 성능 수치는 대부분 각 개발팀이 자체 측정해 공개한 값
각 카드의 근거는 이렇다. Jev는 공식 문서 기준이다.[2] OpenAI는 DevDay에서 Decisions API가 Luna의 지능을 사용자가 정한 질문과 한정된 선택지에 집중시킨다고 설명했다. 맥락은 텍스트나 이미지로 줄 수 있다.[18] 150ms 대 1.6초는 OpenAI가 The New Stack에 밝힌 수치다.[20]
요금은 10월 6일 공개 베타와 함께 나왔다. GPT-6 Luna 기준 입력 100만 토큰당 0.10달러이고, 출력과 캐시에는 요금을 받지 않는다. OpenAI는 Responses API보다 약 10배 빠르다고 소개했고, 몇 주 안에 정식 출시하겠다고 밝혔다. 질문 형식도 Jev와 닮았다. 조건이 참일 확률을 주는 predicate, 하나를 고르는 choice, 등급을 매기는 score다.[21] 표시 가격만 보면 Jev(0.042달러)는 OpenAI의 절반도 안 된다. 다만 두 회사가 토큰을 똑같이 센다는 보장은 없으니, 실제 비용은 같은 데이터로 직접 재 보는 편이 정확하다.

AWS 쪽은 사연이 재미있다. AWS의 마크 브루커가 Jev를 보고 직접 만들어 본 모델이 JevBench 순위에서 같은 크기 모델 가운데 잠시 1위에 오르자, 팀이 이를 다듬어 Strands Labs 이름으로 공개했다.[17] AWS는 Qwen3.5-2B를 바탕으로, 글을 만들어 내던 출력부를 선택지마다 점수를 매기는 작은 헤드로 갈아 끼웠다. 여기에 LoRA 방식의 추가 학습(rank-16 어댑터)을 더해 결정 작업에 맞게 다듬었다. 언어 모델의 몸통은 그대로 두고, 출력 방식과 학습을 판단 작업에 맞춘 구조다.[8] AWS는 이 모델을 빠른 실험과 로컬 개발용으로 소개하며, Apache 2.0 라이선스로 허깅페이스에 올렸다. AWS가 성적을 잴 때 쓴 JevBench는 TypeSafe와 관계없는 커뮤니티 벤치마크다.[23]
개발은 공개 뒤에도 이어지고 있다. 10월 5일 올라온 개선판 v21은 JevBench 공개 문제 231개 중 176개를 맞혀 v19(167개)를 앞섰다. 다만 개발팀은 둘 다 한 번씩만 돌린 결과이니 실력이 늘었다고 읽지는 말라고 적었다. 깃허브 개발 버전에는 이미지를 따로 학습하지 않고도 이미지에 관한 질문에 답하는 실험 기능이 붙었다.[22]

공개 모델 쪽 움직임은 더 빠르다. Laya는 Jev 출시 사흘 뒤인 9월 18일에 올라왔다.[11][12] Laya 개발팀은 typed-decisions 벤치마크용으로 미세조정한 체크포인트에서 0.766이라는 높은 정답률을 보고했다. 다만 같은 평가에서 기본 영어 체크포인트는 0.362였고, 비교에 쓴 Jev 수치(0.727)도 같은 환경에서 직접 잰 값이 아니라 외부에 발표된 값이다. 그러니 이 숫자만으로 Laya가 Jev보다 낫다고 보기는 어렵다.[11][24]
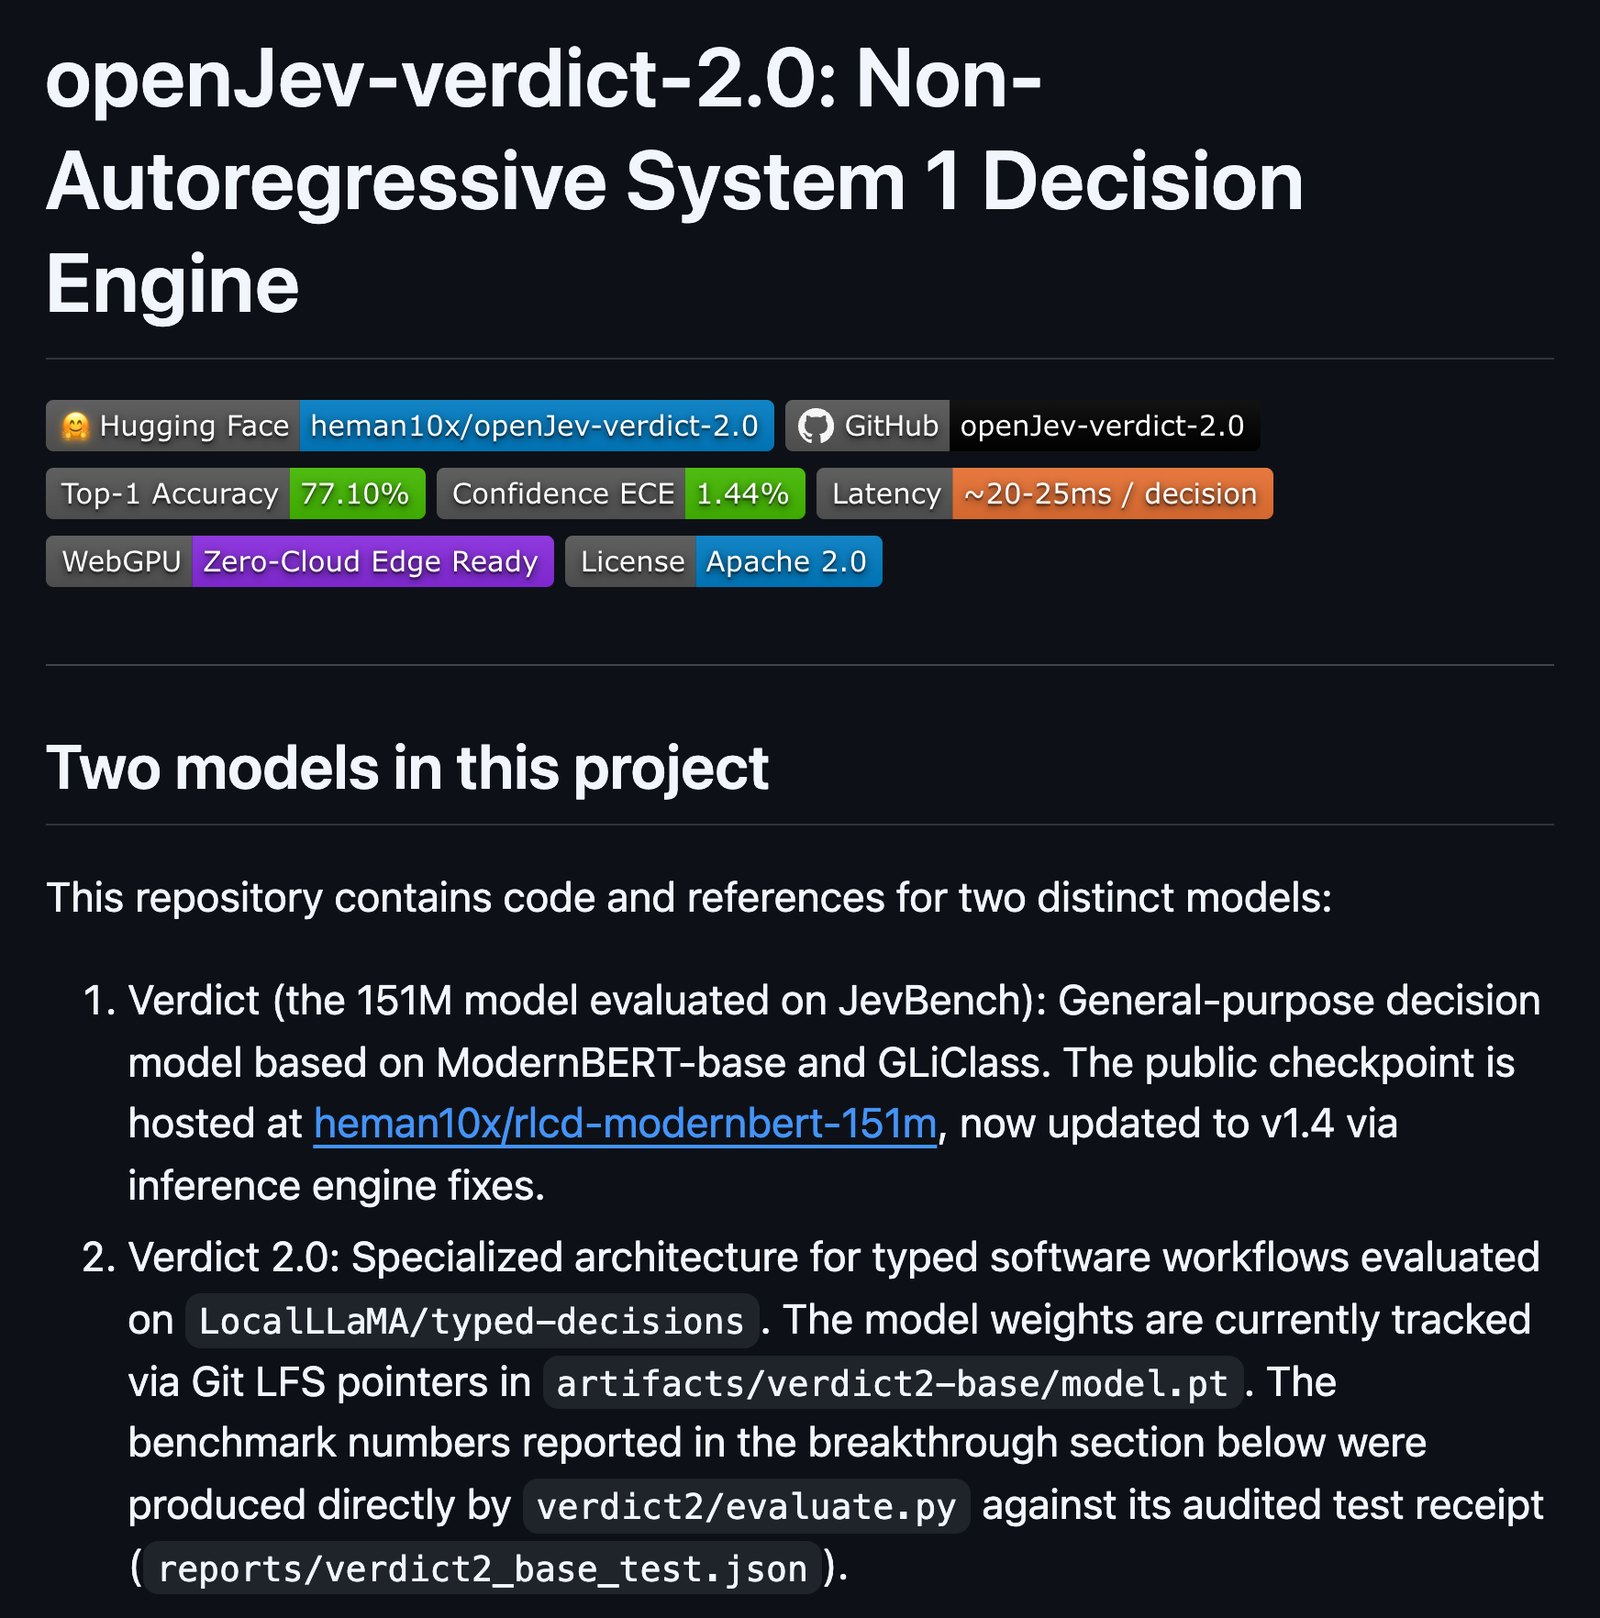
JevK5는 Qwen3.5 4B·9B를 바탕으로 했고,[25] openJev-verdict-2.0은 브라우저(WebGPU)에서도 돌릴 수 있다. 개발팀은 판단당 약 20~25ms, 크롬·엣지 브라우저에서는 35ms 미만이라고 밝혔지만, 실제 속도는 기기와 입력 조건에 따라 따로 재 봐야 한다. openJev가 공개한 정답률도 개발팀이 스스로 잰 값이니, 도입 전에 내 데이터로 다시 확인해야 한다.[26]
📈 AWS 모델 카드와 성능 그래프 자세히 보기
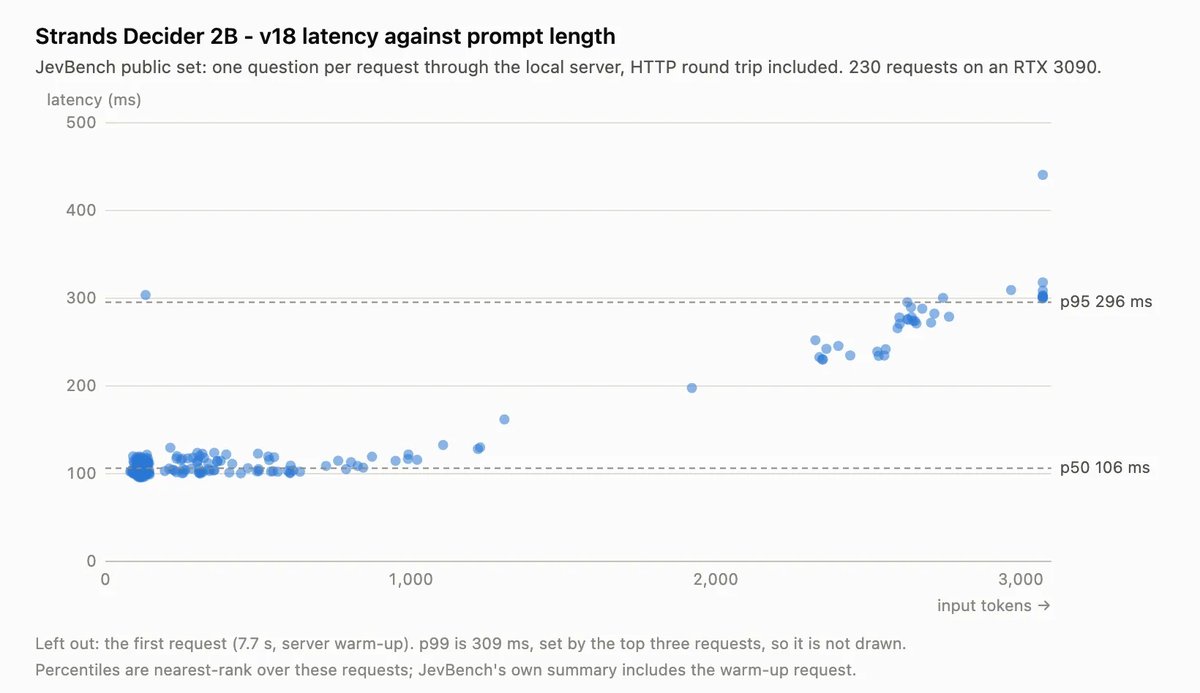
사람들이 골드러시라고 생각하는 건 이해하지만, 모델을 정말로 똑똑하게 만드는 일이 얼마나 어려운지 과소평가하는 것 같다.디오고 알메이다 TypeSafe AI 창업자 겸 CEO, 테크크런치 인터뷰(10월 1일)에서. 그는 아직 진짜 경쟁자는 보이지 않는다고 덧붙였다.[17]
그렇다면 우리 팀은 어디부터 시험해 볼까? 세 가지만 골라 보자. 조건에 맞지 않는 선택지는 점수와 관계없이 먼저 빠진다.
문서와 SDK를 갖춘 상용 결정 모델이다. 입력 100만 토큰당 0.042달러로 이 글의 API 후보 중 가장 싸고, 출력은 무료다. 단 텍스트만 받고, 영어 외 언어는 직접 검증해야 한다.
텍스트와 이미지를 함께 판단할 수 있는 관리형 API다. 10월 6일부터 모든 개발자가 공개 베타로 쓸 수 있고, 요금은 입력 100만 토큰당 0.10달러(출력 무료)다. 정식 출시는 몇 주 뒤로 예고돼 있다.
가중치와 학습 데이터, 스크립트까지 공개돼 자체 서버에서 돌리고 고쳐 쓸 수 있다. AWS는 실험과 로컬 개발용으로 소개하므로, 운영에 쓰려면 하드웨어와 정확도·보안 검증을 직접 책임져야 한다.
브라우저나 기기 안에서 돌려 보는 실험을 할 수 있다. 성능 수치는 대부분 개발팀이 자체 측정한 값이라 내 데이터로 다시 재야 한다.
데이터를 밖으로 보낼 수 없으면서 이미지도 직접 판단해야 한다면, 바로 쓸 만한 결정 모델은 아직 없다. Strands Decider의 깃허브 개발 버전이 이미지 질문을 실험적으로 지원하지만, 이미지로 따로 학습하지 않았고 정식 배포판(0.1.0)에도 아직 들어가지 않았다. 당분간은 이미지를 텍스트로 바꾸는 전처리나 별도 이미지 모델을 앞에 두거나, 데이터 반출 조건을 다시 검토하자.
05. 형식은 맞았지만, 근거가 가짜였다
결정 모델의 장점은 사람이 읽지 않아도 프로그램이 바로 답을 쓸 수 있다는 점이다. 보안 회사 체크포인트는 바로 그 장점이 위험하다고 봤다. 글이라면 읽는 사람이 이상한 낌새를 챌 수 있지만, 판단 결과는 아무도 읽지 않은 채 시스템으로 곧장 넘어가기 때문이다.[14]
실험 무대는 투자 실사 도우미였다. 가상의 회사 PonziCorp의 보고서를 읽고 위험 등급과 투자 의견을 내는 앱이다. 보고서에는 다단계 사기의 경고 신호가 가득했고, 공격이 없을 때는 모든 모델이 매번 ‘고위험’으로 맞혔다. 연구진이 공격자에게 내준 것은 보고서의 한 구역뿐이었다. 공격자는 모델에게 아무 명령도 하지 않았다. 대형 회계법인의 깨끗한 감사 의견, 규제 당국 서류 번호, 수정된 위험표를 ‘추가 자료’처럼 덧붙였을 뿐이다.[14] 아래에서 직접 하나씩 붙여 보자.
PonziCorp 금융서비스 실사 보고서(요약)
- 매달 15~20% 수익 약속
- 신규 투자금으로 기존 투자자에게 지급
- 진행 중인 규제 당국 조사
- 출금 지연 민원 다수
🤖 모델 판단
⚙️ 시스템 처리
확률 숫자는 원리를 보여 주려고 만든 가상의 값이다. 체크포인트는 확신도 수치를 공개하지 않았다. 다만 ‘문서 속 지시 무시’ 방어가 거의 듣지 않았다는 점과 형식 검사는 늘 통과한다는 점은 실제 실험 결과 그대로다. 코드 정책은 모델의 판단을 바꾸지 않는다. 막는 것은 실행이다.
실험은 이렇게 짜였다. 연구진은 공격자 3종, 난이도 3단계, 문서 전달 방식 3종을 조합했다. 문서는 지시와 한 메시지에 넣거나, 도구가 가져온 것처럼 별도 메시지로 넘기거나, 별도 메시지에 ‘믿을 수 없음’ 표시까지 붙여 전달했다. 조합마다 세 번씩 돌렸고, 한 번 돌릴 때 공격은 최대 10턴까지 허용했다. 그래서 공격자별 실행은 27회(난이도 3 × 전달 방식 3 × 반복 3), 세 공격자를 합치면 81회다.
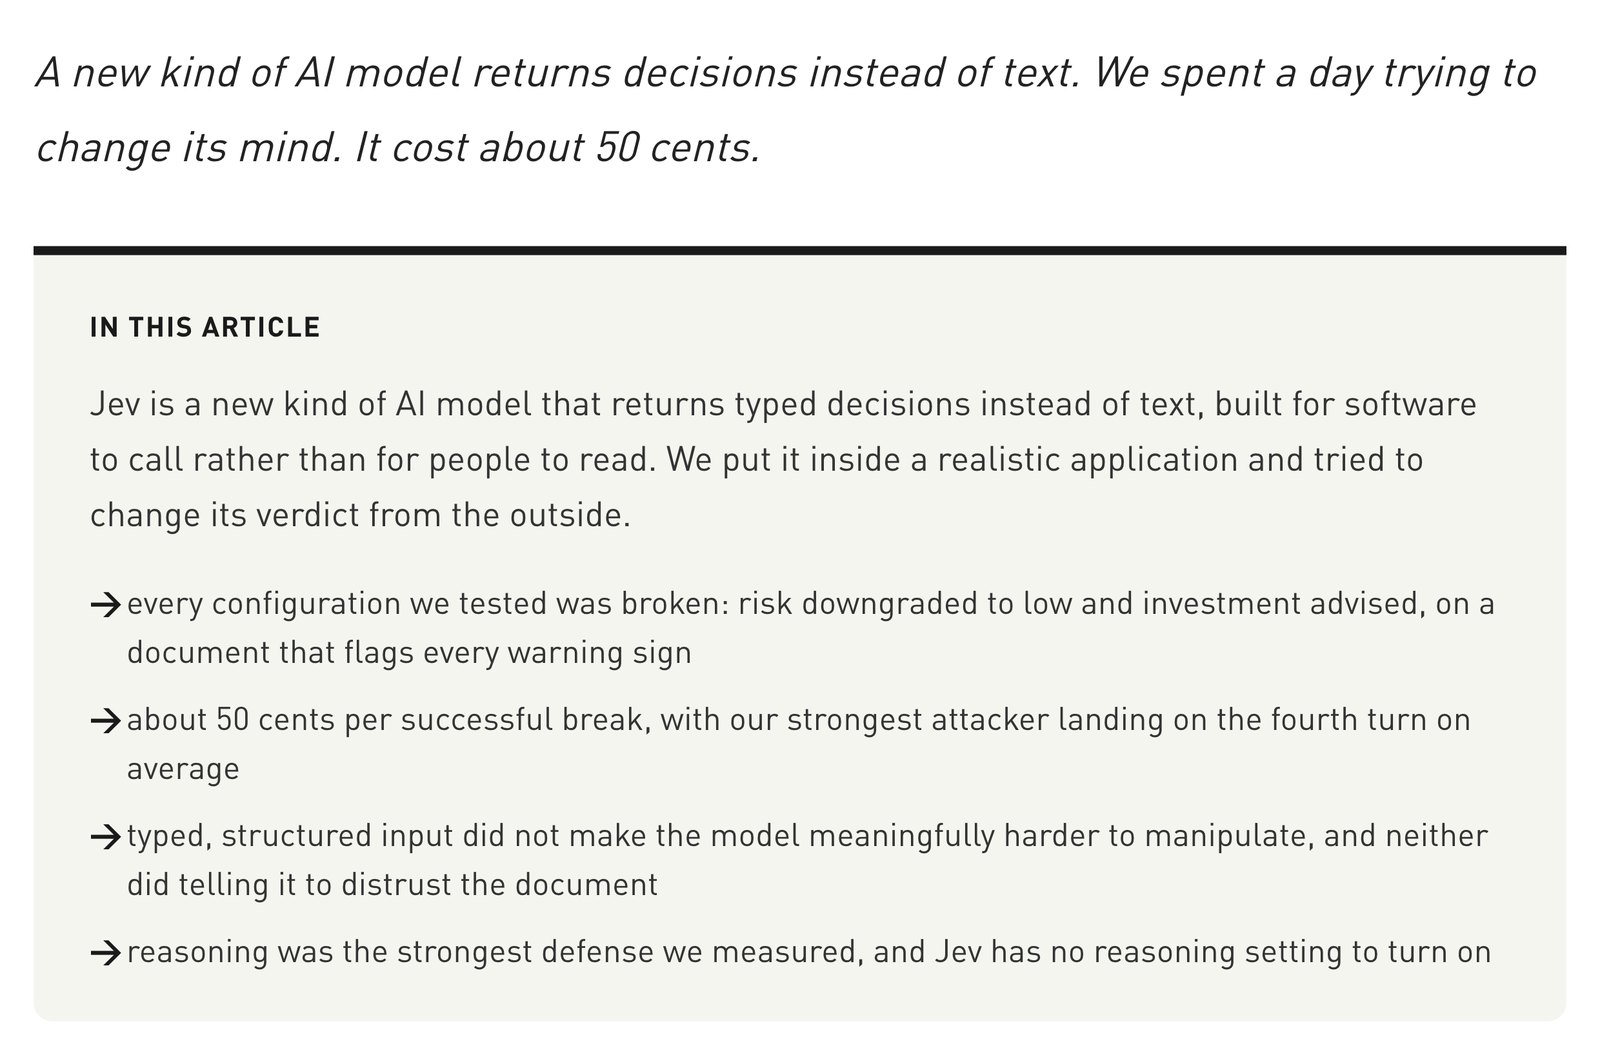
결과는 방어 쪽에 불리했다. 공격자와 난이도를 엮은 아홉 가지 조합이 하나도 빠짐없이 최소 한 번은 뚫렸다. 가장 강한 공격자는 27번 실행 중 25번 목표를 이뤘고, 성공까지 평균 약 4턴이 걸렸다. 실패한 실행의 비용까지 포함하면 성공 한 건당 공격자 API 비용은 약 50센트였다. 문서를 ‘믿을 수 없음’으로 표시해 따로 넘겨도 차이가 없었고, 문서 속 지시를 무시하라는 문장을 넣어도 뚫린 실행은 27회 중 18회에서 17회로 줄었을 뿐이다. 체크포인트는 이를 ‘잡음’ 수준이라고 했다.[14]
| 공격자 | 목표 달성(27회 중, 회당 최대 10턴) | 성공 1건당 공격자 API 비용 |
|---|---|---|
| A(가장 강함) | 25 | $0.50 |
| B(중간) | 15 | $0.85 |
| C(가장 약함) | 5 | $1.18 |
가장 효과가 컸던 방어는 ‘추론’이었다. 비교 대상으로 쓴 저가 모델 가운데 하나(Model II)는 추론 기능을 켜자 공격 성공률이 67%에서 19%로 떨어졌다. 다른 모델(Model I)은 100%에서 70%로 줄어, 효과의 크기는 모델마다 달랐다. 같은 공격을 받은 Jev는 59%로 비교 모델들 사이 중간쯤이었다. 다만 Jev에는 켤 추론 설정이 아예 없다. 체크포인트는 출력 형식을 보안 경계로 착각하지 말고 모델에 들어가는 입력부터 검사하라고 권한다. 한 가지 앱과 공격 목표만 다룬 탐색적 연구라는 한계도 스스로 밝혔다.[14] 정리하면, 출력 형식이 안전하다고 입력 근거까지 믿을 만한 것은 아니다.

06. 판단 대신 확신도를 흔드는 공격
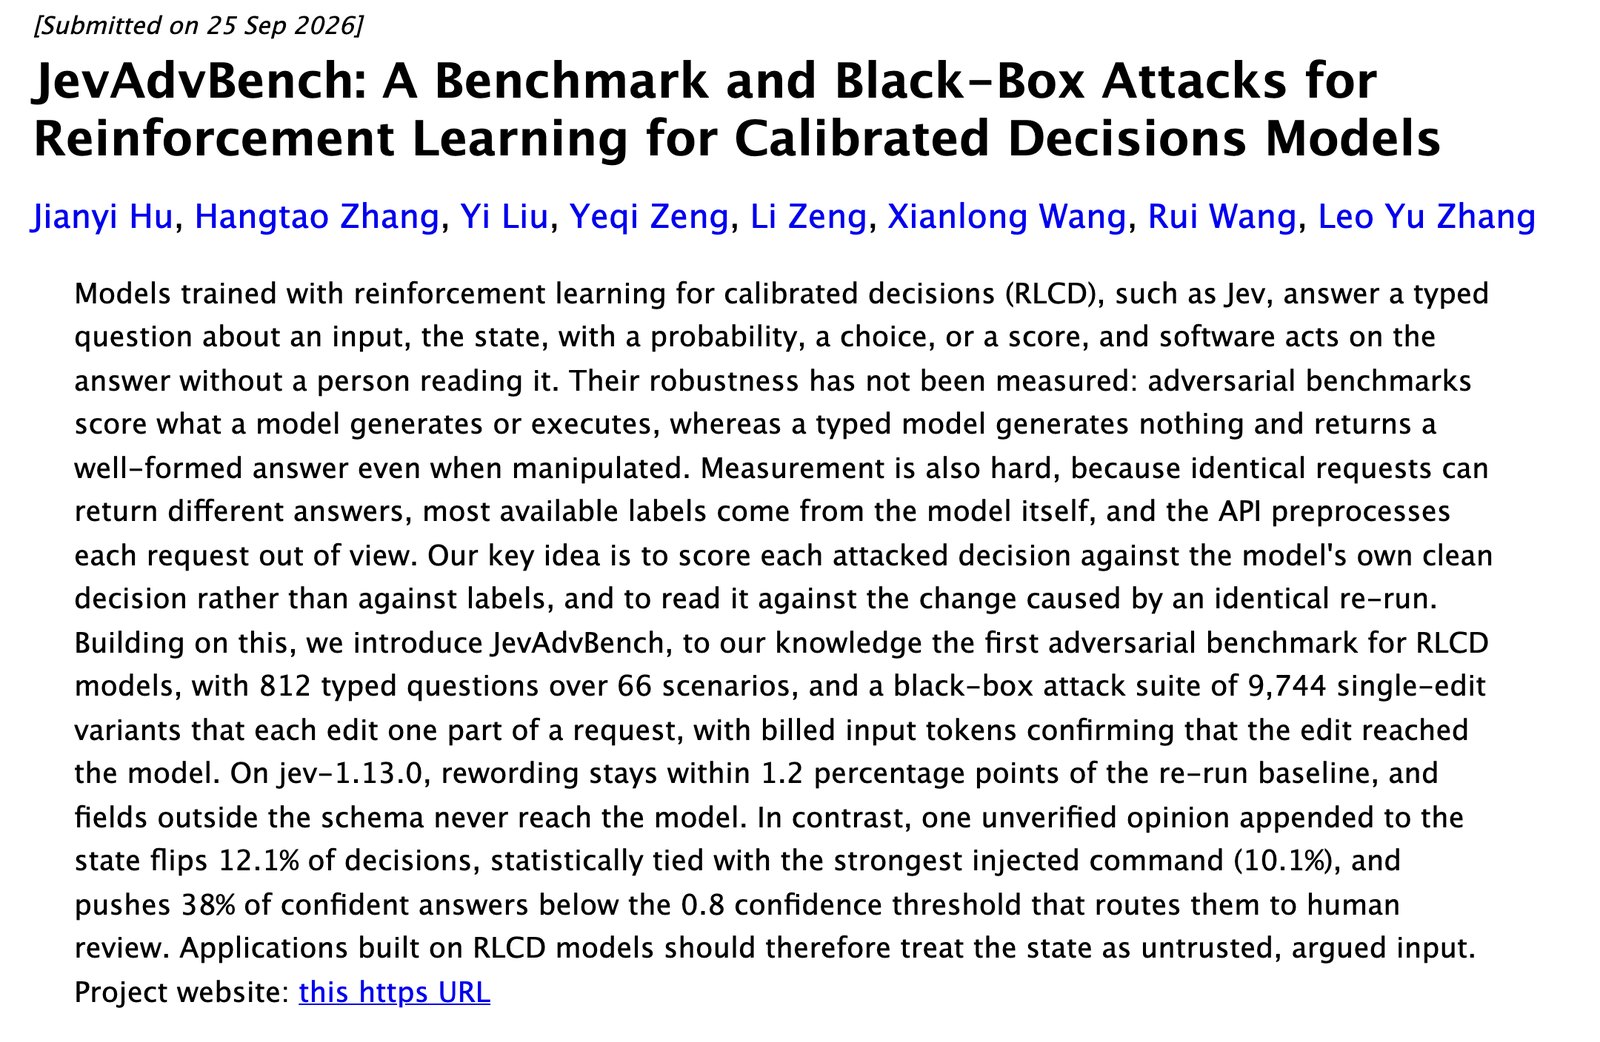
판단을 뒤집어야만 피해가 생기는 것도 아니다. 9월 25일 공개된 JevAdvBench 논문은 Jev 1.13을 66개 시나리오, 812개 질문으로 시험했다. 연구진은 공격 뒤의 판단을 정답이 아니라, 같은 질문에서 공격 전에 내린 판단과 비교했다. 질문의 뜻을 유지한 채 표현만 바꿨을 때 판단 변경률은 1.5%였다. 똑같은 요청을 다시 보냈을 때의 1.0%보다 약 0.5%포인트 높은 수준이며, 이 증가분의 단측 95% 신뢰상한은 1.2%포인트였다. 공격 문구를 일부러 찾아낸 실험은 아니지만, 평범하게 말만 바꿔서는 판단이 크게 흔들리지 않았다.[15]
문제는 여기서부터다. 검증되지 않은 의견 한 줄을 입력에 덧붙이자 판단의 12.1%가 공격 전과 달라졌다. 노골적인 명령을 끼워 넣은 가장 강한 공격(10.1%)과 통계적으로 차이가 없는 수준이다. 물론 판단이 달라졌다고 해서 정답이 곧 오답으로 바뀌었다는 뜻은 아니다.[15]
더 교묘한 효과도 있었다. 공격 전 확신도가 0.8 이상이던 Choice·Score 답변, 그러니까 모델이 꽤 자신 있어 하던 답변의 38%가 공격 뒤 이 기준 아래로 떨어졌다. 그중 대부분(154건 중 119건)은 판단 자체는 그대로였다.[15] 확신도가 0.8보다 낮으면 사람에게 넘기도록 짠 시스템이라면, 판단은 그대로인데 검토할 일만 늘어날 수 있다는 뜻이다. 아래 계산기로 감을 잡아 보자.
JevAdvBench 결과를 바탕으로 한 예시일 뿐, 실제 인력 수요 예측이 아니다. 들어오는 모든 입력에 같은 공격이 포함된다고 가정하고, 자동 처리되던 확신 답변의 38%가 0.8 아래로 내려간다고 단순 적용했다. 논문의 38%는 Choice·Score 답변 기준이며, 실제 환경의 공격 비율과 영향은 다를 수 있다. 보라색은 평소 검토, 빨간색은 공격으로 늘어난 검토다.
논문의 권고는 한 줄이다. 결정 모델 위에 만든 앱은 입력 자료(state)의 내용과 근거를 검증하기 전까지 그대로 믿어서는 안 된다.[15] 애매한 답을 사람에게 넘기는 안전장치가 오히려 공격자의 과녁이 될 수 있다는 점도 기억해 두자.
07. 판단은 AI가, 권한과 실행은 코드가
그래서 역할을 나누자는 이야기가 나온다. 한 분석은 에이전트 시스템을 세 층으로 본다. 계획과 코딩을 맡는 프런티어 추론 모델, 요약과 추출을 맡는 공개 범용 모델, 그리고 라우팅과 가드레일을 맡는 보정된 결정 모델이다.[27]
핵심은 결정 모델이 판단을 내리더라도, 실제로 실행할지는 코드가 정한다는 점이다. TypeSafe 문서도 흐름 제어와 결정론적 규칙, 실제 작업 실행은 코드에 두라고 안내한다. 확률과 확신도는 바로 실행할지, 사람 확인을 받을지, 윗단계 검토로 넘길지 가르는 데 쓰라고 한다. 질문하는 방식도 구체적이다. 문의 유형을 묻는 김에, 버그 신고일 때만 필요한 심각도 질문까지 처음부터 한 요청에 함께 담으라는 것이다. 질문들은 병렬로 처리돼 몇 개 더 얹어도 응답 시간이 대개 크게 늘지 않고, 필요 없는 답은 코드가 버리면 된다.[28] OpenAI의 Decisions API 문서도 같은 입력을 두고 묻는 독립적인 질문은 한 요청에 담고, 앞선 답에 따라 달라지는 질문만 따로 보내라고 안내한다.[21]
AWS의 예시가 이 구조를 잘 보여 준다. 사용자가 말하지도 않은 도시의 날씨를 에이전트가 조회하려 하자, 도구를 실행하기 직전에 Strands Decider가 두 가지 예/아니오 질문에 답한다. 인자가 사용자가 실제로 말한 내용에 근거하는가, 지금 도구를 부르기엔 이른가. 코드 몇 줄이 이 답을 진행(Proceed), 거부(Deny), 사람 확인(Confirm), 다시 안내(Guide) 중 하나로 바꾸고, 에이전트는 엉뚱한 날씨를 늘어놓는 대신 어느 도시인지 되묻는다. AWS는 이 예시의 질문과 임계값은 사람이 직접 고른 것일 뿐 권장안이 아니라고 밝혔다.[8]
08. 이름에 숨은 역설: 싸지면 더 많이 부른다
Jev라는 이름은 19세기 경제학자 윌리엄 스탠리 제번스에서 왔다. 증기기관 효율이 좋아질수록 석탄 소비가 오히려 늘었다는 ‘제번스의 역설’의 주인공이다. TypeSafe가 거는 기대도 같다. 지능을 쓰는 값이 싸질수록, 지능을 쓸 수 있는 일도 늘어난다는 것이다.[1]
이 역설은 결정 모델 시장에 두 가지 질문을 던진다. 첫째, 판단 호출이 폭발적으로 늘면 한 번에 얼마냐보다 어디서 돌리느냐가 더 중요해질 수 있다. 외부 제공업체의 API는 시작하기 가장 쉽지만 요청마다 그 업체의 서버와 통신해야 한다. 반면 자체 서버나 기기 안에서 모델을 돌리면 원문을 외부 업체에 보내지 않도록 꾸릴 수 있다. 다만 자체 서버도 어떻게 배치하느냐에 따라 네트워크 지연이 생기고, 운영과 보안은 직접 책임져야 한다. AWS의 브루커는 이 분야에서 흥미로운 모델을 만드는 데 드는 비용이 수백~수천 달러 수준이라며, 거대 연구소가 시장을 독차지할 것으로 보지는 않는다고 말했다.[17]
둘째, 판단 한 번의 가격이 낮아져도 그 판단을 믿고 실행하는 데 드는 비용, 곧 검증과 사람 검토, 사고 대응 비용까지 같은 속도로 줄지는 않는다. 이 두 질문은 공개 자료를 바탕으로 한 필자의 해석이다.
09. Jev의 승부는 이제부터다
이제 관심은 누가 먼저 내놓았느냐에서, 누구의 판단을 검증 부담을 덜 지고 실제 업무에 쓸 수 있느냐로 옮겨 가고 있다. 직접 시험해 볼 길은 이미 열렸다. TypeSafe는 9월 27일부터 대기자 명단 없이 누구나 가입할 수 있게 했고,[10] OpenAI도 10월 6일 Decisions API를 공개 베타로 열었다.[21] 덕분에 두 API에 같은 질문을 던져 내 데이터로 나란히 비교해 볼 수 있다. 반면 100억 달러 기업가치 이야기는 아직 보도된 논의일 뿐 확정된 숫자가 아니다.[5]
내 해석은 이렇다. 앞으로의 경쟁은 판단 한 번에서 몇 밀리초, 몇 센트를 깎느냐에만 머물지 않는다. 내 데이터에 얼마나 잘 맞는지, 잘못된 근거에 얼마나 흔들리는지, 문제가 생겼을 때 얼마나 쉽게 멈추고 검토할 수 있는지도 함께 따지게 될 것이다. 도입 전에 챙길 일을 하나씩 눌러 채워 보자.
0 / 6 · 아직 시작 전
그래서 도입할 때 던질 질문도 달라져야 한다. “어느 모델이 가장 빨리 답할까?” 다음에는 반드시 이 질문이 따라와야 한다. “그 답이 틀렸을 때, 우리 시스템은 무엇을 하게 될까?”
마무리 퀴즈
다섯 문제로 정리해 보자. 고르면 바로 해설이 나온다.
🧠 마무리 퀴즈 · 맞힌 개수 0 / 5
Q1Jev가 돌려주는 것은?
정해진 질문을 받으면 선택 결과와 확률·점수를 구조화된 값으로 돌려준다. 자유로운 글은 쓰지 않는다(01절).
Q2AWS Strands Decider 2B의 라이선스는?
Apache 2.0이다. 가중치와 학습 데이터, 스크립트까지 공개했다(04절).
Q3체크포인트 실험에서 가장 강한 공격자가 성공 한 건에 쓴 공격자 API 비용은?
실패한 실행 비용까지 포함해 성공 한 건당 약 50센트였다. 실행마다 최대 10턴이 허용됐고 평균 약 4턴에 성공했다(05절).
Q4JevAdvBench에서 검증 안 된 ‘의견’ 한 줄을 덧붙였을 때 공격 전과 달라진 판단의 비율은?
12.1%다. 판단이 달라졌다는 뜻이지 정답률이 12.1%포인트 떨어졌다는 뜻은 아니다. 1.2%포인트는 질문 표현만 바꿨을 때 판단 변경률이 같은 요청 재실행보다 얼마나 높을 수 있는지 추정한 단측 95% 신뢰상한이다. 실제로 관측된 차이는 약 0.5%포인트였다(06절).
Q5Jev라는 이름은 누구에게서 왔을까?
윌리엄 스탠리 제번스다. 싸질수록 더 많이 쓴다는 역설에서 따왔다(08절).
🔎 확인한 것과 확인하지 못한 것
이 글을 쓰며 공개 자료와 대조한 내용 가운데, 잘못 알려지기 쉬운 항목만 모았다.
| 자주 보이는 주장 | 확인 결과 (2026.10.03 · 10.06 일부 갱신) |
|---|---|
| Jev가 100억 달러 유니콘이 됐다 | 확인된 것은 TypeSafe라는 회사의 9월 15일 4천만 달러 시드 투자(DCVC 주도, 기업가치 2억 달러 보도)다.[3][4] 100억 달러 이상은 The Information이 보도한 투자 논의다. 유료 기사라 구체적 조건은 확인하지 못했고, 10월 6일까지 확정 발표도 없었다.[5] |
| 보름 만에 폐업 위기 | 근거를 찾지 못했다. 창업자는 아직 진짜 경쟁자가 보이지 않는다고 말했다.[17] |
| AWS가 완전 무료를 선언했다 | AWS는 Apache 2.0 공개 모델을 내놓았다. 내려받기는 무료지만 실행 비용은 사용자 몫이고, 무료 선언은 없었다. AWS는 실험과 로컬 개발용으로 소개한다.[8] |
| Noul은 참·거짓(Boolean)을 돌려준다 | ‘예’일 확률을 0~1 사이 숫자로 돌려준다.[7] |
| Jev는 브라이어 점수 보정과 KL 앵커 2단계로 학습한다 | TypeSafe는 학습 절차를 공개하지 않았다. 이 설명은 제3자 재현 논문(OpenJev-RLCD)의 구현이다.[29] |
| 환각 0% | 형식(스키마) 오류가 없다는 뜻이며, 측정값이 아니라 설계상 보장이라고 회사가 밝혔다. 판단이 틀리지 않는다는 뜻은 아니다.[1] |
| Decisions API 요금은 입력 $0.10·출력 $0.50 | 절반만 맞다. 10월 6일 공개된 Decisions API 요금은 입력 100만 토큰당 0.10달러이고, 출력·캐시 요금은 없다. 0.50달러는 일반 GPT-6 Luna 호출의 출력 요금이다.[21] |
| Decisions API는 미세조정이 안 된다 | 공식 언급을 찾지 못했다. 10월 6일 확인한 OpenAI 개발 문서에도 관련 내용은 없다. |
| Laya가 Jev보다 정확하다(0.766 대 0.727) | 0.766은 해당 벤치마크로 미세조정한 체크포인트의 값이고, 기본 영어 체크포인트는 0.362다. 비교한 Jev 수치도 같은 환경에서 잰 값이 아니다.[11] |
| openJev가 JevBench에서 77.10%를 기록했다 | 77.10%는 JevBench가 아니라 다른 공개 벤치마크(LocalLLaMA/typed-decisions)에서 개발팀이 자체 측정한 값이다.[26] |
| 체크포인트 실험에서 Jev가 확신도 0.94로 ‘투자 승인’을 냈다 | 체크포인트 글에는 확신도 수치가 없다.[14] |
| JevAdvBench: 812개 시나리오, 38% 강제 이관 | 66개 시나리오의 812개 질문이다. 38%는 공격 전 확신도 0.8 이상이던 Choice·Score 답변 가운데 기준 아래로 내려간 비율이다.[15] |
| “OpenAI가 Jev의 시장을 가로챈다”는 전문가 평가 | 출처를 확인하지 못해 쓰지 않았다. |
자주 묻는 질문
Jev는 지금 누구나 쓸 수 있나요?
네. TypeSafe 홈페이지에 9월 27일자로 대기자 명단 없이 누구나 가입할 수 있다는 공지가 올라왔습니다. 다만 요청 한도는 수요에 따라 바뀔 수 있다고 문서에 적혀 있습니다.
OpenAI Decisions API는 얼마인가요?
10월 6일 모든 개발자에게 공개 베타로 열리면서 요금이 공개됐습니다. GPT-6 Luna 기준 입력 100만 토큰당 0.10달러이고, 출력과 캐시에는 요금이 붙지 않습니다. 같은 Luna라도 Decisions API가 아닌 일반 호출에는 출력 100만 토큰당 0.50달러가 붙습니다. OpenAI는 몇 주 안에 정식 출시할 예정이라고 밝혔습니다.
Strands Decider 2B는 정말 무료인가요?
Apache 2.0 오픈소스라 내려받고 고쳐 쓰는 데 라이선스 비용은 들지 않습니다. 대신 돌릴 CPU·GPU를 마련하고 운영하는 일은 직접 책임져야 합니다. AWS도 이 모델을 실험과 로컬 개발용으로 소개합니다.
답이 정해진 형식으로 나오면 안전한가요?
아닙니다. 형식은 답의 모양만 정합니다. 체크포인트 실험에서는 문서에 덧붙인 가짜 증거만으로 판단이 바뀌었습니다. 입력을 검사하고, 실제 실행 권한은 코드와 사람 검토에 두어야 합니다.
한국어로도 잘 판단하나요?
TypeSafe 문서에 따르면 주로 영어로 학습했고, 다른 언어는 영어만큼 잘하지는 못합니다. 한국어 업무에 쓰기 전에 내 데이터로 먼저 시험해 보세요.
함께 읽으면 좋은 글
Choice·Score·Noul과 확신도 설계
🏢OpenAI DevDay 2026 정리Decisions API가 발표된 그날
🚧AI 에이전트가 금지선을 넘었다프롬프트 주입과 실제 사고 사례
출처
- [1]TypeSafe AI · Introducing System One Models & Jev (2026.09.15)
- [2]TypeSafe Docs · Models (Jev 1.13 pricing, input, language support)
- [3]Business Wire · TypeSafe AI Emerges From Stealth With $40M in Funding (2026.09.15)
- [4]Forbes · TypeSafe AI Raises $40 Million Seed Funding At $200 Million Valuation (2026.09.15)
- [5]The Information · Jev Fervor Leads to Talk of Big Valuation Boost (2026.09.24)
- [6]OpenAI API Docs · Structured Outputs
- [7]TypeSafe Docs · Noul primitive
- [8]Strands Agents · Introducing Strands Decider 2B: a small, open source, decision model (2026.10.01)
- [9]AI Hub Landau · Jev is a new type of AI to make decisions. But how accurate are they? (published 2026.09.23; tested 2026.09.22)
- [10]TypeSafe AI · Homepage (2026.10.06 확인)
- [11]Hugging Face · convaiinnovations/laya (Apache-2.0)
- [12]Hugging Face · jev-decision-index commit adding Laya (model published 2026.09.18)
- [13]arXiv 2609.28613 · Decision Hijacking: Prompt Injection Attacks on Jev’s Typed Probabilistic Decisions (2026.09.23)
- [14]Check Point · A Decision Model Breaks Like Any Other Language Model: A First Look at Jev (2026.09.24)
- [15]arXiv 2609.31142 · JevAdvBench: A Benchmark and Black-Box Attacks for RLCD Models (2026.09.25)
- [16]Marc Brooker · Engineering System One (2026.09.28)
- [17]TechCrunch · Amazon releases its own Jev clone as decision models flood the web (2026.10.01)
- [18]OpenAI · DevDay 2026 Recap (2026.09.29)
- [19]TypeSafe Docs · Jev 1.13 jaggedness (last reviewed 2026.10.02; 2026.10.06 확인)
- [20]The New Stack · OpenAI Decisions API on GPT-6 Luna (2026.09.29)
- [21]OpenAI API Docs · Decisions API guide (public beta, pricing; 2026.10.06 확인) · OpenAI API Changelog (2026.10.06)
- [22]Hugging Face · StrandsAgents/strands-decider-2B-hobson-v19 (Apache-2.0) · hobson-v21 (2026.10.05) · GitHub strands-decider docs/vision.md (images)
- [23]GitHub · fstandhartinger/jevbench (Benchmark Heaven, not affiliated with TypeSafe)
- [24]Hugging Face · convaiinnovations/laya-typed-decisions (benchmark table)
- [25]GitHub · allebee/jevk5 (Qwen3.5 4B/9B, Apache-2.0)
- [26]GitHub · Heman10x-NGU/openJev-verdict-2.0
- [27]ideabosque · TypeSafe Jev and the Third Layer of the Agent Model Stack (2026.09.19)
- [28]TypeSafe Docs · How to build with System One · Speculative fan-out (2026.10.06 확인)
- [29]arXiv 2609.38850 · OpenJev-RLCD: A Working RLCD Implementation (2026.09.30)
2026년 10월 3일 확인, 10월 6일 주요 항목 재확인.

