AI 에이전트 하네스란? 다 고친 코드가 ‘빈 답안지’가 된 이유같은 AI, 같은 문제인데 하네스 하나 차이로 실패와 통과가 갈렸다. 사건을 따라가며 보는 에이전트의 몸
코딩 AI가 버그를 다 고쳐 놓고, 답안지는 빈칸으로 냈다. 마이크로소프트 연구진의 실험에서 실제로 나온 장면이다. AI는 ‘이렇게 고쳤습니다’라는 보고서까지 깔끔하게 남기고 작업을 끝냈는데, 정작 제출물에는 코드가 한 줄도 없었다. 해당 문제는 실패 처리됐다.
실력이 모자랐던 걸까? 연구진은 같은 AI에게 같은 문제를 다시 맡겼다. 이번에 바꾼 것은 단 하나, AI를 감싼 실행 환경인 하네스였다. 결과는 어떻게 됐을까? 그리고 빈 답안지는 대체 어디서 생겼을까?
이 ‘빈 답안지 사건’을 따라가며, AI의 실력이 어디까지가 모델이고 어디부터가 하네스인지 하나씩 뜯어보자. 직접 눌러 보는 체험 도구 16개도 준비했다.
- 하네스는 AI 모델(두뇌)에 작업장, 도구, 기억, 검문소를 달아 실제로 일하게 만드는 실행 환경이다. 공식으로 쓰면 에이전트 = 모델 + 하네스.
- 같은 모델도 하네스에 따라 결과가 크게 달라진다. Terminal-Bench 2.0에 보고된 기록을 보면, 같은 Claude Opus 4.6을 쓴 에이전트끼리도 58.0%와 76.4%처럼 큰 차이가 난다(팀마다 실행 설정도 다르다).
- 2026년 10월 마이크로소프트 연구진의 Self-HPO에서는 AI가 자기 실패 기록을 읽고 하네스에 검문소를 직접 써 넣었다. 하네스와 모델을 번갈아 키우자 세 벤치마크의 평균 해결률이 57.8%에서 64.8%로 올랐다.
01사건 파일: 다 고쳤는데 빈 답안지를 낸 AI
사건 현장부터 보자. 과제는 소프트웨어 버그 수정 시험인 SWE-bench Verified의 한 문제, 파이썬 문서 도구 Sphinx의 버그를 고치는 일이었다. 사건 번호는 sphinx-doc__sphinx-9658.
AI는 소스 코드를 고쳤고, 기존 테스트도 통과시켰다. 마무리로 ‘## Summary of Changes’로 시작해 ‘기존 테스트는 모두 통과합니다’로 끝나는 깔끔한 보고서도 썼다. 문제는 그다음이다. 하네스가 이 보고서를 그대로 제출물로 받아 버렸다. 채점기에는 코드 변경이 한 줄도 넘어가지 않았고, 과제는 실패 처리됐다.[1]
연구진은 같은 최종 모델을 진화한 하네스에 넣고 같은 과제를 다시 풀게 했다. 두 실행 모두 코드를 수정하고 기존 테스트를 통과한 상태에 도달했다. 그런데 이번엔 하네스가 첫 제출을 붙잡고 ‘제출한 패치에 파일이 없다’고 알렸다. AI는 변경 사항을 다시 확인해 diff를 만들었고, 유효한 패치를 내서 통과했다.[1] 두 장면을 나란히 놓아 보자.
- 1소스 코드를 고치고, 기존 테스트를 통과시킨다
- 2‘## Summary of Changes’ 보고서를 쓴다
- 3하네스가 보고서를 그대로 제출물로 받는다
- 채점기에 넘어간 코드 변경 0줄: 실패 처리
- 1소스 코드를 고치고, 기존 테스트를 통과시킨다
- 2변경 내용을 설명하는 보고서로 마무리하려 한다
- 하네스가 첫 제출을 붙잡는다: “패치에 파일이 없다”
- 4AI가 diff를 만들고 수정을 다시 확인한다
- 유효한 패치를 제출: 통과
논문 부록 E의 두 실행을 간단히 옮겼다.
두뇌는 똑같았다. 달라진 건 제출 순간에 한 번 더 들여다보는 장치 하나였다. 그런데 그 경고를 만든 건 누구였을까? 사람이 아니다. 그 이야기는 5장에서 마저 하기로 하고, 먼저 용의자부터 정리하자. 버그를 고친 모델, 그리고 그 모델을 감싸고 답안을 받아 준 하네스. 하네스가 정확히 무엇이길래 결말을 뒤집었을까?
잠깐, ‘하네스’는 원래 말에게 채우는 마구다
영어 harness는 1300년경 ‘전투 장비, 갑옷’을 뜻했고, 곧이어 14세기 초부터 짐 끄는 동물에게 채우는 장비라는 뜻이 붙었다.[2] 오늘날 사전도 하네스를 짐 끄는 동물에게 채우는 장비로 풀이한다.[3] 그 뒤 소프트웨어로 건너가, 테스트 대상 코드를 실행하고 결과를 확인하는 보조 프로그램과 실행 환경인 ‘테스트 하네스’가 됐다.[4] AI 시대에는 여러 모델에 같은 시험을 치르게 하고 채점하는 ‘평가 하네스’도 나왔다. EleutherAI의 lm-evaluation-harness가 대표적이다.[5] 정거장을 눌러 보자.
다섯 정거장을 꿰뚫는 뜻은 하나다. 힘은 그대로 두고, 그 힘이 엉뚱한 데로 새지 않게 연결하고 제어하는 장치.
02모델은 무엇을 하고, 하네스는 무엇을 하나
먼저 모델부터. 대규모 언어 모델(LLM)은 글을 받아 다음에 올 글을 예측한다. 모델 자체는 호출과 호출 사이에 기억을 따로 들고 있지 않다. AI 서비스가 지난 대화를 기억하는 것처럼 보이는 건, 이전 대화와 작업 기록을 다음 호출에 다시 넣어 주는 장치가 있어서다. 모델이 ‘이 파일을 열어 보고 싶다’고 쓰면 실제로 파일을 열어 결과를 돌려주는 것도, 언제 일을 멈출지 정하는 것도 그 장치의 몫이다. 이 실행 층이 바로 하네스다.[6]
LangChain은 이 관계를 공식 하나로 정리했다. ‘에이전트 = 모델 + 하네스.’ 그리고 이렇게 덧붙였다. ‘당신이 모델이 아니라면, 당신은 하네스다.’ 모델 바깥의 코드, 설정, 실행 논리가 모두 하네스라는 뜻이다.[7]
그래서 같은 두뇌라도 어떤 몸에 넣느냐에 따라 할 수 있는 일이 확 달라진다. 도구 연결이 없는 채팅에서는 고칠 코드를 ‘말’로만 알려 주지만, 코딩 하네스에 넣으면 직접 파일을 고치고 테스트까지 돌린다. 요즘은 채팅 화면에서도 도구를 쓰는 경우가 많으니, 차이를 만드는 건 화면이 아니라 그 뒤에 연결된 하네스다. Claude Code 문서도 이렇게 정리한다. Claude Code가 하네스이고, Claude는 그 안의 모델이라고.[8]
흐름을 보여 주려고 만든 예시다. 아래 이름들은 코딩 하네스의 예이고, 실제 동작은 도구마다 다르다.
숫자로도 보인다. 터미널 작업 실력을 겨루는 Terminal-Bench 2.0에는 같은 모델을 쓴 에이전트가 여럿 이름을 올린다. 스탠퍼드대 등 연구진의 Meta-Harness 논문이 공식 리더보드 기록을 표로 정리했는데, 같은 Claude Opus 4.6을 쓰고도 Claude Code는 58.0%, Meta-Harness는 76.4%였다.[9] 그 표에서 여섯 개를 골라 막대로 그려 봤다.
Meta-Harness 논문 표 7에 정리된 공식 리더보드 결과 중 여섯 개를 골랐다. 표에는 이보다 높은 기록(ForgeCode 81.8%)도 있지만, 논문 저자들은 공개된 코드만으로는 재현하지 못했다고 밝혔다. Meta-Harness는 같은 89문제로 하네스를 찾고 평가했으니 새 문제에 대한 실력과는 구분해야 한다. 기록마다 팀과 실행 설정이 달라, 하네스만의 효과로 단정할 수는 없다.
그래서 한 팀이 모델은 그대로 두고 하네스만 바꾼 실험이 더 눈길을 끈다. LangChain은 gpt-5.2-codex를 그대로 둔 채 하네스만 손봐 Terminal Bench 2.0 점수를 52.8에서 66.5로 올렸고, 30위권 밖에서 5위권으로 뛰었다.[10] 허깅페이스의 용어 정리 글도 같은 모델을 쓰는 두 제품이 전혀 다르게 느껴지는 건 하네스가 서로 다른 선택을 했기 때문이라고 설명한다.[6]
03하네스 해부도: 작업장·도구·기억·검문소
그렇다면 하네스 안에는 무엇이 들었을까? 2026년에 나온, 관련 연구를 정리한 종합 논문(서베이)은 하네스를 일곱 층으로 나눴다. 실행 환경, 도구, 컨텍스트, 생애주기, 관찰, 검증, 거버넌스다.[11] 이름은 딱딱하지만 역할로 보면 단순하다. 일하는 작업장, 손이 되는 도구, 기억을 챙기는 장치, 일을 반복하는 루프, 기록을 남기는 장치, 결과를 확인하는 검문소, 위험한 일을 막는 승인 단계. 부품을 하나씩 눌러 보자.
일곱 칸은 종합 논문 ‘에이전트 하네스 엔지니어링’의 분류(ETCLOVG)를 쉽게 옮긴 것이다. 부품 아래 로고는 각 역할에 쓰이는 대표 기술의 예다.

사건으로 돌아가 보자. 이 해부도에서, 빈 답안지 사건 때 비어 있던 칸은 어디였을까?
핵심만 남기면 이렇다. 모델이 ‘무엇을 할지’ 정한다면, 하네스는 ‘실제로 무엇을 할 수 있고, 언제 작업이 끝났다고 판단할지’를 정한다.
용어가 헷갈린다면: 프롬프트·컨텍스트·하네스 한 번에 정리
프롬프트 엔지니어링, 컨텍스트 엔지니어링, 하네스 엔지니어링. 셋은 서로를 밀어내는 유행어가 아니라, 안쪽부터 겹겹이 감싸는 관계다. 동그라미를 눌러 보자.
허깅페이스의 용어 글을 바탕으로 표도 만들었다. 그 글도 아직 모두가 동의하는 정의는 없다는 단서를 달았다.[6]
| 용어 | 한 줄 정의 | 쉽게 말하면 |
|---|---|---|
| 모델(정책) | 다음 말을 예측하고, 다음 행동을 고르는 가중치 | 두뇌 |
| 시스템 프롬프트 | 역할, 말투, 출력 형식을 정하는 지시문 | 지시문 |
| 스캐폴딩 | 지시문, 도구 설명, 응답 해석 규칙처럼 모델의 행동 방식을 정하는 층 | 행동 규칙 묶음 |
| 하네스 | 모델을 부르고, 도구 호출을 처리하고, 언제 멈출지 정하는 실행 층 | 실행 환경 전체 |
| 프레임워크 | 개발자가 에이전트를 조립할 때 쓰는 코드 도구 상자 | 조립 도구 |
도구도 작업장도 있었다. 빠진 건 검문소였다. 제출물을 받기 전에 한 번 들여다보는 단계가 없으니, 코드 없는 보고서도 답안으로 받아들여졌다.
04많이 줄수록 헷갈린다: 컨텍스트와 AI용 작업대
‘그럼 모든 걸 다 보여 주면 되지 않나?’ 하네스를 처음 만들 때 흔히 드는 생각이다. 그런데 모델에게 정보를 많이 줄수록 오히려 일이 어려워지는 경우가 많다. 모델이 한 번에 볼 수 있는 글의 양(컨텍스트 창)은 정해져 있고, 앤트로픽은 창에 토큰이 늘어날수록 모델이 그 안의 정보를 정확히 떠올리는 능력이 떨어진다고 설명한다. 이른바 컨텍스트 부패(context rot)다. 그래서 컨텍스트를 ‘쓸수록 효과가 줄어드는 한정된 자원’으로 다뤄야 한다고 강조한다.[12]
도구도 마찬가지다. 기능이 겹치거나 목적이 흐릿한 도구가 많으면 에이전트는 무엇을 써야 할지 헷갈린다.[13] 사람 엔지니어도 어떤 도구를 써야 할지 딱 잘라 말하지 못하는데 AI라고 더 잘하길 기대할 수는 없다.[12] 그래서 좋은 하네스는 많이 주는 대신 잘 골라 준다. 아래에서 습관을 켜고 끄며, 새 정보와 답을 위한 여유 공간이 얼마나 남는지 보자.
칸의 비율은 원리를 보여 주려고 정한 예시다. 실제 비율은 작업마다 다르고, 여유 공간이 곧 모델의 사고력을 뜻하지는 않는다.

오른쪽 처방은 모두 실제로 쓰이는 기법이다. 오래된 대화를 요약해 새 창에서 이어 가는 압축, 필요한 순간에만 파일을 불러오는 방식, 조사를 하위 에이전트에게 맡기고 1,000~2,000토큰 남짓한 요약만 돌려받는 방식이 앤트로픽의 정리에 나온다.[12] 앤트로픽의 에이전트 스킬(Agent Skills)도 목차부터 보여 주고 필요할 때 본문을 펼치는 ‘점진적 공개’를 핵심 설계 원칙으로 삼는다.[14] 목표는 창을 비우는 게 아니라, 지금 필요한 정보를 골라 넣는 것이다.
AI 눈높이에 맞춘 작업대: SWE-agent의 ACI
화면도 같은 원리로 설계할 수 있다. 2024년 프린스턴대 연구진은 언어 모델 에이전트를 ‘자기만의 필요와 능력을 가진 새로운 종류의 사용자’로 보고, AI 전용 인터페이스를 만들어 에이전트-컴퓨터 인터페이스(ACI)라고 불렀다.[15] 사람은 터미널에 수백 줄이 쏟아져도 눈으로 훑어 필요한 줄을 찾지만, 언어 모델에게는 쏟아진 글이 고스란히 컨텍스트를 차지한다. 그래서 SWE-agent는 검색 결과가 50개를 넘으면 결과를 보여 주는 대신 검색어를 더 구체화하도록 안내했고, 파일은 한 번에 최대 100줄씩 보여 줬으며, 편집할 때마다 린터로 문법을 확인했다. 버튼을 눌러 두 화면을 비교하고, 아래에서는 정답을 먼저 맞혀 보자.
왼쪽과 오른쪽 화면은 원리를 보여 주려고 만든 예시다. 아래 막대 수치는 SWE-agent 논문의 창 크기 실험 결과다.
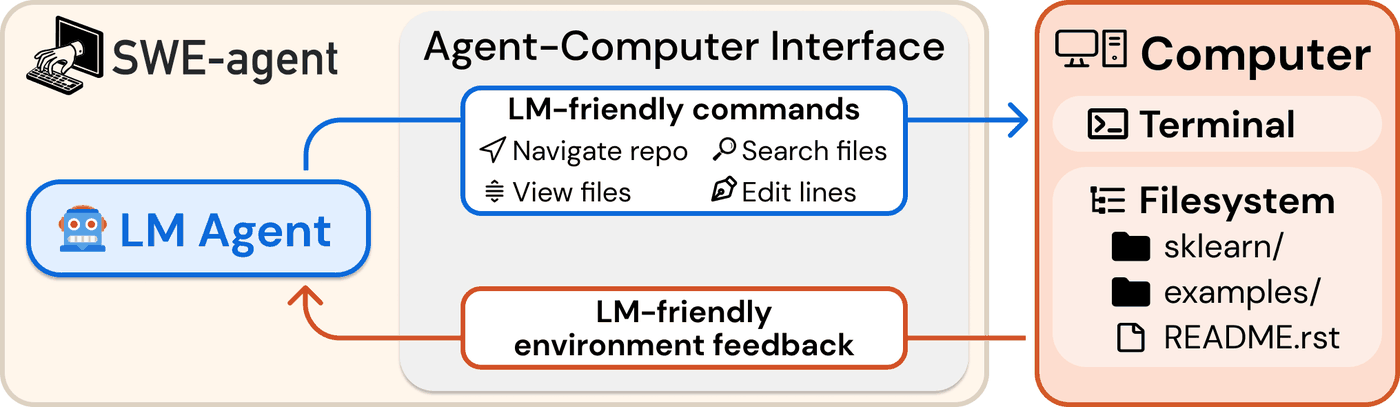
효과는 컸다. GPT-4 Turbo를 쓴 SWE-agent는 SWE-bench 2,294문제 가운데 12.47%를 풀었다. 그때까지 최고였던, 검색한 자료를 한 번 제공하고 답을 생성하게 하는 방식(3.8%)의 세 배가 넘는다. 같은 모델끼리 비교한 실험도 있다. SWE-bench Lite에서 기본 리눅스 셸만 준 에이전트는 11.0%, ACI를 쓴 SWE-agent는 18.0%였다. 모델의 가중치는 전혀 바꾸지 않았다.[15]
현장에서도 같은 결론
연구실 밖에서도 하네스는 ‘진짜 실력’으로 대접받는다. 2026년에는 ‘하네스 엔지니어링’이라는 말이 하나의 직무처럼 쓰이기 시작했다. 대표 장면 네 개를 모았다.
사람이 직접 작성한 코드 없이 5개월 만에 약 100만 줄의 코드를 쌓았다. 비결로 짧은 AGENTS.md 지도, docs/ 기록, 뒷정리 에이전트를 꼽았다.[16]
모델(gpt-5.2-codex)은 그대로 두고 하네스만 손봐 30위권에서 5위권으로 올랐다. 끝내기 전 확인 단계, 반복 감지, 시간 경고를 넣었다.[10]
첫 세션의 초기화 에이전트가 기능 목록(전부 ‘실패’로 시작)과 진행 기록 파일을 만들고, 다음 세션들은 한 번에 기능 하나씩만 끝낸다.[17]
에이전트 클래스가 파이썬 100줄 남짓이고, 도구는 bash 하나뿐이다. 그래도 SWE-bench Verified 74% 이상을 낸다고 소개한다. 이 글의 주인공 실험이 출발한 하네스다.[18]
OpenAI 코덱스 팀의 기록은 특히 상징적이다. 세 명으로 시작해 일곱 명까지 늘어난 팀이 약 1,500개의 풀 리퀘스트를 합쳤는데, 사람이 직접 작성한 코드는 없었다. 이들이 내건 원칙은 짧다. ‘사람은 방향을 잡고, 에이전트는 실행한다(Humans steer. Agents execute.)’[16] 그리고 에이전트가 볼 수 없는 지식은 없는 것과 같다는 점을 일찍 깨달았다.

앤트로픽도 비슷한 결론에 닿았다. 며칠 걸리는 긴 작업을 맡기면, 에이전트는 새 세션마다 앞 세션에서 한 일을 기억하지 못한다. 그래서 첫 세션의 초기화 에이전트가 기능 목록과 진행 기록 파일, 첫 git 커밋을 남기고, 뒤이은 세션은 한 번에 기능 하나씩만 끝내게 했다.[17] 기억을 모델에 맡기지 않고 하네스가 파일로 챙기는 셈이다.
05AI가 자기 검문소를 만들기 시작했다: Self-HPO
지금까지 본 하네스는 대부분 사람이 공들여 만든 것이다. 그런데 2026년 들어 AI가 하네스를 직접 고치는 연구가 쏟아졌다. 누가 하네스를 고치는지, 그리고 모델의 가중치도 함께 바꾸는지로 나누면 네 갈래가 보인다. 카드를 차례로 눌러 보자.
H는 하네스, P는 정책(모델의 가중치)이다. 날짜는 대표 연구가 공개된 때이고, 네 접근은 지금도 함께 쓰인다.
세 번째 갈래의 성과도 만만치 않다. 상하이 AI 연구소의 Self-Harness는 모델은 그대로 둔 채 하네스만 고쳐, Terminal-Bench 2.0에서 Qwen3.5-35B-A3B의 전체 통과율을 18.0%에서 36.7%로 올렸다. 하네스를 고칠 때 쓰지 않고 따로 남겨 둔 문제에서도 23.8%에서 38.1%로 올랐다.[19] 사카나 AI 등의 RHI도 프롬프트로 적은 하네스를 거듭 고칠 뿐, 모델의 가중치는 건드리지 않는다.[20] 다만 이런 하네스 진화의 성과가 같은 비용을 그냥 더 많은 시도에 쓰는 것보다 낫다고 보기 어렵다는 반론도 나왔다.[21] 모델이 그대로면 같은 사각지대 안에서 맴돌기 쉽고, 반대로 모델만 학습시키면 고정된 하네스가 이끌어 내는 행동 범위 안에서만 배운다. 그래서 네 번째 갈래, 하네스와 모델을 함께 키우는 연구가 나왔다. 2026년 6월 공개된 HarnessForge가 이 방향이다.[22]

그리고 2026년 10월 16일, 마이크로소프트 리서치와 버지니아대, 카네기멜런대 연구진이 Self-HPO를 내놨다. 우리말로 풀면 ‘하네스와 정책을 함께 최적화하며 스스로 진화하는 코딩 에이전트’다. 빈 답안지 사건도 바로 이 논문의 부록에 실린 장면이다.[1]
출발점은 소박하다. 모델은 전체 파라미터 350억 개 중 약 30억 개가 활성화되는 오픈 모델 Qwen3.5-35B-A3B,[23] 하네스는 파이썬 100줄 남짓의 mini-SWE-agent다.[18] 여기서 두 단계를 번갈아 돈다.
H-step에서는 모델의 가중치를 고정한 채 문제를 풀게 하고, 모델이 자기 실패 기록을 직접 읽으며 하네스 수정안을 여섯 개 써 낸다. 후보를 하나씩 실제로 돌려 보고 가장 많이 푼 하네스를 고른다. P-step에서는 그 하네스 안에서 강화학습으로 모델을 훈련한다. 보상은 오직 ‘테스트를 통과했나’ 하나다. 그리고 학습 내내 한 번도 풀지 못한 문제만 모아 다음 H-step의 시험지로 쓴다. 하네스 수정이 늘 모델의 ‘최신 약점’을 겨누게 하려는 장치다.[1]
수치는 논문 표 1의 세 벤치마크 평균이다. 중간 단계의 점수는 생략했다.
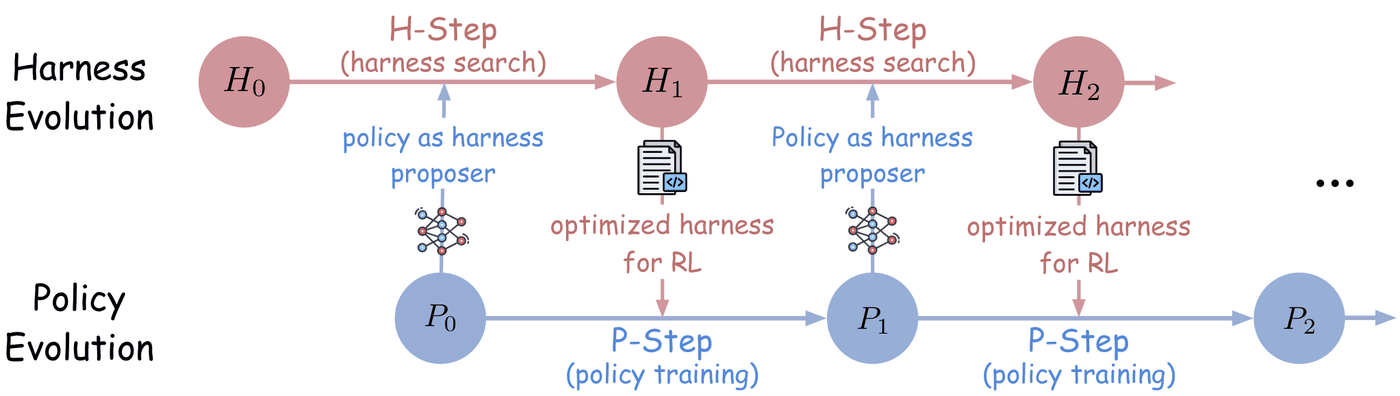
이 루프에는 더 똑똑한 ‘선생님 모델’이 없다. 하네스를 고치는 것도, 그 하네스 안에서 배우는 것도 같은 모델이다.
이제 빈 답안지가 어디서 걸러졌는지 볼 차례다
AI는 자기 하네스에 무엇을 써 넣었을까? 거창한 추론 알고리즘을 기대했다면 조금 싱거울 수 있다. 저자 블로그에 따르면, AI가 써 넣은 것은 대부분 ‘제출하는 순간’ 작동하는 실용적인 검사였다. 하네스는 패치를 바로 받아 주지 않고 먼저 살펴본 뒤, 무엇이 이상한지 알려 주고 한 번 더 기회를 준다. 검사는 세 가지다. 작업 중에 건드린 파일이 모두 패치에 들어갔는지 보는 패치 누락 검사(커버리지 검사), @cache 같은 데코레이터를 쓰고도 import를 빠뜨린 건 아닌지 보는 데코레이터 알림, 패치가 이슈의 핵심 단어를 다루는지 대조하는 이슈 의도 알림.[24] 검문소에 어떤 검사를 켤지 직접 골라 보자.
AI가 자기 하네스에 써 넣은 세 검사다. 켜고 싶은 검사를 누른 뒤 ‘제출 받기’를 눌러 보자.
네 답안은 설명용 예시다. 검사 이름과 경고 문구는 저자 블로그가 소개한 실제 검사를 쉽게 옮겼다. 검사에 걸린 답안은 고친 뒤 다시 검사를 받는다.
1장의 빈 답안지를 붙잡은 것도 바로 이 검문소다.[1] 다만 검문소는 문제를 찾아 돌려보낼 뿐이고, 고친 답안도 다시 검사를 통과해야 한다.
재미있게도 사람이 만든 하네스도 같은 곳에 힘을 줬다. LangChain은 에이전트가 일을 끝내기 전에 반드시 검증을 한 번 거치게 하는 체크리스트 단계를 넣었다.[10] 사람이든 AI든, 결국 ‘끝내기 전에 한 번 더’가 점수를 지킨다. 연구진은 진화한 하네스를 코드로 공개해, 누구나 자기 하네스와 비교해 볼 수 있다.[25]
구멍은 빈 답안지를 그냥 받아 준 제출 단계에 있었다. 그리고 그 구멍을 메운 검사는 사람이 아니라, 자기 실패 기록을 읽은 AI가 직접 써 넣었다.
06얼마나 좋아졌고, 어디까지 믿을 수 있나
사건 하나로 결론을 낼 수는 없다. 전체 성적표를 보자. 연구진은 이번 추가 학습을 파이썬 과제로만 진행한 뒤 세 벤치마크에서 평가했다. 파이썬 문제 500개로 된 SWE-Bench Verified, 파이썬이 아닌 9개 언어로 된 300문제의 SWE-Bench Multilingual,[26] 그리고 더 길고 어려운 SWE-Bench Pro다.[27] 탭을 바꿔 가며 보자.
논문 표 1, 세 번 평가한 평균이다. Pro는 연구진이 쓴 SWE-Bench Pro 공개 V2 세트(642문제) 기준이라 공식 리더보드 점수와 바로 비교할 수 없다.
Self-HPO는 세 벤치마크의 평균 해결률을 57.8%에서 64.8%로, 7.0%p 끌어올렸다. 하네스만 진화시킨 방식(60.1%)과 모델만 학습시킨 방식(61.9%)을 모두 앞선다. 이번 추가 학습은 파이썬 과제로만 진행했는데도, 하네스만 고쳤을 땐 거의 움직이지 않던(+0.1%p) 9개 언어로 구성된 시험의 해결률이 5.5%p 올랐다.[1]
둘을 함께 바꾸면 얼마나 좋아질까?
더 재미있는 숫자도 있다. 진화한 하네스만 기본 모델에 씌우면 Verified 점수가 3.5%p, 학습한 모델만 기본 하네스에 넣으면 3.4%p 올랐다. 그럼 둘을 함께 쓰면 어떻게 될까? 버튼을 누르기 전에 먼저 맞혀 보자.
막대는 SWE-Bench Verified 기준이다(기본 61.0%). 아래 주사위 그림은 원리를 보여 주는 예시이고, 11~17%와 6.5%는 논문 수치다.
정답은 8.5%p다. 따로 올린 합 6.9%p보다 1.6%p 더 크다. 1 더하기 1이 2보다 큰 셈이다.[1] 비밀은 강화학습의 ‘신호’에 있다. 이 학습법은 한 문제를 여러 번 풀어 보고, 잘된 시도와 안 된 시도를 비교하며 배운다. 여러 번 모두 틀리면 비교할 거리가 없어 신호가 끊긴다. 모델만 학습시킨 방식에서는 이렇게 ‘신호가 끊긴 묶음’이 학습 후반 내내 대체로 11~17%였는데, Self-HPO의 마지막 학습 단계에서는 6.5%까지 줄었다.[1] 하네스가 빈 답안지 같은 어처구니없는 실수를 잡아 주면 성공하는 시도가 생기고, 그만큼 배울 거리도 늘어난다고 볼 수 있다.

센 모델은 선생님으로 쓸까, 설계자로 쓸까
실무자에게 쓸모 있는 비교도 있다. 작은 모델을 키우고 싶은 회사들은 흔히 센 모델의 풀이 기록을 모아 작은 모델을 추가 학습시킨다(SFT 증류). 센 모델을 ‘선생님’으로 쓰는 방식이다. 연구진은 Claude Opus 4.8로 세 가지를 비교했다. 풀이 기록으로 작은 모델을 학습시키는 SFT, 작은 모델은 그대로 두고 Opus 4.8이 하네스만 설계하는 Meta-Harness 방식, 그리고 Opus 4.8의 하네스 설계에 작은 모델의 강화학습까지 더한 HPO다.[1] 버튼을 눌러 비교해 보자.
논문 표 1 수치(세 번 평가한 평균)다. 센 모델은 모두 Claude Opus 4.8, 작은 모델은 Qwen3.5-35B-A3B다. 점선은 기본 모델이다.
풀이 기록으로 추가 학습한 모델은 익숙한 Verified에서 65.0%로 올랐지만, 낯선 Multilingual(49.6%)과 Pro(49.1%)에서는 기본 모델보다도 떨어졌다. 세 벤치마크 평균은 SFT 54.6%, Meta-Harness 63.5%, HPO 66.3%다. 하네스 설계만으로 SFT보다 8.9%p 높았고, 작은 모델의 강화학습까지 더하자 차이가 11.7%p로 벌어졌다.[1] 이번 실험에서는 센 모델을 선생님보다 하네스 설계자로 쓰는 쪽이 더 잘 통했다는 뜻이다. 저자도 블로그에 이렇게 정리했다.
“센 모델이 있다면, 그 지식을 가중치가 아니라 하네스에 담아라.”Zhepei Wei, Self-HPO 블로그 [24]
다만 설계자가 꼭 센 모델일 필요는 없었다. Opus 4.8을 설계자로 붙이면 Verified가 69.5%에서 71.6%로 2.1%p 더 올랐지만, 저자들은 도움이 되지만 필수는 아니라고 결론 내렸다.[1] 빈 답안지를 잡은 검문소도 Opus가 아니라, 학습 중인 모델이 직접 써 넣은 것이었다.
평균 점수가 올라도, 더 못 푸는 문제는 있다
좋은 소식만 있는 건 아니다. 기본 에이전트가 8번 시도해 몇 번 푸는지로 문제를 나눠 보면, 개선 폭이 들쭉날쭉하다. 가끔 풀던 ‘중간’ 문제는 17.2%p, ‘쉬운’ 문제는 12.9%p, 8번 다 못 풀던 ‘어려운’ 문제도 6.1%p 올랐다. 8번 기회를 주면 풀 수 있는 문제의 범위도 80.0%에서 84.8%로 넓어졌다. 그런데 8번 모두 풀던 문제에서는 오히려 2.2%p 떨어졌다.[1]

논문은 이 하락의 이유를 따로 설명하지 않는다. 하네스와 모델을 함께 바꾼 비교라서, 무엇 때문인지 단정할 수도 없다. 평균적인 향상이 모든 문제에서의 향상을 뜻하지는 않는다는 점만 기억해 두자.
벤치마크 자체도 조심해서 읽어야 한다. OpenAI는 2026년 2월, SWE-bench Verified가 점점 오염되고 있다며 이 벤치마크로 평가하는 것을 그만두고 SWE-bench Pro를 쓰자고 했다.[28] 이 논문의 Pro 점수도 연구진이 쓴 공개 V2 세트(642문제) 기준이라 공식 리더보드와 바로 비교할 수 없다. 하네스와 모델을 번갈아 개선하는 과정은 두 라운드 진행했고, 성능은 세 번 평가한 평균으로 보고했다.[1] ‘이 방향이 통한다’는 신호로 읽는 편이 안전하다.
빈 답안지를 잡은 바로 그 실행에서, 다른 검사(이슈 의도 알림)는 이슈 본문의 엉뚱한 단어를 문제 삼는 오탐을 냈다.[1] 검문소는 많을수록 좋은 게 아니라 정확할수록 좋다.
07내가 쓰는 AI의 하네스 점검하기
이제 시선을 내 화면으로 돌려 보자. 코딩 에이전트든 업무 자동화 도구든, 우리가 쓰는 AI에도 하네스가 있다. 빈 답안지 사건에서 배운 질문 다섯 개로 점검해 보자. 해당하는 항목을 켜면 된다.
이 글에서 다룬 하네스 부품을 바탕으로 만든 간단한 자가 점검이다. 점수는 참고용이다.
처음의 빈 답안지 사건으로 돌아가 보자. 모델은 똑같았다. 달라진 건 제출 직전에 한 번 더 확인하게 만든 작은 검사 하나였다. AI의 실력은 모델 안에만 있지 않다. 모델을 감싼 세계, 하네스에도 있다. 그러니 다음에 AI에게 일을 맡길 때는 이 질문 하나부터 던져 보자. 내 AI는 완료를 선언하기 전에 무엇을 확인하는가? 그 답이 곧, 이 AI가 차고 있는 마구의 모양이다.
더 읽기: 하네스는 어디로 갈까
작은 모델의 반격. ‘컨텍스트 말고 하네스를 키워라’라는 제목의 2026년 9월 논문은 웹 작업 시험(WebArena-Verified)에서, 흔히 쓰는 도구 호출 방식이 4B 모델로는 6.7%까지 떨어진 반면 하네스를 키운 방식은 실험한 세 가지 모델(4B~120B)에서 44.7~45.3%를 지켰다고 보고했다. 도구 호출 방식과 비교해 LLM 호출은 76.0~91.8%, 배포 후 실행 단계의 추론 비용은 74.4~98.6% 줄였다.[29]
갈아 끼우는 부품. 앤트로픽이 2024년 11월 공개한 MCP는 AI를 데이터와 도구에 잇는 표준이고,[30] 구글이 2025년 4월 발표한 A2A는 에이전트끼리 대화하는 규약이다.[31] 표준이 자리 잡을수록 하네스는 특정 모델에 묶이지 않고 바꿔 끼울 수 있는 부품이 된다.
새로운 보안 숙제. 스스로 바뀌는 에이전트에는 그만큼 위험도 따라온다. ‘Zombie Agents’ 연구는 외부 내용에 숨은 지시가 에이전트의 기억에 저장되면, 세션이 바뀌어도 사라지지 않는 지속적인 침해가 될 수 있다고 경고했다.[32] AI가 하네스까지 고치는 시대라면, 하네스 변경도 코드처럼 검토하고 시험해야 한다.
사람의 자리. OpenAI 코덱스 팀의 문장이 방향을 요약한다. 사람은 방향을 잡고, 에이전트는 실행한다.[16] 개발자의 일은 코드를 직접 작성하는 데서, 에이전트가 일할 세계를 설계하고 검문소를 세우는 쪽으로 옮겨 가고 있다.
AI 에이전트와 자동화가 처음이라면 반복 업무를 AI 에이전트에게 맡기는 법부터, 코딩 AI 순위가 궁금하다면 코딩 AI 비교 글도 함께 읽어 보자.
읽고 나면 생기는 질문 5가지
하네스와 프레임워크는 같은 말일까?
조금 다르다. 프레임워크는 개발자가 에이전트를 조립할 때 쓰는 코드 도구 상자이고, 하네스는 그렇게 조립된 에이전트가 실제로 돌아가는 실행 환경 전체다. 프레임워크로 하네스를 만들 수 있지만, 같은 프레임워크로도 전혀 다른 하네스가 나온다.
프롬프트만 잘 써도 되지 않을까?
프롬프트는 하네스의 일부일 뿐이다. 명령을 어디서 실행할지, 무엇을 허락할지, 실패하면 어떻게 할지, 정말 끝났는지 확인하는 일은 프롬프트만으로 풀리지 않는다. LangChain은 모델을 그대로 두고 하네스만 바꿔 Terminal Bench 2.0 점수를 52.8에서 66.5로 올렸다.
나도 이미 하네스를 쓰고 있을까?
코딩 에이전트를 쓴다면 이미 쓰고 있다. Claude Code 문서는 Claude Code를 하네스, Claude를 그 안의 모델이라고 설명한다. 반복 업무에 에이전트를 붙인다면 격리된 작업장, 꼭 필요한 권한, 테스트 같은 검증, 실행 기록부터 챙기자.
AI가 자기 하네스를 고치면 위험하지 않을까?
위험이 있다. 스스로 기억을 쌓는 에이전트를 다룬 연구는 외부 문서에 숨은 지시가 기억에 저장되면 세션이 바뀌어도 사라지지 않는 지속적인 침해가 될 수 있다고 경고한다. Self-HPO도 연구진이 정한 실험 환경과 테스트 안에서 돌았다. 실제로 쓴다면 하네스 변경도 코드처럼 검토와 테스트를 거쳐야 한다.
Self-HPO 성적을 그대로 믿어도 될까?
조심해서 읽자. 하네스와 모델을 번갈아 개선하는 과정은 두 라운드였고, 성능은 세 번 평가한 평균이다. SWE-Bench Verified는 OpenAI가 오염이 심해졌다며 평가를 그만둔 벤치마크이고, Pro 점수는 연구진이 사용한 공개 V2 세트(642문제) 기준이다. 방향을 보여 주는 결과로 읽는 편이 좋다.
출처
- [1]Wei et al. · Self-Evolving Coding Agents via Harness-Policy Optimization (arXiv, 2026.10.16)
- [2]온라인 어원 사전 · harness
- [3]Merriam-Webster · harness
- [4]위키백과(영문) · Test harness
- [5]EleutherAI · lm-evaluation-harness (GitHub)
- [6]Hugging Face · Harness, Scaffold, and the AI Agent Terms Worth Getting Right (2026.05.25)
- [7]LangChain · The Anatomy of an Agent Harness (2026.03.10)
- [8]Claude Code Docs · Glossary (agentic harness)
- [9]Lee et al. · Meta-Harness: End-to-End Optimization of Model Harnesses (arXiv, 2026.03.30)
- [10]LangChain · Improving Deep Agents with harness engineering (2026.02.17)
- [11]Li et al. · Agent Harness Engineering: A Survey (ETCLOVG taxonomy)
- [12]Anthropic · Effective context engineering for AI agents (2025.09.29)
- [13]Anthropic · Writing effective tools for AI agents, using AI agents (2025.09.11)
- [14]Anthropic · Equipping agents for the real world with Agent Skills (2025.10.16)
- [15]Yang et al. · SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering (NeurIPS 2024)
- [16]OpenAI · Harness engineering: leveraging Codex in an agent-first world (2026.02.11)
- [17]Anthropic · Effective harnesses for long-running agents (2025.11.26)
- [18]SWE-agent · mini-SWE-agent (GitHub)
- [19]Zhang et al. · Self-Harness: Harnesses That Improve Themselves (arXiv, 2026)
- [20]Lee et al. · Recursive Harness Self-Improvement (Sakana AI, arXiv 2026)
- [21]Rethinking the Evaluation of Harness Evolution (arXiv, 2026)
- [22]Chen et al. · HarnessForge (arXiv, 2026)
- [23]Qwen · Qwen3.5-35B-A3B model card (Hugging Face)
- [24]Zhepei Wei · Self-HPO blog post (case study and evolved harness)
- [25]MSR-Orchard · Self-HPO code and released harnesses (GitHub)
- [26]SWE-bench Multilingual
- [27]Deng et al. · SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks? (arXiv, 2025.09)
- [28]OpenAI · Why we no longer evaluate SWE-bench Verified (2026.02.23)
- [29]Li et al. · Grow the Harness, Not the Context (arXiv, 2026.09)
- [30]Anthropic · Introducing the Model Context Protocol (2024.11.25)
- [31]Google · Announcing the Agent2Agent Protocol (2025.04.09)
- [32]Yang et al. · Zombie Agents: Persistent Control of Self-Evolving LLM Agents (arXiv, 2026.02)
논문, 공식 블로그와 문서, 리더보드를 먼저 확인했다. 수치는 2026년 10월 20일에 확인한 값이다. Self-HPO 수치는 논문 표를 그대로 옮겼고, 원문과 다르게 알려진 내용은 원문 기준으로 바로잡았다. 체험 도구 속 화면과 예시는 이해를 돕기 위한 가상의 장면이다. 그림은 출처를 밝혀 설명 목적으로 실었다.
다음 AI 테크 노트도 받아보기
새 글 알림을 원한다면 홈의 구독 신청을 이용하면 된다.
구독 안내 보기 ↗