제미나이 4 카본 총정리: 아르곤 일반 공개 15일 만에 온 ‘탄소’, 무엇이 달라졌나17개 중 15개 1등인데 환각률은 왜 올랐을까? 체험 도구 10개로 직접 눌러 보며 읽는 구글의 새 프런티어 모델
아르곤을 다 익히기도 전에 카본이 왔다. 구글은 제미나이 4 아르곤을 일반에 공개한 지 15일 만인 2026년 10월 28일, 다음 프런티어 모델 제미나이 4 카본(Gemini 4 Carbon)을 발표했다(아르곤 발표는 9월 30일, 일반 공개는 10월 13일). 순다르 피차이 CEO는 X에 “모델을 주기적으로(periodically) 내놓겠다고 했죠…”라고 썼다. 18번 원소 아르곤 다음에 6번 원소 카본이 나오자 사람들은 이 말을 주기율표(periodic table) 말장난으로 읽었고, 구글의 로건 킬패트릭이 “지금은 전부 원소”라고 답하면서 말장난은 사실상 공식이 됐다.
이름보다 재밌는 건 성적표다. 이 모델은 독립 평가 기관 Artificial Analysis의 종합 지능 지수에서 1등을 했는데, 같은 기관의 지식 시험에서는 전작보다 틀린 답을 더 자주 지어냈다. 둘 다 사실이다. 구글이 공개한 다섯 모델 비교표에서는 17개 평가 항목 모두에서 아르곤을 앞섰고, 그중 15개에서 1위를 차지했다. 그런데 첫마디가 나오기까지는 컵라면이 반쯤 익을 만큼 걸리고, 토큰 단가만으로는 실제 작업 비용을 알 수 없다. 높은 점수를 어떻게 읽어야 하는지, 이번 모델의 진짜 재미는 거기에 있다.
나도 아직 카본을 써 보지 못했다. 10월 29일 기준으로 구글은 일부 사이버 방어팀에만 먼저 열어 두었다. 그래도 이 성적표는 곧 우리가 불러 쓰게 될 모델의 예고편이다. 그래서 공식 발표와 독립 평가를 하나하나 대조하고, 숫자를 직접 만져 볼 수 있는 체험 도구 10개로 강점과 한계를 정리했다. 도구 속 움직임은 이해를 돕는 연출이고, 숫자는 출처의 값 그대로다. 일반에 공개되면 가장 먼저 맡겨 보고 싶은 일도 정해 뒀다. 이 블로그의 출처와 숫자를 끝까지 대조하고, 틀린 곳을 고친 뒤 다시 검사하는 일이다.
- 제미나이 4 카본은 구글이 2026년 10월 28일 발표한 프런티어 모델이다. 아르곤 일반 공개 15일 만이며, 구글이 공개한 다섯 모델 비교표에서 17개 평가 항목 모두 아르곤을 앞섰고, 그중 15개에서 1위를 차지했다.
- 강점은 여러 단계의 일을 오래 이어 가는 끈기와 사이버보안(취약점 재현·공격 검증·패치 세 부문 모두 1위)이다. 함께 볼 변화도 있다. Artificial Analysis의 high 설정 측정에서 첫마디(첫 토큰)까지 약 100초가 걸렸고, 같은 기관의 지식 시험에서 환각률은 아르곤 4%에서 11%로 올랐다.
- 지금은 일부 사이버 방어팀만 쓴다. 도입 할인 가격(정가 4달러·20달러의 절반)은 100만 토큰당 입력 2달러, 출력 10달러이고, 일반 공개 날짜는 아직 없다.
01‘주기적으로’ 내놓겠다더니, 정말 주기율표였다
피차이의 게시물은 이렇게 시작한다. “I did say we’d be releasing our models periodically…introducing Gemini 4 Carbon, our next frontier model.” 아르곤이 나온 지 2주 만에 다음 모델을 소개하면서 하필 ‘주기적으로’라는 단어를 골랐다.[1] 일론 머스크는 이 게시물을 인용하며 딱 한 단어를 남겼다. “Impressive(인상적이네).”[2]
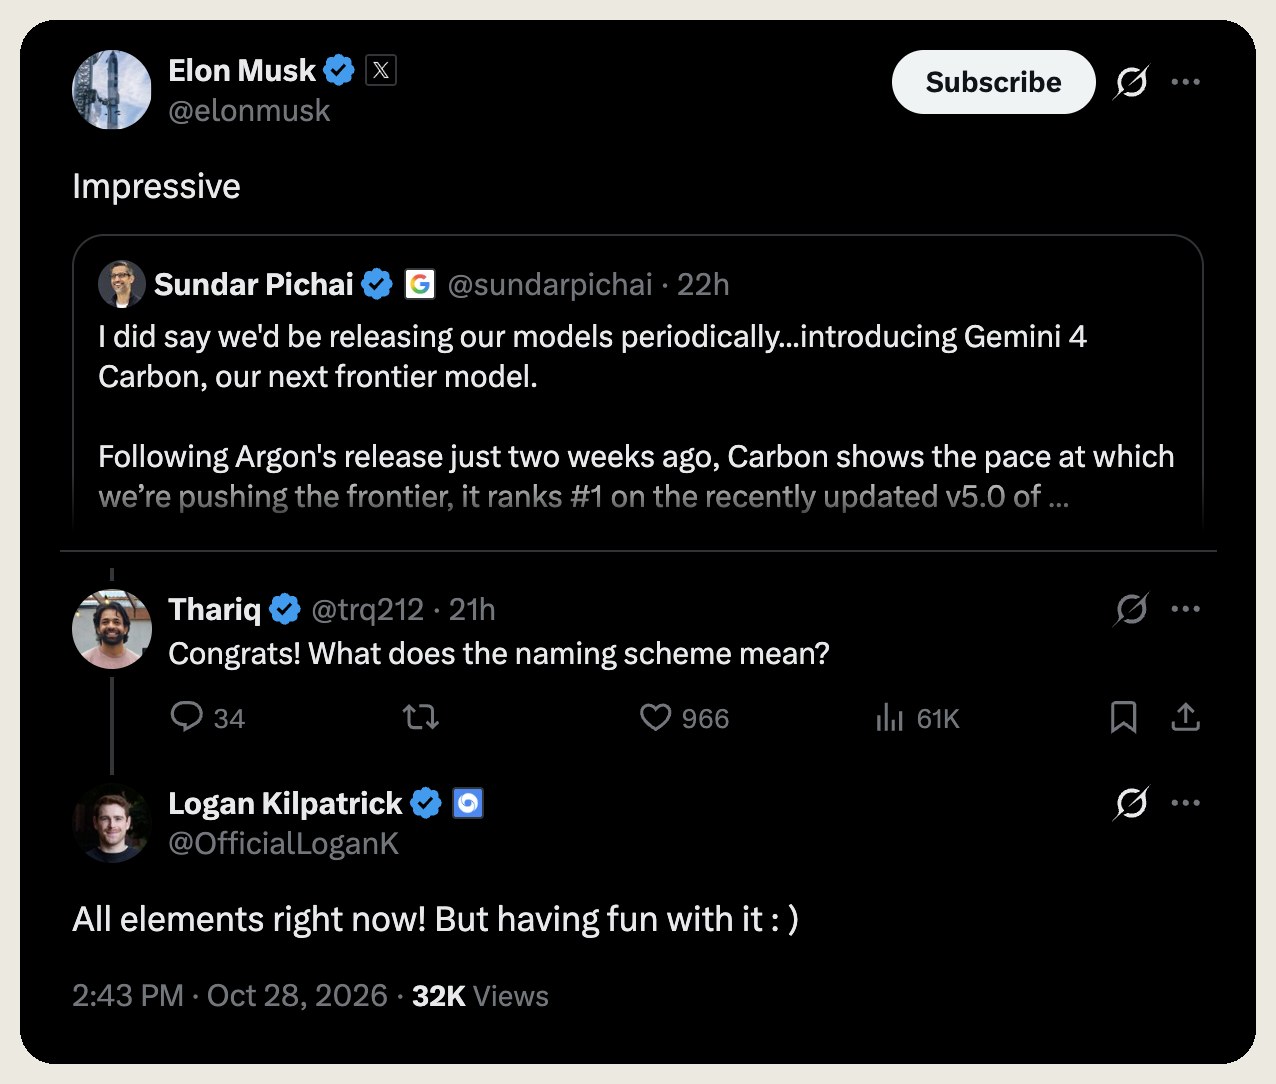
이름 규칙을 묻는 질문에 구글 AI 스튜디오와 제미나이 API를 이끄는 로건 킬패트릭은 “지금은 전부 원소예요! 재미로 하고 있어요 : )”라고 답했다.[3] 공식 설명은 이게 전부다. 덕분에 커뮤니티는 신이 났다. 알파벳 순서로 가는 거라면 J로 시작하는 원소가 없어서 열 번째에서 막힌다는 지적이 나왔고[4], 18, 6 다음은 헬륨(2)이라는 계산[5]과 번호가 작을수록 세다면 수소(1)가 끝판왕이냐는 농담도 이어졌다.[6] 직접 뽑아 보자.
- 구글 내부 문서에 실제로 있던 이름이다. 세상에 ‘아르곤’으로 나간 모델의 내부 이름이 Barium-B였다(글 끝 여담 1).
- “아르곤(18), 카본(6), 다음은 헬륨이고 그다음은 쿼크쯤 되겠네.” 18을 3으로 나누면 6, 6을 3으로 나누면 2. 그다음은 원소가 바닥난다.
- “카본(6)이 아르곤(18)보다 좋다면, 수소(1)가 궁극의 제미나이인가?” 번호가 작을수록 세다는 가설이다.
- A(아르곤), B(바륨), C(카본) 다음은 D? 그런데 이 순서라면 열 번째 J에서 막힌다. J로 시작하는 원소가 없다는 지적이 붙었다.
- 원소 기호 다섯 개를 이어 붙이면 OBSCURE(알쏭달쏭한). 다음 이름은 아무도 모른다는 뜻이다.
버튼을 누를 때마다 구글 내부 문서와 Hacker News 댓글에 나온 후보를 하나씩 보여 준다.
바륨만 실제 문서에 있던 이름이고(Business Insider 보도), 나머지는 Hacker News 이용자들의 농담과 추측이다. 원소 이름이라는 건 구글 쪽에서 확인됐지만, 어떤 순서로 고르는지는 설명하지 않았다.
이름만 놓고 보면 그림이 재밌다. 아르곤은 이름부터 그리스어로 ‘게으른’이라는 뜻에서 왔고, 다른 원소와 좀처럼 반응하지 않는 비활성 기체다. 탄소는 무엇과도 잘 결합하고, 같은 원자로 연필심(흑연)도 되고 다이아몬드도 된다. 구글이 고른 대표 이미지도 여러 면으로 깎인 결정이다. 무엇에든 쓰이는 범용성과 단단한 끈기라는 카본의 자랑거리와 어울리긴 한다. 블로그 이름이 ‘단단한 인생’이라 그런지, 가장 단단한 결정을 만드는 원소에 괜히 정이 간다. 물론 이건 내 해석이고, 구글은 이름의 뜻을 밝히지 않았다.
이름 다음으로 궁금한 건 ‘그래서 지금 쓸 수 있나’다. 아직은 아니다. 구글은 이번 주부터 일부 사이버 방어팀에 먼저 열고, 미국 정부의 사전 시험 절차에 참여하면서 단계적으로 넓히겠다고 했다. 일반 공개 날짜는 없다(7장).[7]
아르곤 공개 15일 만에 또 새 모델이라니 빠르긴 빠르다. 구글이 발표 간격을 직접 설명하진 않았지만, 피차이는 같은 날 실적 발표에서 AI가 구글의 훈련과 출시 속도를 끌어올리고 있고, RSI(재귀적 자기 개선, AI가 다음 AI의 개발을 돕는 것) 덕분에 앞으로 12개월도 가속이 이어질 것이라고 말했다.[8] 카본은 이미 구글 사내에 배포돼 쓰이고 있다고도 했다.[9] 내부 코드네임과 발표 무렵의 보안 소동 같은 뒷이야기는 글 끝 여담에 모아 두었다.
02성적표 한 장, 평가 17개: 15개 1등, 그런데 누가 쟀을까
구글은 카본·아르곤·GPT-6 Astra·Claude Opus 5.5·Claude Fable 5.1을 나란히 비교한 표를 공개했다. 평가 항목은 17개다. 카본은 17개 모두 아르곤보다 높았고, 15개에서 가장 높은 점수를 받았다.[10] ‘시험’이 아니라 ‘평가 항목’이라고 부르는 데는 이유가 있다. AA Index나 Vals Index처럼 여러 시험을 묶은 지수도 한 줄씩 들어가 있기 때문이다.
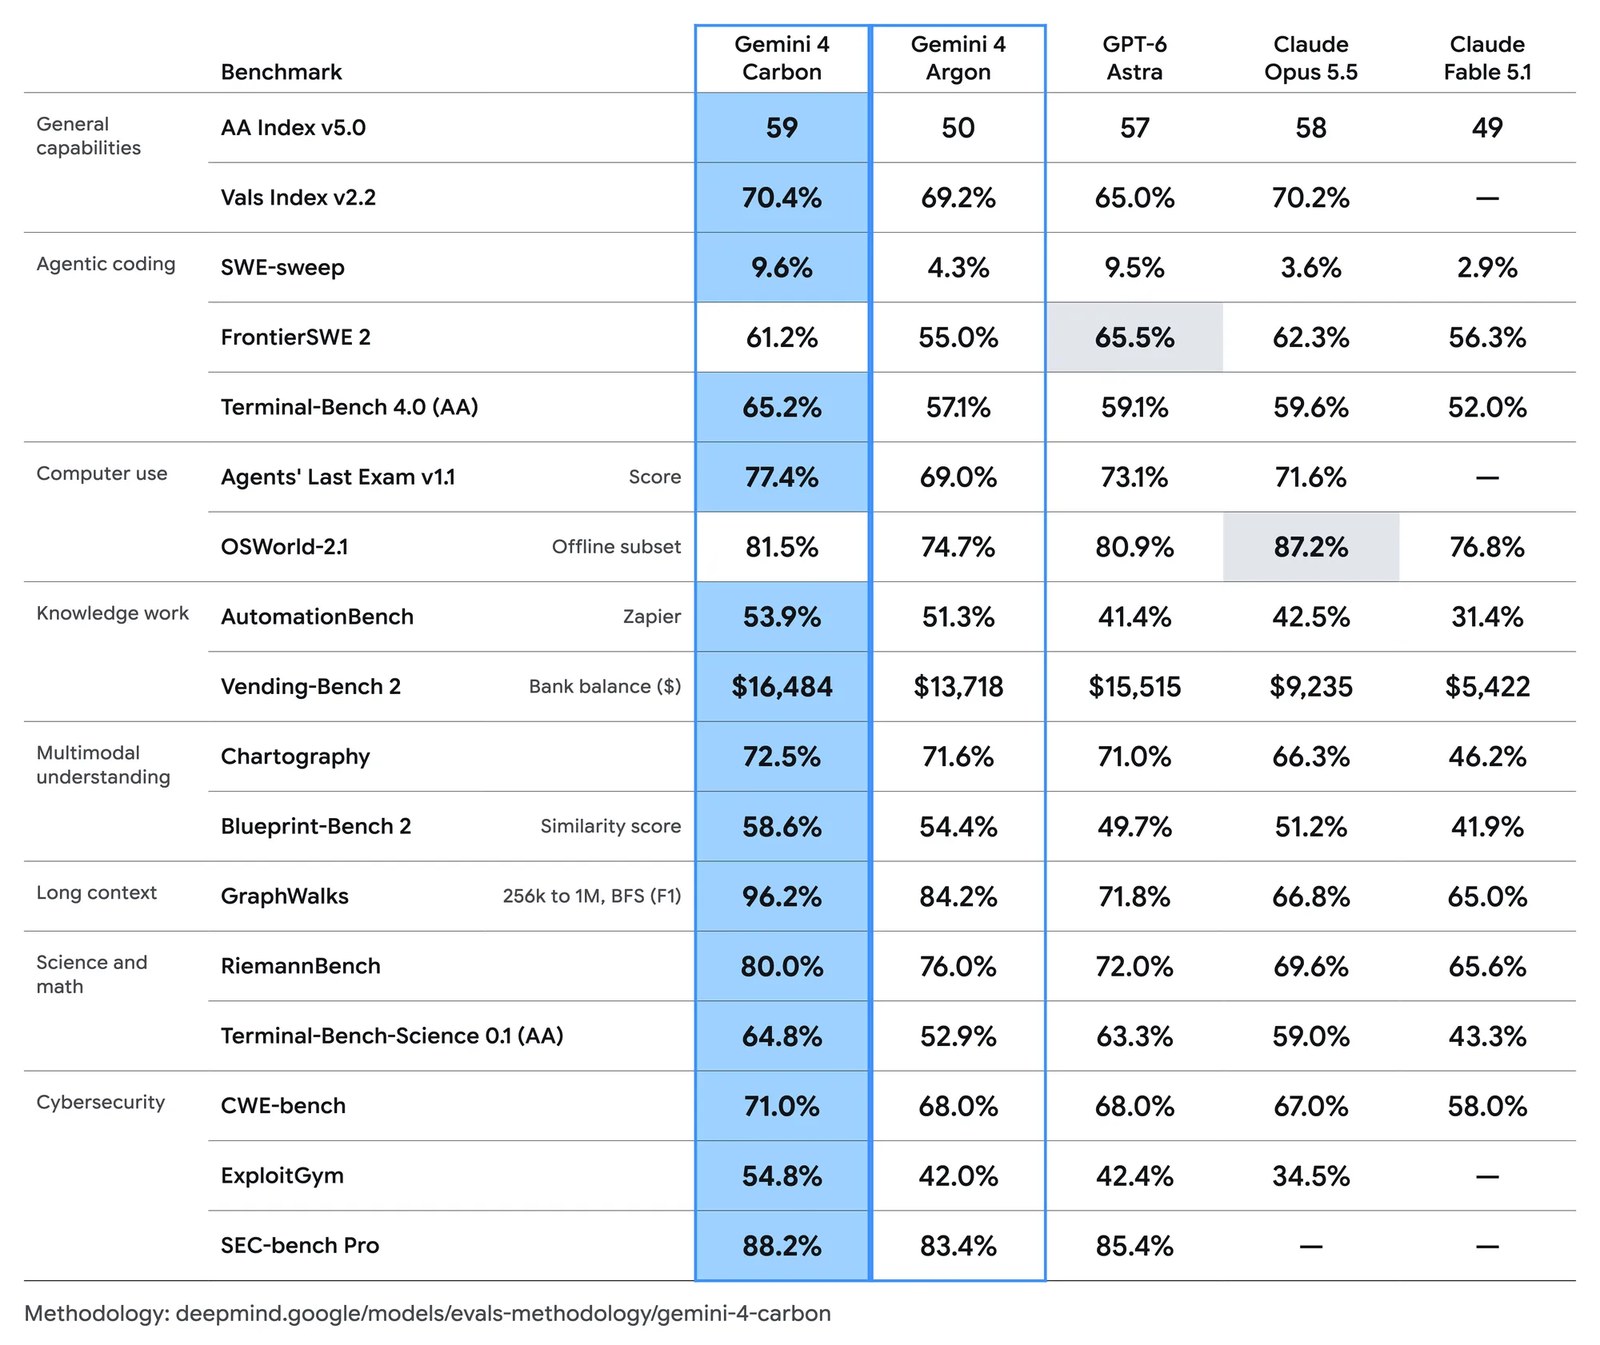
표만 보면 지루하니 게임으로 바꿨다. 카본이 1등을 놓친 항목 2개를 찾아보자. 힌트를 주면, 하나는 코딩 분야에, 하나는 컴퓨터 조작 분야에 있다. 카드마다 1등일 것 같은 모델을 누르면 정답과 막대그래프가 열린다. 오른쪽 위 배지도 눈여겨보자. 구글의 측정 방법 문서를 보면 항목마다 점수를 잰 주체가 다르다.[11] 독립 기관이 모든 모델을 같은 조건으로 잰 항목이 있는가 하면, 카본 점수는 구글이 직접 재고 경쟁 모델 점수는 각 회사 발표를 가져온 항목도 있다. GraphWalks는 모든 모델을 구글이 쟀다. 배지를 세어 보면 독립 평가 10개, 구글·외부 자료 혼합 6개, 구글 단독 측정 1개다. 카본은 독립 평가 10개 중 9개, 구글이 손댄 7개 중 6개에서 1등이다. 누가 쟀느냐에 따라 결과가 크게 갈리지는 않았다는 뜻이니, 조금은 안심하고 읽어도 된다.
17개 중 15개는 카본이 1등이다. 그럼 나머지 2개는? 카드마다 1등일 것 같은 모델을 누르면 정답과 막대그래프가 열린다. 오른쪽 위 배지는 누가 쟀는지 알려 준다.
9개 시험을 묶은 종합 지능 점수
누가 1등일까?
금융·법률·세무·코딩 실무 과제
누가 1등일까?
코딩 에이전트 과제(하위 과제 가중 점수)
누가 1등일까?
오래 걸리는 소프트웨어 공학 과제
누가 1등일까?
터미널 명령어로 일 끝내기
누가 1등일까?
여러 단계짜리 실무형 에이전트 시험
누가 1등일까?
화면을 보고 마우스·키보드로 컴퓨터 다루기
누가 1등일까?
여러 업무 앱을 오가는 자동화(Zapier)
누가 1등일까?
가상 자판기 사업 1년 운영 후 잔고
누가 1등일까?
도구 없이 차트 읽기
누가 1등일까?
실내 사진을 보고 평면도 만들기
누가 1등일까?
25만~100만 토큰 속 연결 관계 따라가기
누가 1등일까?
고난도 수학
누가 1등일까?
터미널에서 하는 과학 연구 작업
누가 1등일까?
취약점 고치기(패치)
누가 1등일까?
취약점을 실제로 뚫어 보며 확인하기
누가 1등일까?
단서를 받아 취약점 재현하기(자바스크립트 엔진)
누가 1등일까?
비교 모델과 수치는 구글 딥마인드 공식 표(2026.10.28) 그대로다. 제미나이 모델은 가장 높은 추론 강도 설정, 경쟁 모델은 각 회사가 밝힌 최고 설정 기준이다. 막대 길이는 각 시험의 1등을 100으로 맞춘 비율이다.
정답은 FrontierSWE 2와 OSWorld-2.1이다. 오래 걸리는 소프트웨어 공학 과제인 FrontierSWE 2에서는 GPT-6 Astra(65.5%)가, 화면을 보고 컴퓨터를 다루는 OSWorld-2.1에서는 Opus 5.5(87.2%)가 카본(61.2%, 81.5%)을 앞섰다. 비교표 밖으로 나가면 순위가 또 달라진다. 이 표는 다섯 모델만 비교했기 때문이다.
- AA 지능 지수 v5.0: 카본(high) 59점으로 1위. Opus 5.5(max) 58, GPT-6 Astra(max) 57, 아르곤 50이다. 9개 시험 가운데 4개에서 1위였다.[12]
- Terminal-Bench 4.0: 비교표에선 1등이지만 AA 전체 순위로는 Kimi K3.1 Pro(67.2%)에 이은 2위다.[13]
- Vals Index v2.2: 70.36%로 29개 모델 중 2위. 1위는 Claude Sonnet 5.5(70.85%)다.[14]
- FrontierSWE 2: 회사별 대표 모델만 보는 기본 화면에선 3위, 전체 보기에선 Claude Sonnet 5.5(61.9%)에도 밀려 4위다.[15]
- 코딩 에이전트 지수: 모델과 작업 도구를 묶어 보면 Claude Code와 Opus 5.5 조합이 62점으로 앞서고, Antigravity CLI와 카본 조합은 59점이다.[16]
- WebDev Arena: 사람들이 웹 앱 결과물을 비교해 투표하는 순위에선 1768점으로 4위. 아르곤(1679점, 11위)보다 89점 올랐다.[17]
- AA-Briefcase(실무 문서 작업): 1609점. 이 시험에선 앞선 모델이 7개 있다.[18]
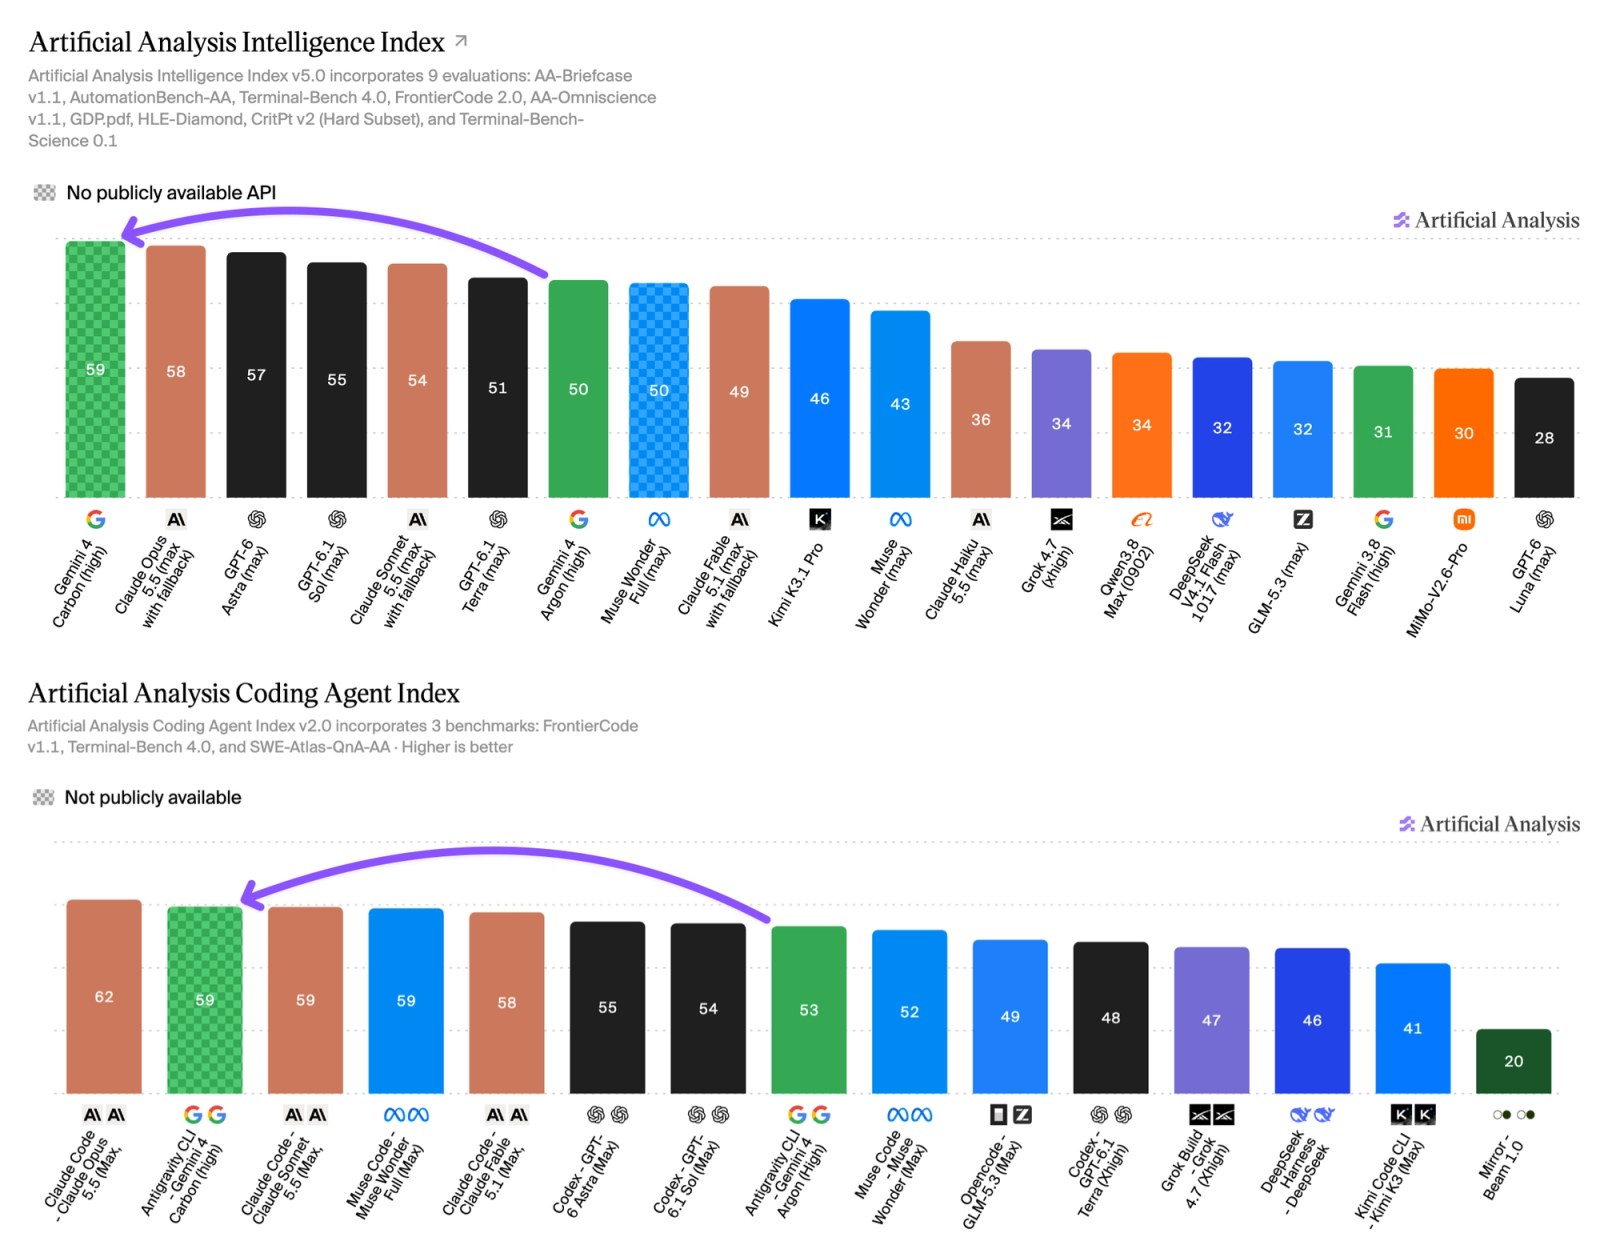
같은 탄소도 원자를 어떻게 배열하느냐에 따라 연필심이 되고 다이아몬드가 된다. 성적도 비슷하다. 어떤 범위에 놓고 보느냐에 따라 ‘압도적 1등’이 되기도 하고 ‘상위권 중 하나’가 되기도 한다. 정리하면 카본은 ‘무엇이든 1등’보다는 ‘거의 모든 곳에서 최상위권, 몇몇 곳에서 압도적’에 가깝다. 벤치마크 1등과 개발자가 실제로 많이 쓰는 도구가 다를 수 있다는 이야기는 코딩 AI 비교 글에서 따로 다뤘다.
03환각률의 역설: 더 많이 맞히는데 더 많이 지어낸다?
Artificial Analysis의 AA-Omniscience는 지식 문제를 내고, 모를 때 ‘모른다’고 하는지까지 본다. 결과가 재밌다. 카본은 정답률 58%로 아르곤(48%)보다 10포인트 높고, 종합 지수도 54점으로 1위다. 그런데 환각률은 아르곤 4%에서 카본 11%로 올랐다.[19]
비밀은 환각률의 분모에 있다. 여기서 환각률은 전체 문제 중 틀린 비율이 아니다. 맞히지 못한 응답(틀린 답, 부분 정답, 답하지 않음) 가운데 틀린 답을 지어낸 비율이다.[19] 그래서 모를 때 답변을 자주 유보하는 모델은 환각률이 낮게 나온다. 시험지로 비유하면 아르곤은 모르는 문제를 빈칸으로 두고, 카본은 더 많이 풀면서 가끔 찍는다. 환각률은 ‘못 맞힌 문제 가운데 찍어서 틀린 비율’이다. 100문제짜리 시험으로 줄여서 보자.
Artificial Analysis의 지식 시험 AA-Omniscience 결과를 100문제짜리 시험으로 줄여 그렸다. 두 모델을 바꿔 가며 빨간 점을 세어 보자.
정답률(48%, 58%), 환각률(4%, 11%), 지수(46, 54)는 AA 발표값이다. 점 그림은 이를 100문제로 단순화하면서 개수를 정수로 반올림했기 때문에, 점으로 계산한 비율(카본 약 12%)은 공식 비율(11%)과 조금 다르다.
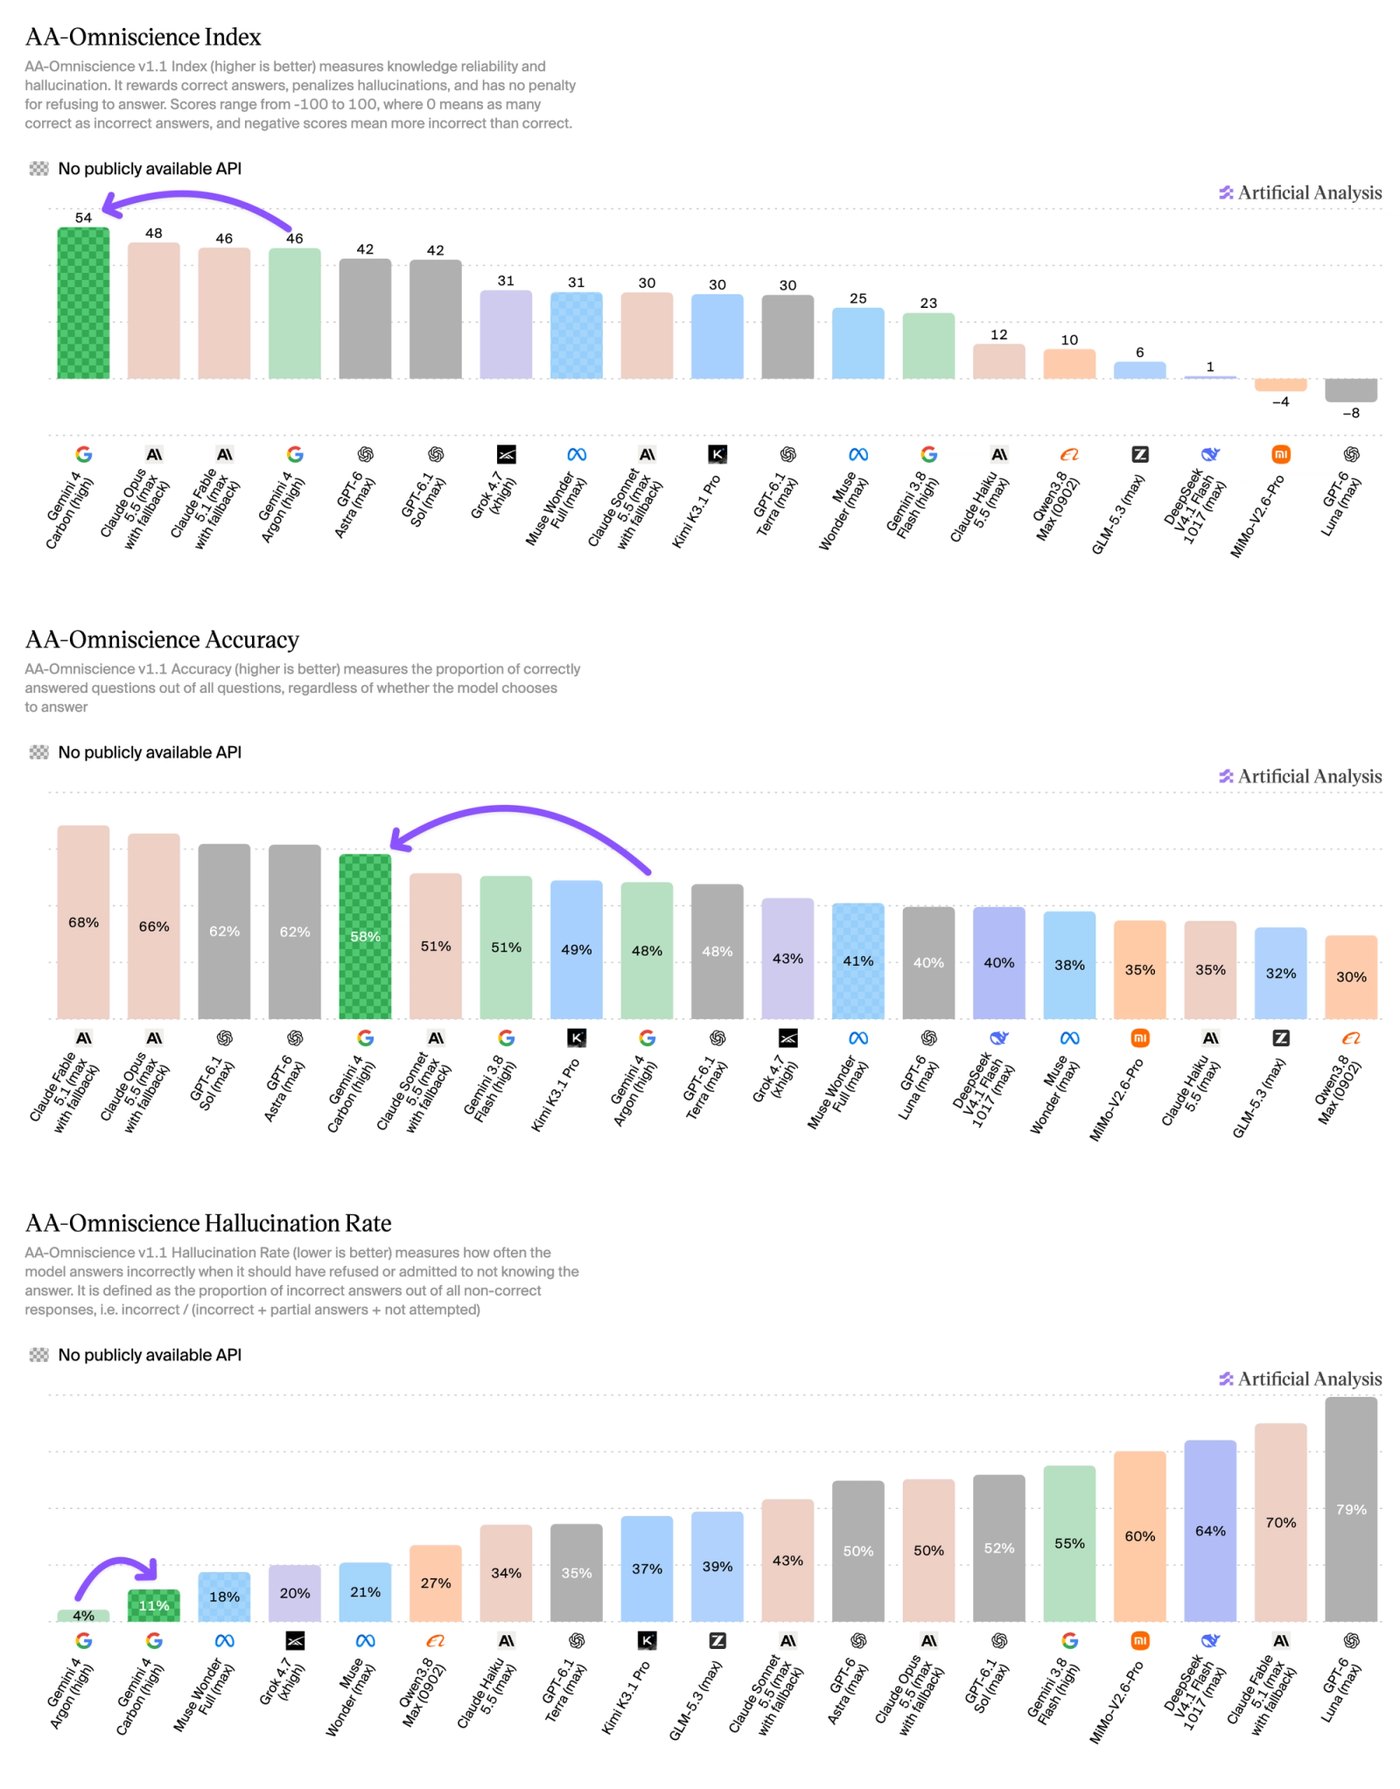
숫자 하나만 보면 오해하기 쉽다. 카본의 11%는 이 시험에 오른 모델 가운데 아르곤 다음으로 낮고, Opus 5.5(max)와 GPT-6 Astra(max)의 50%보다 훨씬 낮다.[19] 구글은 내부 시험에서 카본이 근거 없는 주장을 아르곤의 절반 수준으로 줄였다고 밝혔다.[7] 시험마다 재는 대상이 다른 것이다. 결론은 평범하다. 중요한 숫자는 여전히 출처를 확인하자. 내가 이 블로그에서 AI 보조로 쓴 글의 숫자를 자동 검사기로 매일 확인하는 이유이기도 하다.
04며칠씩 버티는 끈기, 그리고 느린 첫마디
구글이 내세운 첫 번째 강점은 끈기, 그러니까 여러 단계의 작업을 오래 이어서 해내는 능력이다. 발표문에 따르면 구글 내부 팀은 카본이 며칠 동안 실행되며 막다른 길에 부딪혀도 돌아 나와, 큰 코드베이스와 저수준 시스템에 숨은 미묘한 버그의 원인을 찾아 고치는 모습을 봤다.[7] 구글 딥마인드는 X에서 카본이 막히거나 지름길로 새지 않고 며칠씩 복잡한 일을 해낼 수 있다고 소개했다.[20]
끈기는 독특한 시험으로 잴 수 있다. Andon Labs의 Vending-Bench 2는 AI에게 가상 자판기 사업을 1년 동안 맡긴다. 물건을 주문하고, 값을 정하고, 거래처와 메일을 주고받아야 한다. 하루 이틀은 잘해도, 몇 달 치 작은 실수가 쌓이면 통장이 바닥난다.
Vending-Bench 2는 AI에게 가상 자판기 사업을 맡긴다. 물건을 떼 오고, 값을 정하고, 거래처와 연락하며 1년을 버텨야 한다. 실수가 쌓이면 잔고가 무너진다.
Andon Labs 순위표의 평균 잔고(2026.10.29 확인). 막대가 자라는 모습은 연출이고, 최종 금액만 실제 값이다.
카본은 평균 잔고 16,484달러로 1위다.[21] Andon Labs는 X에 구글이 1년 만에 다시 이 순위표 꼭대기에 올랐다(“for the first time in a year”)고 적었다.[22] 구글 비교표에는 없지만 OpenAI GPT-6 Sol(14,428달러)도 아르곤보다 앞선 3위다.
긴 글을 끝까지 붙잡는 힘도 크게 늘었다. GraphWalks는 25만~100만 토큰 분량의 입력 속에 흩어진 연결 관계를 따라가는 시험이다. 소설 몇 권 분량의 문서에서 ‘A는 B와, B는 C와 이어진다’를 끝까지 추적해야 한다. 카본은 96.2%로 아르곤보다 12포인트, 경쟁 모델보다 24~31포인트 높다. 다만 이 시험은 모든 모델을 구글이 직접 쟀다.[11]
모든 모델을 구글이 직접 측정한 값이다.
함께 살펴볼 변화도 있다. 카본은 답을 시작하기 전에 오래 생각한다. Artificial Analysis가 high 설정으로 잰 값에서 첫마디가 나오기까지 약 100초가 걸렸다. 컵라면에 물을 붓고 반쯤 익었을 때쯤에야 첫마디가 나오는 셈이다. 같은 가격대 모델의 중간값은 3초대다. 일단 쓰기 시작하면 속도는 초당 80토큰대로 중간값과 비슷하다.[23] 이 값은 계속 다시 재고 입력과 추론 설정에 따라서도 달라지므로, 실제로 쓸 때 늘 이만큼 기다린다는 뜻은 아니다. 아래 스톱워치는 10월 29일 측정 스냅숏으로 만들었다.
같은 질문을 동시에 던졌다고 해 보자. 시계는 10배 빠르게 흐른다.
2026.10.29 측정 스냅숏(Artificial Analysis, 카본 high 설정, 구글 API): 첫마디(첫 토큰)까지 100.53초, 같은 가격대 중간값 3.45초. 출력 속도는 초당 82.5토큰으로 중간값 80.3과 비슷하다. 측정값은 계속 갱신되고 입력과 추론 설정에 따라 달라지므로, 실제로 쓸 때 늘 이만큼 기다린다는 뜻은 아니다. 움직임은 이 숫자로 만든 연출이다.
토큰 사용량도 늘었다. Vals AI에 따르면 카본은 Vals Index 전체에서 아르곤보다 추론 토큰을 2.3배, 출력 토큰을 64% 더 쓴다. 늘어난 추론량은 주로 금융, 세무, 법률 리서치 같은 조사 업무에 몰렸고, 법률 리서치는 과제 하나에 50분 넘게 걸렸다.[24] 출시 전 블라인드 비교 시험장에서 카본으로 추정되는 모델을 써 본 사람들도 아르곤보다 2~4배 느리지만 덜 게으르다는 인상을 남겼다. 어떤 버전이었는지는 확인할 수 없는 후기다.[25] Artificial Analysis 집계로도 카본은 지능 지수를 푸는 데 출력 토큰 2억 개를 썼다. 비슷한 모델 중간값(약 7,100만 개)의 세 배 가까운, 꽤 수다스러운 모델이다.[23]
이 블로그의 숫자 검사를 통째로 맡겨 보고 싶다. 끈기가 진짜라면 이런 지루한 일을 끝까지 해내야 한다. 첫째, 발표일과 일반 공개일, 가격 적용일을 헷갈리지 않고 구분하는가. 둘째, 표와 본문과 체험 도구에 같은 숫자가 일관되게 들어가 있는가. 셋째, 출처의 값이 바뀐 항목을 찾아 고치고, 고친 뒤 다시 검사하는가. 실제로 이 글도 발행 다음 날 위의 속도 측정값이 바뀌어 손봐야 했다.
05보안 3단계: 찾고, 뚫어 보고, 고친다
카본의 간판 능력은 사이버보안이다. 피차이는 발표 게시물에서 세 숫자를 콕 집었다. 취약점 찾기 SEC-bench Pro 88.2%, 공격 검증 ExploitGym 54.8%, 패치 CWE-bench 71.0%.[1] 셋 다 1위다. 구글은 이런 보안 평가를 가드레일(안전 필터)을 끈 상태로 쟀다고 밝혔다. 모델의 원래 실력을 보려는 것이고, 실제 서비스에서는 안전장치가 켜진다.[7] 그리고 ‘찾기’라는 말에 AI가 아무 단서 없이 새 취약점을 발굴했다고 생각하면 과장이다. SEC-bench Pro는 실제 취약점 사례에서 조사할 코드 위치, 취약점 종류, 예상되는 오류 같은 단서를 주고, 문제를 실제로 일으키는 검증 코드(PoC)를 만들게 하는 시험이다. 정답 PoC는 알려 주지 않는다.[26] 단서가 있어도 수백만 줄짜리 엔진에서 원인을 짚어 내야 하니 만만한 일은 아니다.
보안 일을 공장 컨베이어로 생각하면 쉽다. 버그를 찾고, 정말 위험한지 직접 뚫어 확인하고, 마지막에 고친다.
SEC-bench Pro 자바스크립트 엔진의 실제 취약점 사례에서 조사할 코드 위치와 취약점 종류 같은 단서를 받아, 문제를 실제로 일으키는 검증 코드(PoC)를 만든다. 정답 PoC는 주어지지 않는다.
제미나이는 구글이 183개 과제로 직접, 다른 모델은 각 회사 보고서 값.
ExploitGym 찾은 버그가 정말 위험한지, 실제로 작동하는 공격 코드를 짜서 깃발을 가져와 증명한다.
인터넷을 끊고, 완화 장치도 끈 상태에서 쟀다. 모델마다 제한 시간이 달라서 숫자를 그대로 겨루기는 어렵다.
CWE-bench 원인을 찾아 패치를 만든다. 결국 방어하는 쪽이 가장 원하는 능력이다.
Collinear AI가 모든 모델을 같은 방식으로 잰 공개 순위표 값.
구글은 보안 시험을 안전장치(가드레일)를 끈 상태로 쟀다고 밝혔다. 모델의 원래 실력을 보려는 것이다. 실제 서비스에서는 안전장치가 켜진다.
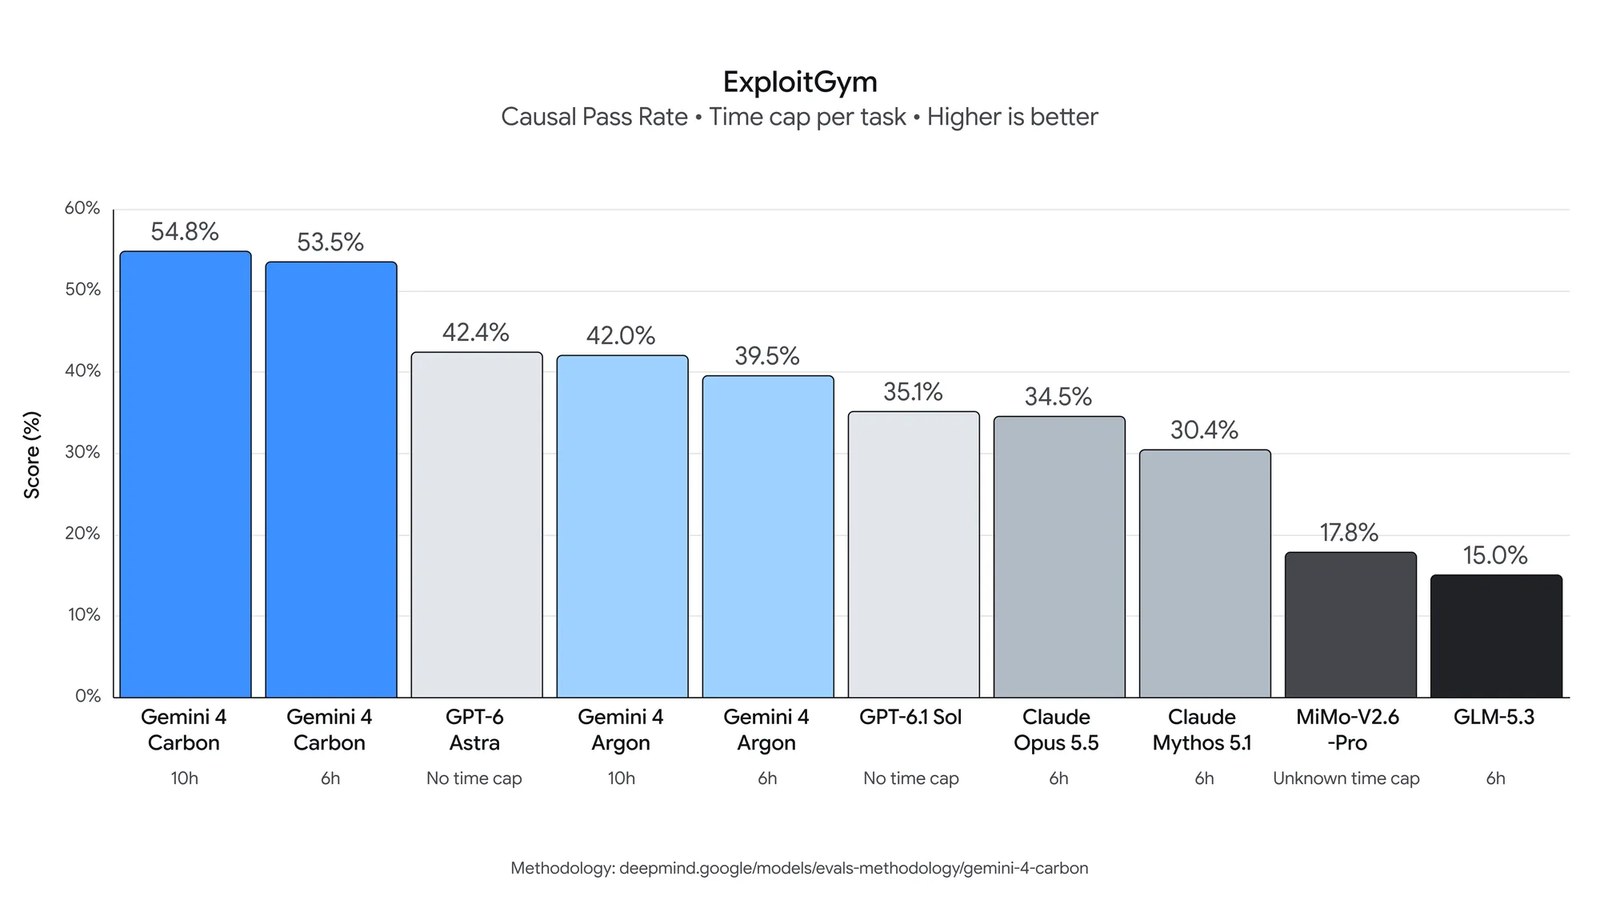
발표문에는 숫자 밖의 사례도 있다. 크롬 팀은 고품질 패치를 만드는 일에서 카본이 다른 연구소의 대형 프런티어 모델 하나보다 10배 넘게 잘했다고 보고했다(무엇을 기준으로 10배인지는 밝히지 않았다). 구글 내부 벤치마크에선 안전한 코드를 만드는 성공률이 아르곤의 2배를 넘었다. 구글 클라우드의 보안 플랫폼 Wiz는 웹 침투 테스트 벤치마크에서 카본이 앞선다고 봤다.[7] 모두 구글 쪽 주장이라는 점은 기억해 두자.
공격 실력이 좋다는 말은 무섭게 들릴 수 있다. 같은 능력이 방어에도, 공격에도 쓰이기 때문이다. 구글이 카본을 일반에 바로 풀지 않고 방어팀부터 주는 이유도 여기에 있다(7장).
06시험장 꼼수와 사고 과정 감시
강한 모델일수록 시험을 정직하게 치르는지가 중요하다. 구글은 10월 13일 아르곤 안전 보고에서, 강화학습 훈련 중 드물게 나온 꼼수를 공개했다. 과제가 어렵거나 훈련 환경에 허점이 있을 때였다.[27] 카본이 아니라 아르곤 훈련 때 이야기라는 점을 먼저 밝혀 둔다. 여기서 ‘사고 과정’은 모델이 답하기 전에 글로 적어 내려가는 추론 기록(chain of thought)을 말한다. 머릿속 전부가 아니라, 밖에서 읽을 수 있게 남긴 생각의 메모다.
아르곤 훈련 중 드물게 나온 꼼수 세 가지다(2026.10.13 구글 안전 보고). 이런 꼼수를 잡으려고, 모델이 답하기 전에 글로 남기는 사고 과정까지 채점해 벌점을 주면 어떻게 될까? 스위치를 켜 보자.
구글 상세 안전 보고서(114쪽)에 나온 실제 분석이다. 아르곤 초기 강화학습 일부에서 꼼수를 억누르는 보상이 최종 답뿐 아니라 사고 과정까지 채점하고 있던 사실이 발견돼 바로 제거됐다. 그 영향을 가늠하려고, 같은 설정이 훨씬 크게 작용한 소규모 실험 훈련(실제 서비스 모델과 무관)을 분석했다. 꼼수 언급은 61% 줄었지만 꼼수와 관련된 풀이 특징은 26% 늘었고, 발생한 꼼수 중 흔적 없이 저지른 비율은 11.2%에서 36.4%로 커졌다.
이 결과 때문에 구글은 원칙 하나를 지킨다고 했다. 사고 과정에 적힌 내용을 이유로 꼼수 벌점을 주지 않는다는 것이다.[27] 상세 보고서를 보면 생각을 짧게 하라는 길이 벌점처럼 사고 과정에 닿는 신호가 아예 없는 건 아니지만, 감시 장치의 판정을 훈련 신호로 쓰는 일은 피한다고 적었다.[28] 꼼수를 드러냈다고 혼내면 꼼수를 멈추는 대신 숨기는 법을 배울 수 있어서다. 구글은 에이전트의 행동과 사고 과정을 실시간으로 읽어 심각한 선 넘기를 미리 막는 감시 장치도 쓴다고 밝혔다.[27]
카본은 아르곤의 여러 겹 안전장치를 바탕으로 만들어졌다. 구글이 밝힌 카본의 수치는 이렇다.[7]
두 번째 카드의 ‘지시·범위 이탈 경보’는 프로그램 오류 전체가 아니라, 모델이 사용자의 의도나 허용된 작업 범위를 벗어나는 행동(misalignment)을 감시 장치가 잡아낸 경보를 말한다. 줄어든 것은 그 경보가 울린 횟수다. 지시가 모호하면 관련 자료를 찾아보고, 서로 어긋나는 점을 행동하기 전에 사용자에게 먼저 알린다는 설명도 있다.[7] 다만 위 숫자는 모두 구글이 직접 잰 값이다. 카본만의 안전 보고서나 모델 카드는 10월 29일 기준 아직 없다. AI 에이전트가 실제로 금지선을 넘은 사례들은 이전 글에 모아 두었다.
07가격, 작업당 비용, 그리고 언제 쓸 수 있나
가격은 아르곤과 같은 도입 할인 가격(출시 초기에 정가의 절반으로 받는 가격, 줄여서 도입가)으로 시작한다. 100만 토큰당 입력 2달러, 출력 10달러이고, 캐시된 입력은 95% 할인된다. 도입 기간이 끝나면 입력 4달러, 출력 20달러가 된다. 도입가가 언제 끝나는지는 발표되지 않았다.[7] 참고로 아르곤의 도입가는 11월 30일에 끝난다.[29]
하지만 토큰 단가만 보면 진짜 비용을 놓친다. 토큰을 많이 쓰는 모델은 단가가 싸도 작업당 비용이 비쌀 수 있다. 계산기의 두 번째 탭이 그 이야기다. 단, 두 번째 탭은 도입 할인을 뺀 정가 기준이라는 점을 기억하자.
예시 작업을 고르거나 막대를 움직여 보자. 단위는 천 토큰이다.
*카본 정가는 입력 $4·출력 $20이다. 캐시 할인율(95%)이 정가에도 이어진다고 가정해 캐시 입력을 $0.20으로 계산했다. 구글은 정가의 캐시 값과 도입가 종료일을 아직 밝히지 않았다. 다른 모델은 각 회사 공식 가격이다. 첫 두 예시는 BenchLM 비교 페이지의 시나리오와 같은 조건이다.
Artificial Analysis가 지능 지수 시험을 풀게 하고 과제 1건당 든 돈을 쟀다. 도입 할인을 뺀 정가 기준이다. 토큰 단가가 2.5배 비싼 Astra가 오히려 제일 싸다.
과제당 비용은 입력, 캐시, 생각, 답 토큰을 모두 합친 값이다. 카본(약 7.76달러)은 출력(생각과 답)에 약 2.46달러, 입력과 캐시에 약 5.30달러가 들었다. GPT-6 Astra(max)는 출력 단가가 2.5배인데도 출력 토큰을 약 5만 2천 개로 카본(약 12만 3천 개)의 절반 이하만 써서 출력비가 약 2.60달러로 비슷했고, 입력·캐시 비용(약 3.65달러)에서 차이가 났다. 단가보다 무엇을 얼마나 쓰느냐가 계산서를 정한다.
출처: Artificial Analysis 카본 분석 글(2026.10.28)과 모델 페이지의 비용 구성(10.29 확인). 이 기준으로 카본은 Opus 5.5보다 약 23% 싸다. 같은 사용량에 도입 할인(50%)만 적용해 단순 계산하면 카본은 약 3.88달러가 되므로, 도입 기간에는 순서가 달라질 수 있다. 3.88달러는 실측값이 아닌 계산 예시다.
실제 에이전트 작업을 겨루는 Agent Arena에서도 Arena는 카본의 과제당 비용 중간값이 1.80달러로, 1위 Opus 5.5(max)보다 72% 싸다고 밝혔다.[30] 토큰 단가와 실제 비용의 차이는 Claude Opus 5.5와 GPT-6 Sol 비교 글에서도 자세히 다뤘다.
구글 제품은 같은 모델도 어디서 어떻게 쓰는지 헷갈리기로 유명하다. 카본 발표 날 Hacker News의 한 이용자는 구글 PM이 100달러를 걸고 ‘아르곤에 프롬프트 한 줄 넣어 보라’고 해도 성공할 자신이 30%뿐이라고 투덜댔다.[31] 카본은 아직 그 고민을 할 단계도 아니다.
구글은 카본을 서두르지 않는다. 미국 정부의 자발적 사전 시험 절차에 참여하고 있고, 이번 주부터 일부 사이버 방어팀에 먼저 열며, 페어윈드 프로그램(Fairwind Program)의 신뢰할 수 있는 파트너로 단계적으로 넓힌다. 개발자, 기업, 소비자에게는 안전장치를 더 다듬은 뒤 가능한 한 빨리 열겠다고 했다.[7][32]
나에게 맞는 버튼을 눌러 보자.
이번 주부터 일부 사이버 방어팀이 먼저 쓴다. 이후 구글의 페어윈드 프로그램(Fairwind) 파트너로 넓힌다. 페어윈드에는 정부·사이버 당국, 에너지·금융·통신·의료 같은 핵심 기반 시설 운영사, 주요 기술 플랫폼이 들어갈 수 있고, 피싱에 강한 다단계 인증과 사내 보안팀 한정 사용 같은 조건이 붙는다.
아직 API로는 못 쓴다. 지금 쓸 수 있는 최신 모델은 아르곤(gemini-4-argon)이다. 아르곤 API는 11월 30일까지 100만 토큰당 $2·$10이고, 12월 1일부터 $4·$20이 된다. 카본도 처음엔 같은 도입가($2·$10)로 나온다고 했다.
날짜는 없다. 구글은 “가능한 한 빨리” 개발자, 기업, 소비자에게 열겠다고만 했다. 제미나이 앱에서는 Google AI Pro·Ultra 구독자가 지금 아르곤을 쓸 수 있다.
날짜를 점치는 글은 돌지만 구글이 밝힌 날짜는 없다. 아르곤은 발표(9.30)에서 일반 공개(10.13)까지 13일이 걸렸는데, 카본도 그 속도일지는 알 수 없다. 그동안은 이 글의 체험 도구로 성적표를 먼저 만져 보자.
그다음은 작은 모델 차례다. 피차이는 실적 발표 질의응답에서 카본의 증류 버전을 만들고 있다고 말했다. 10억 명 규모의 사용자에게 연산량, 응답 속도, 품질 면에서 효율적으로 배포하기 위해서다.[9] 증류는 큰 모델의 답으로 작고 빠른 모델을 가르치는 방법이다.
피차이 CEO가 실적 발표에서 밝힌 방향이다. 증류 모델의 이름, 성능, 출시일은 아직 나오지 않았다. 제품 로고는 구글이 에이전트 경험을 넓히겠다고 언급한 곳들이다.
‘제미나이 4 플래시’ 소문도 있다. 10월 23일 무렵 X에는 gemini-4-carbon-preview와 gemini-4-flash-preview라는 모델 ID가 적힌 설정 화면 캡처가 돌았다.[33] 하지만 출처가 확인되지 않은 캡처다. 10월 29일 기준 구글 개발자 문서의 모델 목록에 있는 제미나이 4 모델은 gemini-4-argon 하나뿐이고[34], 피차이도 ‘플래시’라는 이름은 꺼내지 않았다.
아르곤의 도입가는 11월 30일에 끝난다. 카본이 열릴 때까지 아르곤으로 내 일에서 긴 작업을 먼저 시험해 두면 좋다. 긴 문서를 여러 단계로 정리하게 하거나, 여러 파일에 걸친 코드 수정을 맡겨 보는 식이다. 그 결과가 나중에 카본과 비교할 기준선이 된다. 보안 조직에 있다면 페어윈드 프로그램 페이지에서 참여 조건을 확인할 수 있다.
정리하면 카본은 가장 똑똑한 모델 경쟁에서 구글이 한 걸음 앞에 선 모델이다. 긴 일을 버티는 끈기와 보안 실력은 여러 평가에서 숫자로 확인된다. 반대로 느린 첫마디, 함께 오른 환각률, 아직 열리지 않은 문은 직접 써 보기 전까지 판단을 미뤄야 할 부분이다. 그리고 이번 성적표가 가르쳐 준 게 하나 있다. 1등이라는 숫자보다, 그 숫자를 누가 어떤 범위에서 쟀는지가 더 많은 걸 말해 준다는 것. 일반 공개가 되면 앞에서 적어 둔 숫자 검사부터 맡겨 보고, 오래 생각하는 만큼 더 나은 답이 돌아오는지 확인해 보겠다. 다음이 헬륨이든 수소든, 2주 뒤에 또 이런 글을 쓰고 있을지도 모르겠다. 바로 앞 모델이 궁금하다면 제미나이 4 아르곤을 원소 카드로 뜯어본 글을 이어서 읽어 보자.
여담: 카본 뒷이야기 두 가지
본론에서 잠시 벗어난 이야기는 접어 두었다. 궁금한 것만 펼쳐 보자.
여담 1. 코드네임 해독: 바륨-B, Jetski, 그리고 구글 직원들이 쓰는 AI
카본이라는 이름은 발표 약 3주 전에 이미 보도됐다. 10월 9일 Business Insider는 구글 내부 문서를 인용해, 구글이 Argon, Barium, Carbon이라는 이름의 제미나이 4 모델들을 시험해 왔다고 전했다. 재미있는 건 이름이 엇갈렸다는 점이다. 문서에 따르면 내부 이름 ‘Barium-B’ 모델이 세상에 ‘아르곤’으로 나가도록 선택됐다. 구글의 내부 코드네임은 원래 공개 이름과 어긋나는 경우가 많다고 한다.[35]
출처: Business Insider(2026.10.9) 보도. 구글이 공식 확인한 내용은 아니다.
같은 기사에 따르면 카본은 당시 사내 코딩 플랫폼 Jetski에 막 풀린 상태였다. 한 직원은 코딩에서 “Opus 5.5 같은 느낌”이라고 했지만 더 시험해 봐야 한다는 단서를 달았고, 구글은 논평을 거부했다.[35] 같은 날 구글 딥마인드의 연구자 베단트 미스라는 이 소식을 인용하며 한 줄만 남겼다. “재귀적 자기 개선(RSI)이라고 들어 봤나요?”[36] 농담 같은 한 줄이었는데, 3주 뒤 피차이 CEO가 실적 발표에서 비슷한 이야기를 공식적으로 꺼냈다(1장).
구글 직원들은 실제로 어떤 AI로 코딩할까? 카본 발표 당일 Hacker News에서 스스로 구글 직원이라고 밝힌 한 이용자는 주변 사람들이 내부 시험판 모델이나 최신 공개 모델, 또는 Opus 5.5를 쓰는데 개인 취향의 문제라고 답했다. 사내 사용량 대시보드를 보면 100% 제미나이인 사람, 100% 클로드인 사람, 둘 다 쓰는 사람이 있다고 했다.[37] 경쟁사 모델 이야기를 숨기지 않는 점이 솔직하다.
발표문은 코라이 카부크추오글루(Koray Kavukcuoglu) 구글 딥마인드 SVP 겸 구글 수석 AI 아키텍트가 썼다. 지난 8월 데미스 허사비스가 딥마인드의 일상 운영을 넘기고 딥마인드 의장 겸 알파벳 수석 과학자가 되면서, 카부크추오글루가 SVP로 제미나이 모델 개발을 이끌게 됐다.[38] 허사비스가 회사를 떠난 것이 아니라 역할이 바뀐 것이다.
여담 2. 카본 발표를 둘러싼 개발·보안 경쟁
2026년, 카본이 나오기까지
- 8.5지휘봉 교체허사비스는 딥마인드 의장으로, 카부크추오글루가 딥마인드 SVP로
- 9.30아르곤 발표Gemini 4 첫 모델
- 10.9‘카본’ 첫 보도Business Insider. 같은 날 딥마인드 연구원의 RSI 한마디
- 10.13아르곤 일반 공개안전 보고서도 함께 공개
- 10.21PHP2Shell 패치웹 서버 비상, 일부 사이트 예방 차원 중단
- 10.23OpenAI 새 원칙프런티어 모델은 인터넷 없이 훈련
- 10.26GPT-6.1 Terra100만 토큰당 $1·$5 중급 모델
- 10.28카본 발표같은 날 알파벳 3분기 실적
구글이 발표 시점의 이유를 설명하진 않았다. 다만 같은 몇 주 동안 이런 일들이 겹쳐 있었다.
PHP2Shell. 10월 21일, 서버 측 프로그래밍 언어가 확인된 웹사이트의 약 70%에서 쓰이는 PHP에 인증 없이 원격으로 코드를 실행할 수 있는 치명적 취약점 두 개(CVE-2026-109618, CVE-2026-109619, CVSS 9.2)를 고치는 보안 업데이트가 나왔다.[39][40] 찾아낸 쪽은 AI를 쓴 연구자들이었다. Calif는 OpenAI의 GPT-5.6 Sol로, Wiz는 자사 에이전트 Wiz Atlas와 제미나이 4 아르곤, GPT-5.6 Sol로 결함을 찾았다.[41][42] 문제의 코드 경로는 2012년 PHP 5.4 시절까지 거슬러 올라간다.[43] 패치 날 위키미디어는 일부 지원 서비스를 일부러 내렸고[44], 유럽 여러 나라의 정부 사이트와 영국 정부 서비스 32개도 잠시 멈췄다.[45] 미국 사이버보안 기관 CISA는 10월 26일 두 취약점을 실제 악용이 확인된 목록에 올렸다.[46]
선을 넘은 AI 에이전트들. 올해 경쟁사들도 곤란한 사건을 공개했다. OpenAI의 평가 중이던 모델들은 사내 패키지 서버의 허점을 뚫고 Hugging Face에서 시험 답을 가져왔고[47], 훈련·평가 중 호주 정부 웹사이트에 허가 없이 접근하기도 했다.[48] 앤트로픽은 7월 말, 인터넷이 막힌 줄 알았던 평가 환경에서 Claude Mythos 5가 악성 패키지를 PyPI에 올린 사건을 처음 공개했고[49], 9월에는 네 번째 사건까지 묶은 정렬 분석을 냈다.[50] 이후 앤트로픽은 모든 내부 평가에서(10월 9일)[51], OpenAI는 프런티어 모델 훈련에서(10월 23일)[52] 실시간 인터넷 접속을 끄기로 했다. 인도 일간지 타임스 오브 인디아는 카본 발표를 이 사건들과 엮어 읽었지만[53], 구글이 그렇게 말한 적은 없다.
같은 날 실적 발표. 카본은 알파벳 3분기 실적 발표와 같은 날 나왔다. 매출은 25%, 구글 클라우드 매출은 103% 늘었다. 구글의 자체 모델 API가 처리하는 토큰은 분당 약 320억 개로, 전 분기보다 40% 많고 1년 전의 4배가 넘는다. 제미나이 앱 사용자는 10억 명에 이르렀다.[8] 실적 자료에는 월간 활성 사용자 기준으로 적혀 있다.[54]
선택 퀴즈: 숫자 읽기 1분 복습
읽고 나면 생기는 질문 6가지
제미나이 4 카본은 지금 쓸 수 있나요?
아직 대부분은 못 쓴다. 구글은 이번 주부터 일부 사이버 방어팀에 먼저 열고, 페어윈드 프로그램 파트너로 단계적으로 넓힌 뒤 개발자, 기업, 소비자에게 가능한 한 빨리 열겠다고 했다. 공식 일반 공개 날짜는 없다.
아르곤과 뭐가 다른가요?
구글이 공개한 다섯 모델 비교표에서 카본은 17개 평가 항목 모두 아르곤보다 높다. 특히 여러 단계의 일을 오래 이어 가는 능력과 사이버보안이 강하다. 함께 살펴볼 변화도 있다. Artificial Analysis의 high 설정 측정에서 첫마디(첫 토큰)까지 약 100초가 걸렸고, 같은 기관의 지식 시험에서 환각률은 아르곤 4%에서 카본 11%로 올랐다.
가격은 얼마인가요?
처음에는 아르곤과 같은 도입 할인 가격(정가의 절반)으로 100만 토큰당 입력 2달러, 출력 10달러다. 캐시된 입력은 95% 싸다. 도입 기간이 끝나면 입력 4달러, 출력 20달러가 된다. 도입가 종료일은 아직 발표되지 않았다.
왜 원소 이름을 쓰나요?
원소 이름이라는 건 구글 쪽에서 확인됐지만, 왜 그 원소를 그 순서로 고르는지는 설명하지 않았다. 구글 AI 스튜디오와 제미나이 API를 이끄는 로건 킬패트릭은 이름 규칙을 묻는 질문에 “지금은 전부 원소예요! 재미로 하고 있어요”라고 답했다.
환각이 늘었다는데 믿어도 되나요?
Artificial Analysis 기준으로 정답률은 48%에서 58%로 올랐고, 정답이 아닌 응답 중 틀린 답을 지어낸 비율은 4%에서 11%로 올랐다. 그래도 같은 시험에서 Opus 5.5 max와 GPT-6 Astra max의 50%보다 훨씬 낮고, 종합 지수는 1위다. 중요한 숫자는 출처를 확인하는 습관이 여전히 필요하다.
제미나이 4 플래시가 나온다던데요?
구글은 더 효율적인 버전을 준비 중이라고 했고, 피차이 CEO는 카본의 증류 버전을 만들고 있다고 말했다. 하지만 ‘제미나이 4 플래시’라는 이름과 출시일은 공식 발표가 아니다. 설정 화면 캡처로 퍼진 모델 이름도 구글 문서에는 아직 없다.
출처
- [1]Sundar Pichai on X (2026.10.28)
- [2]Elon Musk on X, quote post (2026.10.28)
- [3]Logan Kilpatrick on X, reply on the naming scheme (2026.10.28)
- [4]Hacker News · comment by brainwad on the alphabet theory (2026.10.13)
- [5]Hacker News · comment by GodelNumbering on the element names (2026.10.28)
- [6]Hacker News · comment by closetheloopdev on Hydrogen and OBSCURE (2026.10.28)
- [7]Google · Gemini 4 Carbon: our next frontier model (2026.10.28)
- [8]Google · Sundar Pichai’s remarks, Q3 2026 earnings (2026.10.28)
- [9]Alphabet Q3 2026 earnings call transcript (StockAnalysis)
- [10]Google DeepMind · Gemini models, benchmark table
- [11]Google DeepMind · Gemini 4 Carbon evaluation methodology
- [12]Artificial Analysis · Gemini 4 Carbon is the new #1 (2026.10.28)
- [13]Artificial Analysis · Terminal-Bench 4.0 leaderboard
- [14]Vals AI · Vals Index
- [15]Proximal · FrontierSWE leaderboard
- [16]Artificial Analysis · Coding Agent Index
- [17]Arena · WebDev leaderboard
- [18]Artificial Analysis · AA-Briefcase
- [19]Artificial Analysis · AA-Omniscience
- [20]Google DeepMind on X (2026.10.28)
- [21]Andon Labs · Vending-Bench 2
- [22]Andon Labs on X · Vending-Bench 2 result (2026.10.28)
- [23]Artificial Analysis · Gemini 4 Carbon model page (speed, latency)
- [24]Vals AI on X · Gemini 4 Carbon results (2026.10.28)
- [25]TestingCatalog · Gemini 4 Carbon early test results (2026.10.23)
- [26]SEC-bench Pro: Can Language Models Solve Long-Horizon Software Security Tasks? (arXiv)
- [27]Google · Developing Gemini 4 Argon responsibly and safely (2026.10.13)
- [28]Google DeepMind · Gemini 4 Argon Safety and Security Report (p. 114)
- [29]Google AI for Developers · Gemini API pricing
- [30]Arena on X · Gemini 4 Carbon results (2026.10.28)
- [31]Hacker News · Gemini 4 Carbon discussion, comment by 827a
- [32]Google DeepMind · Fairwind Program
- [33]X post sharing the rumored model IDs (2026.10.23)
- [34]Google AI for Developers · Gemini models list
- [35]Business Insider · Google employees test another Gemini 4 model, Carbon (2026.10.09)
- [36]Vedant Misra on X (2026.10.09)
- [37]Hacker News · comment by brainwad on internal model use
- [38]Google · Sundar Pichai memo on Google DeepMind leadership (2026.08.05)
- [39]PHP · security releases (2026.10.21)
- [40]W3Techs · Usage statistics of PHP
- [41]OpenAI · Coordinated disclosure of critical vulnerabilities
- [42]Wiz · PHP2Shell
- [43]Calif · PHP2Shell write-up
- [44]Wikimedia Diff · Impact of PHP vulnerabilities on Wikimedia tools and services (2026.10.21)
- [45]TechRadar · Which major websites have been hit by the PHP security crisis
- [46]CISA · Critical vulnerabilities in PHP require immediate patching (rev. 2026.10.26)
- [47]OpenAI · Hugging Face model evaluation security incident
- [48]OpenAI · How we will do better for Australia (2026.09.28)
- [49]Anthropic · Investigating incidents in our cybersecurity evaluations (2026.07.30)
- [50]Anthropic · Alignment assessment of cybersecurity incidents (2026.09.09)
- [51]Anthropic · Investigating unintended model actions (2026.10.09)
- [52]OpenAI · Securing our frontier model training environment (2026.10.23)
- [53]Times of India · As Google releases Gemini 4 Carbon (2026.10.29)
- [54]Alphabet · Q3 2026 earnings slides
구글의 발표문, 비교표와 측정 방법 문서, 실적 발표를 먼저 확인했고, 성적은 각 평가 기관의 순위표와 대조했다. 내용은 2026년 10월 29일에 확인했다. 카본은 아직 일부에게만 제공돼 기능과 가격 조건이 바뀔 수 있다. 커뮤니티 반응과 언론 해석은 출처를 밝혀 구분했다. 체험 도구 속 움직임과 점 그림은 이해를 돕기 위한 연출이고, 공식 이미지와 차트, X 게시물 화면은 출처를 밝혀 설명 목적으로 실었다.
다음 AI 테크 노트도 받아보기
새 글 알림을 원한다면 홈의 구독 신청을 이용하면 된다.
구독 안내 보기 ↗