AI가 쓴 글의 숫자, 자동 검사기로 한 달 지켜 보니: 진짜 오류 3건, 가짜 경보 9건기준표 하나와 규칙 21개로 만든 작은 사실 검사기. 무엇을 잡았고, 무엇을 놓쳤고, 왜 3주 동안 아무도 경보를 보지 않았는지 기록했다
이 블로그의 글에는 숫자가 많다. 모델 가격, 출시일, 사용 한도, 벤치마크 점수. AI로 초안을 쓰다 보면 이런 숫자가 그럴듯하게 틀리는 일이 생긴다. 엉뚱한 숫자가 나오는 경우보다, 맞는 숫자가 다른 모델이나 다른 날짜 옆에 붙는 경우가 더 많다.
그래서 2026년 9월 25일, 발행한 글을 매일 아침 자동으로 읽고 숫자를 기준표와 대조하는 검사기를 만들었다. 이 글은 그 뒤 한 달 동안의 기록이다. 검사기가 잡은 진짜 오류, 검사기가 틀린 가짜 경보, 그리고 경보가 3주 넘게 방치된 이유까지 숫자 그대로 적었다.
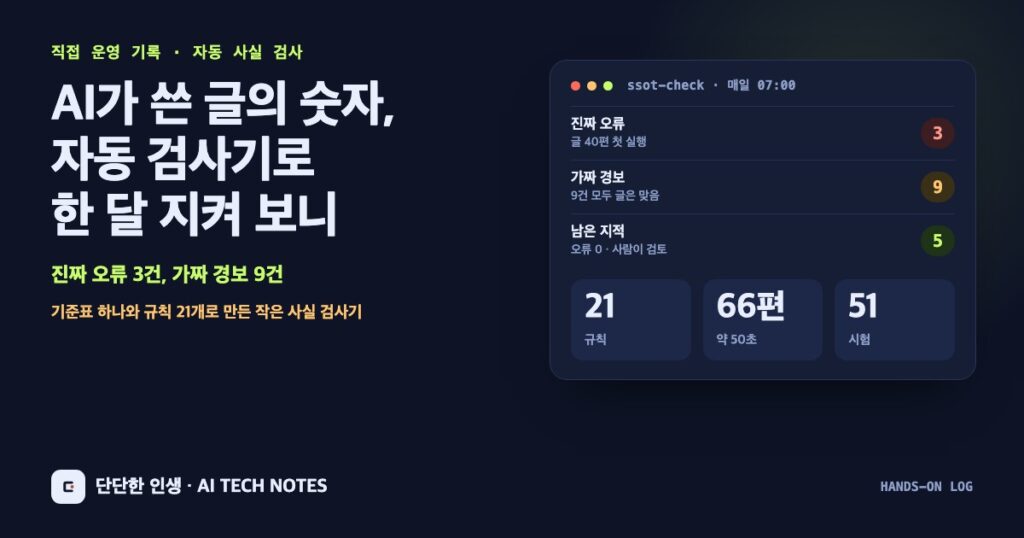
- 모델 가격·출시일을 한 파일(기준표)에 모으고, 글 속 숫자를 매일 대조하는 검사기를 만들었다. 첫 실행에서 글 40편 가운데 진짜 오류 3건을 찾았다.
- 그 뒤 9월 30일부터 경보 9건이 쌓였는데, 원문과 대조해 보니 9건 모두 글이 아니라 기준표와 검사기 쪽 문제였다. 그사이 경보는 3주 넘게 방치됐다.
- 기준표를 채우고 오경보 유형을 고친 뒤, 글 66편을 약 50초에 읽어 29건이던 지적이 5건(오류 0)으로 줄었다. 검사기는 후보를 고르고, 판단은 여전히 사람이 한다.
01왜 검사기가 필요했나
9월 말 기준으로 이 블로그에는 글이 40편 있었다. 같은 모델의 가격이 여러 글에 나오고, 회사가 가격을 바꾸면 그중 몇 편만 고쳐지는 일이 생겼다. 예를 들어 어떤 모델의 판매가 끝났는데, 한 글은 새 정보로 고쳐졌고 다른 두 글에는 옛 가격이 그대로 남아 있었다. 사람이 모든 글을 매번 다시 읽을 수는 없다.
그래서 역할을 나눴다. 숫자의 정답은 한 파일에만 적고, 기계는 매일 모든 글을 읽어 그 파일과 다른 숫자를 찾는다. 사람은 기계가 찾아낸 후보만 본다.
02구조: 기준표 하나, 규칙 21개, 매일 아침 7시
기준표. 모델마다 이름과 다른 표기, 100만 토큰당 입력·출력 가격, 출시일, 가중치 공개 여부, 그리고 그 값을 확인한 출처와 날짜를 적었다. 지금은 모델 25개와 사건 17개가 들어 있다. 한 항목은 대략 이런 모양이다.
"gpt-6-astra": {
  "aliases": ["GPT-6 Astra"],
  "open_weights": false,
  "api_price": { "input": [10], "output": [50], "cached_input": [1.0] },
  "cached_source": "OpenAI 모델 문서", "cached_checked": "2026-10-24"
}
규칙. 숫자 말고도 자주 틀리는 문장 유형이 있다. 그런 유형을 21개 규칙으로 만들었다. 몇 가지를 옮기면 이렇다.
- Claude Code의 /clear와 /compact는 대화 맥락을 정리할 뿐, 계정의 사용 한도를 되돌리지 않는다.
- 토큰 단가가 5분의 1이라고 같은 일을 5분의 1 비용에 끝내는 것은 아니다. 쓰는 토큰 수와 재시도 횟수가 다르다.
- AI가 내놓은 확신도는 참고 신호이지, 돈이나 계정을 움직여도 된다는 허가가 아니다.
- “위험이 없다”처럼 단정하는 표현은 “위험을 줄이도록 설계됐다”로 바꾸도록 표시한다.
실행. GitHub Actions가 매일 아침 7시(토론토 시간)에 검사기를 돌린다. 문제가 나오면 GitHub에 이슈를 열고, 결과를 표로 남긴다. 결과 표 맨 위에는 늘 같은 문장이 들어간다. “위반 0건은 등록된 규칙과 기준표 값에서 문제가 없었다는 뜻일 뿐, 규칙으로 만들지 않은 오류까지 없다는 보장은 아니다.”
03일부러 틀린 문장부터 만들었다
검사기를 실제 글에 돌리기 전에, 일부러 틀린 문장 17개와 맞는 문장 14개를 먼저 만들었다. 틀린 문장은 모두 잡아야 하고, 맞는 문장은 그냥 지나가야 한다. 이 시험이 통과하지 않으면 실제 글 결과도 믿을 수 없다.
여기서 첫 버그가 나왔다. 영어 모델 이름 바로 뒤에 한글 조사가 붙으면(예: “Sonnet 5는”) 검사기가 이름을 찾지 못했다. 파이썬 정규식의 단어 경계 기호가 한글도 글자로 취급해서, “5”와 “는” 사이를 경계로 보지 않았기 때문이다. 영어로만 시험했다면 놓쳤을 문제다.
재미있는 일도 있었다. 이 검사 구조의 처음 설계안은 다른 AI 도구가 써 준 것으로 보이는 제안서였는데, 그 설계안 자체에 틀린 사실이 세 개 있었다. 한 모델의 학습 비용을 다른 모델 것으로 적었고, 한 모델의 출시 시기를 석 달 잘못 적었고, 실제로는 쓸 수 없는 데이터 형식을 제안했다. 검사기를 만드는 단계부터 사실 확인이 필요했다.
04첫 실행: 글 40편에서 진짜 오류 3건
9월 25일 밤, 발행한 글 40편에 처음 돌렸다. 검사기가 찾은 것은 세 건이었다.
- 지난 가격. 이미 판매가 끝난 DeepSeek V4-Flash의 가격이 오픈웨이트 글 두 편(한·영)에 남아 있었다. 같은 블로그의 다른 글에는 이미 바뀐 정보가 실려 있어서, 글끼리 서로 어긋나 있었다.
- 출처 없는 숫자. Kimi K3의 출력 가격에 확인된 출처가 없었다.
- 지나친 단정. “후보 비교까지만 맡기면 결제 위험이 없다”는 문장이 있었다.
셋 다 그날 밤 고쳤다. 가격은 공식 요금 문서에서 다시 확인했고, 단정 표현은 범위를 좁혀 다시 썼다. 사람이 40편을 처음부터 다시 읽었다면 몇 시간이 걸렸을 일이다.
05가짜 경보 9건, 그리고 방치된 3주
9월 30일부터 검사기가 매일 실패로 끝나기 시작했다. 지적은 9건이었다. 매일 아침 실패 메일이 왔지만, 바쁜 날이 이어지면서 아무도 열어 보지 않았다. 10월 13일에는 사이트 보안 설정을 강화하면서 검사기가 글 본문을 아예 읽지 못하게 됐다. 이것도 실패 메일 속에 묻혔다. (경보 이야기 전체는 AI 에이전트에게 블로그 운영을 맡긴 한 달에 적었다.)
10월 24일, 9건을 원문과 하나씩 대조했다. 결과는 9건 모두 글의 숫자가 맞았다. 원인은 이랬다.
- 기준표가 모자랐다. 캐시를 쓸 때 할인되는 가격(예: Claude Fable 5.1의 캐시 읽기 100만 토큰당 0.25달러)이나, 평가 기관이 잰 과제 1건당 비용(예: 3.76달러)은 기준표에 칸이 없었다. 검사기는 기준표에 없는 숫자를 모두 ‘불일치’로 봤다.
- 숫자를 엉뚱한 모델에 붙였다. Grok 4.7을 다룬 문단 안에 비교 대상인 GPT-6.1 Sol의 숫자가 있었는데, 검사기는 그 숫자를 Grok 4.7의 것으로 읽었다. AI 초안이 저지르는 실수를 검사기가 똑같이 저지른 셈이다.
- 문맥을 오해했다. 숫자를 흘려 보여 주는 띠 영역에서 “공개 모델”이라는 말을 출시 표현으로, “Open-weight gap”을 가중치 공개 주장으로 잘못 읽었다.
고친 내용은 네 가지다. 기준표에 캐시 가격, 서비스 등급별 가격, 과제당 비용 칸을 출처와 함께 더했다. 다른 모델 이름이 나오면 앞 모델의 숫자 구간을 끊게 했다. 띠 영역은 항목별로 나눠 읽게 했다. 부정문(“보장할 수는 없다”)은 단정 규칙에서 빼게 했다. 보안 설정 때문에 막힌 부분은 글을 공개 페이지에서 직접 읽는 방식으로 바꿨다. 시험은 51개로 늘었다.
고친 뒤 다시 돌린 결과, 글 66편을 읽는 데 약 50초가 걸렸고 지적은 29건에서 5건으로 줄었다. 오류로 분류된 것은 0건이다.
06남은 5건은 사람이 본다
남은 5건을 보면 검사기의 역할이 어디까지인지 잘 보인다.
- 확인 필요 1건. “세 모델이 공동 1위”라는 문장. 특정 순위표 한 곳의 한 가지 기준에서만 맞는 말이라, 그 범위가 문장에 드러나는지 사람이 봐야 한다.
- 실제로 고칠 문장 1건. “사람이 접근할 수 없다”는 표현. 회사의 설계 설명을 옮기면서 지나치게 단정해서, 회사의 설명이라는 점이 드러나게 고쳤다.
- 그대로 둘 문장 3건. 회사가 스스로 내건 문구를 따옴표로 인용한 문장, 서버를 설명하면서 ‘접근할 수 없는’이라는 말을 쓴 문장, 그리고 목차 제목 “절대 안 하는 일”. 규칙에는 걸리지만 주장이 아니다.
규칙을 더 촘촘하게 만들면 이런 지적을 더 줄일 수는 있다. 하지만 지적을 0으로 만드는 것보다, 사람이 5분 안에 판단할 수 있는 양으로 유지하는 쪽이 낫다고 봤다.
07만들어 보고 배운 7가지
- 기준표가 곧 검사기의 실력이다. 기준표에 없는 숫자는 맞아도 틀렸다고 나온다. 새 종류의 숫자(캐시 가격, 과제당 비용)를 글에 쓰기 시작하면 기준표 칸부터 만든다.
- 틀린 문장으로 먼저 시험한다. 한국어 조사처럼 실제 글에서만 생기는 문제는 시험 문장에도 넣는다.
- 경보는 그날 분류한다. 글의 문제인지, 검사기의 문제인지. 오경보를 며칠만 방치해도 진짜 경보가 그 속에 묻힌다.
- 지적에 등급을 나눈다. 오류, 확인 필요, 출처 보강, 문체. 모두 같은 빨간불이면 아무것도 급하지 않게 느껴진다.
- 0건은 무죄가 아니다. 검사기는 규칙으로 만든 것만 찾는다. 결과 표 첫 줄에 그 한계를 적어 둔다.
- 사이트 설정을 바꾸면 검사기도 같이 본다. 이번에는 보안 강화 하나가 검사기의 눈을 가렸다.
- AI 편집기보다 규칙 검사기가 먼저다. 같은 날 AI에게 글을 고치게 하는 편집기도 만들었지만, 아직 실제 글에 한 번도 돌리지 않았다. 규칙 검사기는 결과를 설명할 수 있어서, 무엇이 왜 걸렸는지 바로 확인할 수 있었다.
AI로 글을 쓰는 블로그라면 거창한 시스템이 없어도 된다. 자주 쓰는 숫자 열 개를 한 파일에 모으고, 그 숫자가 글마다 같은지만 확인해도 시작으로 충분하다. AI 에이전트가 일을 마쳤다고 말하기 전에 무엇을 확인하게 할지 궁금하다면 AI 에이전트 하네스 이야기도 함께 읽어 보자.
이 글의 근거와 범위
이 글은 이 블로그의 검사기 저장소 기록(코드 변경 이력, 자동 실행 기록, 이슈)과 운영 기록을 바탕으로 썼다. 날짜는 토론토 시간 기준이다. 숫자 예시는 각 회사의 공식 문서와 평가 기관 자료로 다시 확인한 값이며, 이후 바뀌었을 수 있다. 검사기 코드와 저장소 주소, 사이트 보안 설정의 세부 내용은 싣지 않았다.