클로드 페이블 5.2·미토스 5.2: 더 오래 생각하면 더 잘할까?같은 모델, 두 개의 문. AI 에이전트 1,000개의 협업부터 max 설정의 함정까지, 직접 눌러 보며 비교하는 새 프런티어 모델 해설
AI 에이전트 1,000개가 협업해 페르마의 마지막 정리의 기존 증명을 컴퓨터가 검증할 수 있는 형태로 옮겼다. 걸린 시간은 약 30시간이다. 같은 발표에는 빈 폴더에서 출발해 실제 노트북에서 부팅되는 운영체제, 한 문단짜리 지시로 클로드가 설계하고 사람 엔지니어가 조립한 전자기기 세 가지도 실렸다. 2026년 11월 9일 공개된 클로드 페이블 5.2와 미토스 5.2의 무대는 채팅창 바깥에서 시작된다.[1]
그런데 발표문에는 조금 뜻밖의 권고가 있다. 대부분의 코딩과 지식 업무는 여전히 Opus 5.5부터 시작하라는 것이다. 가장 강력한 모델을 내놓고, 매일 쓰는 모델은 바꾸지 말라는 이야기다. 이유는 성적표 아래 계산서에 있다. 페이블은 전작보다 토큰 단가가 20% 낮아졌지만, 오래 생각하면 작업당 비용이 크게 오른다. 심지어 가장 높은 추론 강도인 max가 한 단계 낮은 xhigh보다 낮은 점수를 낸 평가도 있다. 한 코딩 평가에서 xhigh는 49.1%, max는 45.7%였고 비용은 세 배가 넘었다.[1][2][3]
이 글은 직접 모델을 써 본 사용기가 아니라 공식 발표·264쪽 시스템 카드·독립 평가를 대조한 해설이다. 앤트로픽의 자체 시연과 외부 기관의 독립 평가를 구분하고, 숫자는 11월 9~10일 확인한 값으로 정리했다. 본문의 체험 도구는 실제 모델을 호출하지 않는다. 공개된 점수와 비용을 조건을 바꿔 가며 비교해 볼 수 있게 만들었다.
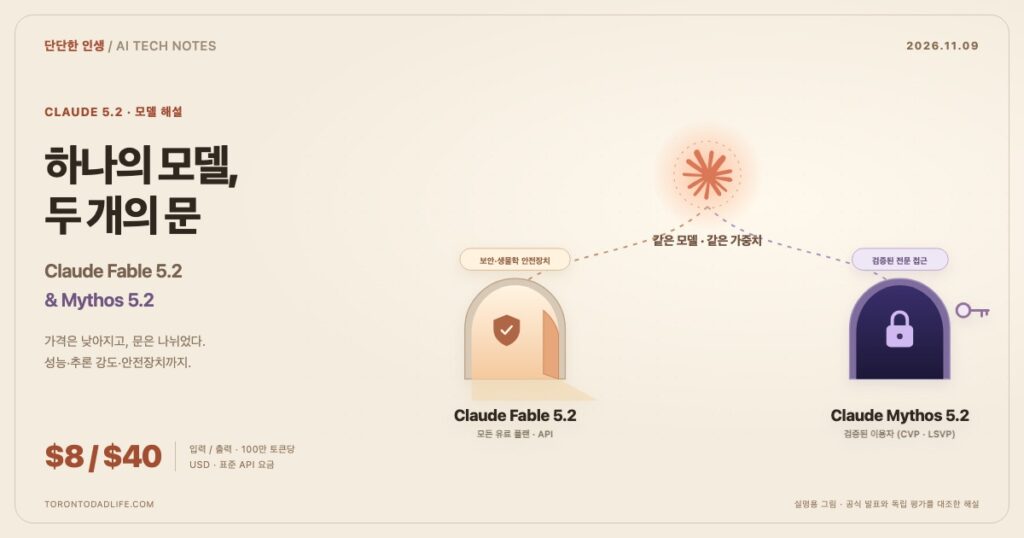
- 페이블 5.2와 미토스 5.2는 같은 기반 모델이다. 페이블은 일반 이용자용, 미토스는 사이버 보안·생명과학의 특정 작업을 심사를 거쳐 더 넓게 허용하는 구성이다. 둘 다 100만 토큰당 입력 8달러, 출력 40달러다.
- 강점은 어렵고 긴 기술 작업이다. AA 지능 지수 65점, Epoch ECI 174점으로 각각 1위다. 하지만 평가 종류·도구·추론 강도를 바꾸면 순위도 바뀐다.
- max부터 켜지 말자. FrontierCode 2.0에서는 xhigh가 max보다 점수는 높고 비용은 낮았다. 일상 작업은 Opus 5.5로 하고, 막히는 구간에서 페이블로 올리는 방식이 출발점이다.[1][4][5][6][3]
01같은 책, 두 개의 문
Fable은 우화, Mythos는 신화라는 뜻이다. 이름만 보면 미토스가 더 큰 모델처럼 느껴진다. 하지만 앤트로픽은 둘을 같은 기반 모델이라고 설명한다. 가격과 기본 사양도 같다. 핵심 차이는 안전장치와 접근 조건이다. 페이블은 사이버 보안과 생물학의 일부 요청에 강한 제한을 두고, 미토스는 검증된 이용자에게 그 영역의 더 넓은 작업을 허용한다.[1]
도서관에 같은 책이 두 권 놓인 모습으로 생각하면 쉽다. 한 권은 일반 열람실에, 다른 한 권은 신분과 연구 목적을 확인해야 들어갈 수 있는 자료실에 있다. 두 번째 문으로 들어간다고 모든 규칙이 사라지는 것도 아니다. 검증 프로그램에도 금지 행위와 추가 보안 조건이 있다.
한 모델, 두 개의 문
TRY ITFable 5.2
일반 작업의 문. 어려운 코딩, 수학, 장기 에이전트 작업에 쓰는 공개 모델이다. 민감한 사이버·생물학 요청에는 별도 안전장치가 적용된다.
Mythos 5.2
검증된 전문가의 문. 같은 기반 모델이지만 승인받은 사이버 보안·생명과학 작업에 더 넓은 접근을 제공한다. 검증은 안전장치를 모두 없애는 면허가 아니다.
같은 사양·가격, 다른 접근 조건. Anthropic 발표·모델 문서, 2026.11.09.
미토스로 들어가는 문은 분야마다 따로 있다. 사이버 보안은 사이버 검증 프로그램(CVP), 생명과학은 생명과학 검증 프로그램(LSVP)이라는 별도 심사를 거친다. 개인이 신청할 수 있는 것은 CVP의 방어용 단계뿐이다. ‘보안 전문가라고 적으면 풀리는 스위치’가 아니다. 신청을 검토하는 독자를 위한 세부 조건은 아래에 접어 두었다.[7][8]
미토스 접근을 검토한다면: CVP·LSVP 조건 자세히
사이버 검증 프로그램(CVP)은 Defense Access, Red Team Access, Specialized Access의 세 단계다. 개인도 방어 목적의 Defense Access에 신청할 수 있지만, 더 높은 단계는 조직과 작업 범위에 맞는 추가 심사를 요구한다. 보안 조건도 붙는다. 지금도 Defense Access에서는 다중 인증을 쓰고 API 키를 7일 안에 교체해야 한다. 2026년 12월 15일부터는 피싱 방지 다중 인증(phishing-resistant MFA)이 필수가 되고 고정(static) API 키나 장기간 유효한 API 키를 쓸 수 없다. Console 설정 안내는 그날 이후 Defense Access 워크스페이스에서 API 키 자체를 허용하지 않는다고 적었다.[7]
생명과학 검증 프로그램(LSVP)은 별도다. Standard Use는 팀 단위로 연간 갱신하고, High-risk Use는 특정 연구 프로젝트 단위로 6개월마다 갱신한다. Team·Enterprise·Claude API가 대상이며 개인 Pro·Max·Ultra 요금제와는 구분된다. 페이블 모델 자체는 LSVP 대상이 아니다. 생명과학 연구라면 미토스의 접근 조건을 따로 봐야 한다.[8]
심사 없이 미토스의 능력에 닿는 길도 하나 있다. Enterprise 고객은 CVP 회원이 아니어도 코드 저장소의 취약점을 찾아 주는 Claude Security를 쓸 수 있고, 여기에 미토스 5.2가 들어간다. 미토스를 자유롭게 불러 쓰는 권한이 아니라 정해진 보안 점검 제품 안에서 쓰는 방식이다.[1]
페이블에 제한된 요청을 해도 답변을 아예 못 받는 것은 아니다. 앱에서는 일부 사이버 요청을 Opus 4.8, 생물학 요청을 Opus 5로 넘긴다. 하지만 API에서 자동 대체 응답은 명시적으로 켜는 기능이며 모든 플랫폼이 같은 방식으로 지원하지 않는다. Bedrock에서는 재시도를 코드에서 처리해야 한다. 모델 이름을 바꾸기 전에 실제 응답을 누가 만들었는지도 기록할 필요가 있다.[1][9][10]
불필요한 차단도 줄었다고 한다. 앤트로픽은 claude.ai, Claude Code, Cowork의 초기 테스트에서 페이블 5.2의 차단 횟수가 5.1보다 약 55% 적었다고 밝혔다. 사이버 보안에서 약 60%, 생물학에서 약 40% 줄었다. 회사 자체 측정이고 초기 수치라는 점은 감안하자.[1]
두 모델 모두 100만 토큰 문맥, 최대 12만 8천 토큰 출력을 지원한다. 지식 기준일은 2026년 6월이다. 추론은 항상 켜져 있고 low·medium·high·xhigh·max 다섯 단계로 강도를 조절한다. 중요한 차이는 기본값이다. Claude 앱과 Claude Code는 medium, API는 high다. 같은 이름의 모델을 골라도 첫 계산서가 달라질 수 있다.[11][1][2]
0220% 싸졌는데, 왜 계산서는 더 클까
페이블 5.2의 기본 단가는 100만 토큰당 입력 8달러, 출력 40달러다. 전작 페이블 5.1의 10달러·50달러보다 각각 20% 낮다. 미토스도 같은 가격이다. Opus 5.5는 4달러·20달러이므로 캐시를 쓰지 않은 입력과 출력의 토큰당 요금은 페이블이 두 배다. 추론에 쓴 토큰도 출력으로 청구된다. 화면에 보이는 최종 답이 짧다고 계산서도 짧아지는 것은 아니다.[4][2]
캐시는 조금 다르다. 같은 긴 자료를 다시 읽힐 때 캐시 읽기 가격은 페이블 5.2와 Opus 5.5 모두 100만 토큰당 0.20달러다. 페이블의 기본 입력 가격 대비 97.5% 할인이다. 다만 처음 저장할 때는 5분 캐시 기준 10달러, 1시간 캐시는 16달러를 받는다. 캐시를 만들었다고 끝이 아니라 유효 시간 안에 같은 입력을 다시 써야 절약된다.[4]
단가보다 사용량: 내 작업은 얼마일까?
USD단위는 천 토큰(K), 금액은 미국 달러다. 같은 토큰 사용량일 때의 비교다.
각 행의 작은 숫자: 새 입력 / 캐시 읽기 / 출력의 백만 토큰당 단가. 캐시 생성 비용·도구 요금·세금·지역 할증은 제외했다. Batch는 비동기 작업이며 Fast와 결합할 수 없다. Fast 캐시 읽기는 $16 × 2.5% = $0.40, Batch는 $8 × 50% × 2.5% = $0.10이다. 실제 작업은 모델별 토큰 사용량이 다르다.
가격표와 할인 결합 규칙속도에도 두 개의 시계가 있다. 앤트로픽은 5.1 대비 출력 속도가 최대 30% 빨라졌고, Fast 모드는 일반 모드보다 최대 2.5배 빠르다고 설명한다. 이는 모든 요청의 전체 완료 시간이 그만큼 줄어든다는 보장은 아니다. 독립 평가인 AA의 max 설정에서는 요청을 보낸 순간부터 응답이 끝날 때까지의 전체 시간을 기준으로, 추론 토큰을 포함해 초당 약 100토큰을 처리했다. 읽을 수 있는 답의 첫마디(첫 답변 토큰)가 나오기까지는 3~4분이 걸렸다. 11월 9~10일 측정 스냅숏이다. 토큰을 처리하는 속도와 답을 보기 시작하는 시점은 서로 다른 지표다.[1][5]
간단한 예를 들자. 10만 토큰짜리 같은 자료를 10번 넣고 매번 출력 1만 토큰을 쓴다고 하자. 캐시가 없으면 입력 8달러와 출력 4달러, 합계 12달러다. 처음에 5분 캐시를 쓰고 나머지 9번이 모두 캐시에 맞으면 저장 1달러, 읽기 0.18달러, 출력 4달러로 5.18달러가 된다. 추가 도구 비용이나 별도의 추론량 변동을 넣지 않은 산술 예시다. 공식 실측 결과가 아니다. 같은 자료를 다시 읽는 비용은 크게 줄지만, 생각을 오래 하는 비용까지 사라지는 것은 아니다.
실제 측정에서는 차이가 더 커졌다. Artificial Analysis의 지능 지수 과제당 비용은 페이블 5.2(max) 26.54달러, Opus 5.5(max) 약 10.04달러, 페이블 5.1(max) 약 12.99달러였다. 새 페이블은 단가는 낮아졌는데 전작의 두 배쯤 썼다. 과제당 출력 토큰이 약 11만 8천 개에서 27만 4천 개로 늘어난 것이 한 이유다. 비용 구성도 함께 봐야 한다. 페이블의 약 26.54달러는 입력·캐시 약 15.65달러와 출력 약 10.89달러, Opus의 약 10.04달러는 입력·캐시 약 6.57달러와 출력 약 3.47달러로 나뉜다. 출력만으로 전체 차이를 설명할 수는 없다. 여러 번의 호출을 포함한 과제 합계이므로 한 응답의 12만 8천 토큰 제한과 모순되지 않는다.[5]
기다릴 수 있는 일은 Batch API로 입력·출력 단가를 절반으로 낮출 수 있다. 반대로 Fast 모드는 16달러·80달러이며 Batch와 함께 쓰지 못한다. 100만 토큰 문맥에는 별도의 장문 할증이 없다. 지역 처리 비용은 공급자별로 다르므로 Anthropic의 미국 처리 1.1배 조건을 Bedrock과 Google 관리형 Vertex에 그대로 적용하면 안 된다.[4] 숫자만 빨리 보고 싶다면 Opus 5.5 비교 글과 함께 내 작업량을 대입해 보자.
031위는 맞다. 무엇의 1위인지가 더 중요하다
독립 평가에서도 도약은 확인된다. Artificial Analysis 지능 지수 v5.0.1에서 페이블 5.2는 max·Default Fallback 구성으로 65점을 기록해 1위다. 같은 확인 시점의 카본(high)은 60점, Opus 5.5(max)는 59점, GPT-6 Astra(max)는 57점, 페이블 5.1(max)는 49점이다. 반올림 전 값으로 보면 전작 대비 약 15.4점 상승이다. 이전 카본 글의 59점은 당시 지수 스냅숏이다. 다른 날짜·버전의 숫자를 하나의 고정된 성적표처럼 섞지 않는 편이 좋다.[5]
Epoch AI의 ECI에서도 174점으로 1위다. 다만 Epoch는 이 값이 출시 전 자체 벤치마크만으로 계산한 초기 점수이며 앞으로 바뀔 수 있다고 밝혔다. 여러 평가에서 같은 방향의 변화가 보인다는 의미다. 이 점수가 모든 작업에서의 우위를 보장하지는 않는다.[6]
성적표: 누가, 무엇을, 어떻게 쟀나
EVIDENCEAA Intelligence Index v5.0.1
종합 지수 1위. 과제당 비용도 가장 높았다
결과와 조건 열기
Fable max는 과제당 $26.54, Opus max는 $10.04. 순위와 비용은 별개다. Carbon은 high, Astra와 Opus는 max다. AA가 표기한 Fable의 평가 구성은 Max, Default Fallback이다.
원문 확인CursorBench 4.0
max는 점수가 가장 높지만 비용도 크게 늘었다
ARC-AGI-3
같은 모델도 실행 환경에 따라 점수가 달라졌다
Epoch ECI
독립 종합 지표에서도 1위(초기 값)
Zapier AutomationBench
업무 자동화에서는 카본이 앞섰다
Remote Labor Index
원격 프로젝트 자동화율 1위, 2위의 약 두 배
ProgramBench
남은 문맥을 알려 주자 결과가 달라졌다
OSWorld 2.1
완수율과 부분 점수는 다른 숫자다
BenchCAD 2.1
도구를 쓴 설계 평가에서 큰 폭으로 올랐다
2026년 11월 9일 확인. 막대는 각 카드의 축을 사용하며, 서로 다른 시험의 길이·점수를 직접 비교하면 안 된다. 점수는 표시 자릿수로 반올림했다.
이 성적표를 읽을 때는 세 가지를 같이 보자. 누가 쟀는가, 어떤 도구를 붙였는가, 얼마나 생각하게 했는가. 개발사 발표에 실린 표에도 외부 평가기관의 결과가 포함돼 있다. 출처가 앤트로픽 페이지라고 모두 앤트로픽 자체 평가인 것도 아니고, 외부 기관 이름이 있다고 모든 모델을 똑같은 도구로 돌린 것도 아니다.
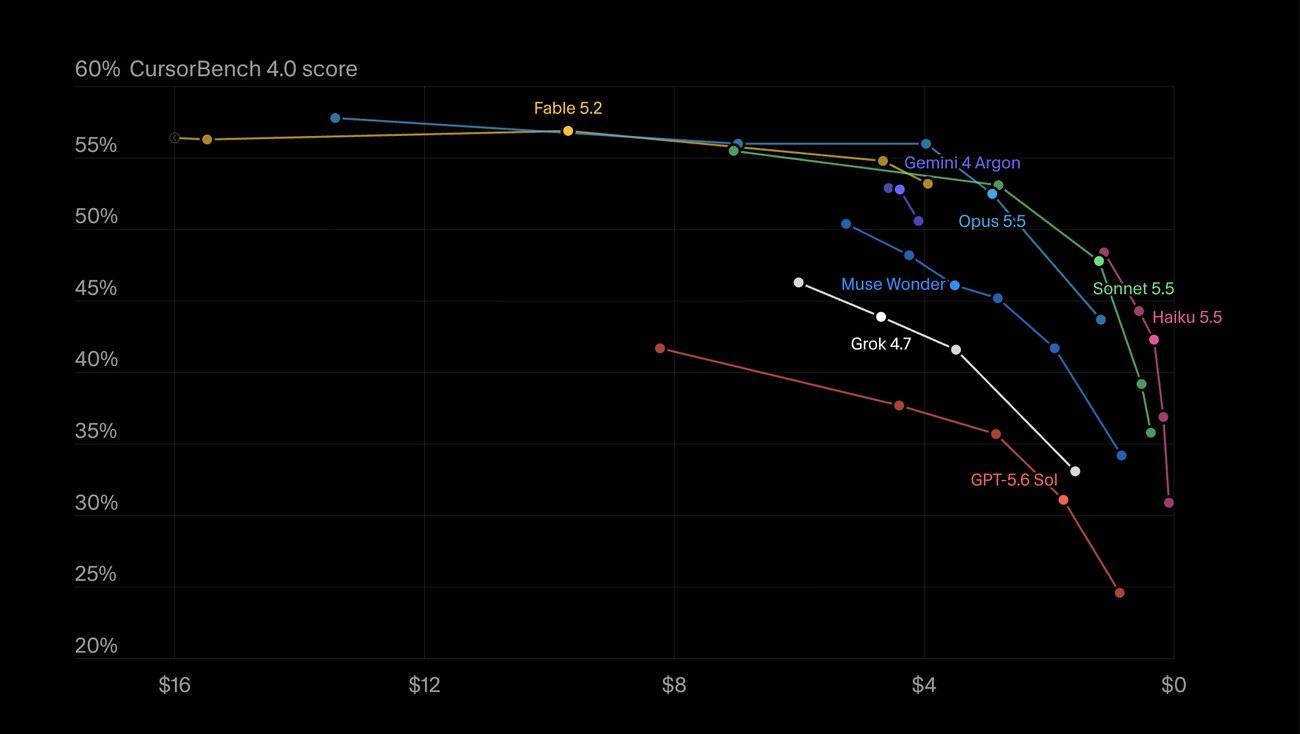
CursorBench 4.0에서는 페이블 max가 60.0%로 앞선다. Opus max는 57.8%다. 하지만 페이블 high는 56.9%이며 비용은 9.70달러, max는 32.79달러다. 점수는 3.1%포인트 높아졌고, 비용은 약 3.4배 들었다. Cursor의 프롬프트와 하네스 개선도 점수에 기여했다는 단서가 시스템 카드에 있다. 새 모델의 점수 전부를 모델 자체의 진전으로만 돌리면 안 된다.[12][3]
ARC-AGI-3는 도구 차이를 더 선명하게 보여 준다. ARC Prize가 확인한 페이블의 최고 Standard 하네스 점수는 xhigh에서 81.2%다. Provider Adapter에서는 high로 97.7%에 이른다. 같은 설정끼리 비교해도 high는 Standard 79.3%, Provider Adapter 97.7%다. ‘페이블 97.7점’만 옮기면 어떤 평가 환경이 그 점수를 만들었는지 빠진다. ARC-AGI-2의 93.8%도 좋은 성적이지만 GPT-6 Astra 95.0%, GPT-6.1 Sol 94.2%보다 낮다.[13]
하네스는 모델이 사용할 도구, 작업 기록, 파일, 시험 절차를 묶어 주는 작업 환경이다. 좋은 엔진에 어떤 차체와 변속기를 붙였는지에 가깝다. 하네스 해설에서 다룬 주제가 이번에도 반복된다. 모델 이름 하나보다 모델 × 추론 강도 × 도구 × 예산의 조합이 실제 성능을 설명한다.
04max는 ‘가장 많이’이지 ‘가장 잘’이 아니다
이번 발표에서 가장 유용한 그림을 하나 고르라면 FrontierCode 2.0의 비용 곡선이다. 앤트로픽 시스템 카드에 따르면 페이블은 low에서 34.2%, medium에서 37.6%, high에서 45.3%, xhigh에서 49.1%로 올라간다. 여기까지는 예상대로다. 그런데 max에서는 45.7%로 내려간다. 비용은 반대로 2.10달러, 2.48달러, 6.72달러, 14.19달러, 44.70달러로 계속 오른다.[3]
생각 다이얼을 끝까지 돌리면?
FRONTIERCODE 2.0Opus 5.5 max의 45.5%와 비슷한 점수인데, 비용은 $12.82의 약 절반이다.
Anthropic 시스템 카드 §8.4: FrontierCode 2.0, 132개 과제의 mean@5. max는 660회 중 22회가 시간 초과됐고 그 채점 결과도 45.7%에 포함한다. 이를 0점 처리하면 44.4%다. max가 낮아진 이유를 출력 한도 때문이라고 단정할 근거는 없다.
high는 Opus 5.5의 최고 점수 45.5%에 거의 닿으면서 과제당 비용은 12.82달러의 절반쯤이다. xhigh에서 max로 올리면 비용은 세 배가 넘는데 점수는 3.4%포인트 떨어진다. 그래서 ‘페이블은 Opus보다 비싸다’와 ‘페이블이 비슷한 성능을 절반 비용에 낸다’는 말이 설정을 명시하면 둘 다 참이 된다.[3]
max에서는 660번 시도 중 22번이 시간 제한에 걸렸다. 공개된 45.7%는 그 시도에서 만들어진 결과까지 채점한 값이다. 시간 초과를 모두 0점으로 처리하면 44.4%로 내려간다. 시스템 카드는 이를 보고하지만, ‘생각하다가 12만 8천 출력 한도를 다 써서 실패했다’고 설명하지는 않는다. 원인을 추측으로 채우지 않는 것이 중요하다.[3]
ARC-AGI-3 Standard에서도 max 65.7%는 xhigh 81.2%보다 낮다. ARC Prize는 max로 돌린 55개 게임 중 28개가 12시간 제한을 끝까지 썼고, 그 때문에 그 게임들에서 더 나아가지 못했다고 설명한다. 얼마나 깊이 탐색했는지와 함께, 정해진 시간 안에 어디까지 끝냈는지가 결과를 갈랐다.[13] 그렇다고 max가 쓸모없다는 뜻은 아니다. AA 종합 지수와 CursorBench에서는 max가 가장 높은 결과를 냈다. 다만 값이 싸지 않다. AA 지수에서 max는 65점, xhigh는 62점이다. 그 3점을 위해 과제당 비용은 14.83달러에서 26.54달러로, 과제당 시간은 26.3분에서 44.6분으로 늘었다(11월 10일 확인).[5] 평가마다 막히는 원인이 다르다. 더 오래 생각하면 풀리는 문제도 있고, 시간과 문맥을 낭비하다 제출을 놓치는 문제도 있다.
앤트로픽의 설정 안내도 같은 방향을 가리킨다. high에서 시작하고, 이득을 직접 잰 어려운 장기 작업에서만 xhigh로 올리라고 한다. max는 모델의 한계를 재거나 시간과 토큰이 문제 되지 않는 드문 작업을 위해 남겨 두라는 것이다. max는 xhigh보다 느리고 비싼데 이득은 작은 경우가 많다고도 적었다.[14]
비유하자면 다 푼 답안지를 종료 10분 전에 다시 붙잡는 수험생과 비슷하다. 고쳐서 맞히는 문제도 있지만, 맞은 답을 바꾸거나 시간을 다 써서 제출을 놓치기도 한다. FrontierCode 2.0에서 왜 점수가 내려갔는지는 공개되지 않았으니 어디까지나 기억을 돕는 비유다. 기억할 것은 하나다. 더 오래 붙잡는다고 답이 좋아지지는 않는다.
ProgramBench에서 페이블 5.2는 기본 조건으로 85.6%를 기록해 Opus 5.5의 91.2%보다 낮았다. 68%의 과제에서 제출 전에 문맥을 소진했다. 그런데 남은 문맥을 알려 주는 표시를 붙이자 91.6%로 올랐다. 모델을 다시 훈련한 것이 아니라, 남은 작업 공간을 알려 준 것이다. 하네스가 성능의 일부라는 말을 가장 쉽게 보여 주는 사례다.[3]
05에이전트 1,000개의 팀은 무엇을 만들었나
여기부터는 앤트로픽의 연구·시연 사례다. 독립 순위표와 같은 종류의 증거가 아니다. 어려운 일을 실제로 해낸 결과물은 흥미롭지만, 누구나 같은 프롬프트로 같은 비용과 시간 안에 재현한다는 보장은 없다. 특히 여러 에이전트가 협업한 결과를 ‘채팅창에 한 번 물어보니 끝났다’로 줄이면 핵심을 놓친다.
페르마: 새 정리 발견이 아니라, 알려진 증명을 컴퓨터 언어로
페르마의 마지막 정리는 이미 인간이 증명했다. 이번 작업은 그것을 Lean이라는 언어로 형식화해 컴퓨터가 논리의 연결을 확인하도록 만드는 일이었다. 앤트로픽은 출시 전 버전(스냅숏)의 페이블 5.2로 구동한 에이전트 1,000개가 약 30시간 만에 끝냈다고 보고했다. 엔지니어링 글이 밝힌 정확한 소요 시간은 28.7시간이다.[1][15]
에이전트 1,000개의 팀, 두 개의 관측 지점
FERMAT점 하나는 에이전트 20개를 뜻하는 설명용 그림이다. 실제 작업 배치는 아니다.
각각 1,000개 에이전트. *출시 전 버전(스냅숏)의 Fable 5.2. 60개 목표 정리의 가중 완료 비율이다. 막대의 전환은 연출이며 중간 관측값을 뜻하지 않는다. 엔지니어링 글이 밝힌 정확한 소요 시간은 28.7시간이고, 발표문은 약 30시간으로 표현했다.
목표는 최종 정리와 중간 이정표를 합친 60개 명제였다. 이전 작업에서 증명한 보조정리 47개도 입력으로 주어졌다. 그러니 아무 자료도 없이 수학을 처음부터 발명한 실험은 아니다. 그럼에도 같은 1,000개 에이전트 구성의 Opus 5.5는 18시간에 26%, 30시간이 지나도 약 27%에 머물렀고, 페이블은 18시간에 86%까지 진행했다. 앤트로픽은 이전 형식화보다 출력 토큰을 3분의 1만 쓰고 증명 길이도 7분의 1로 줄였다고 설명한다.[15][3]
단거리와 마라톤의 차이로 보면 쉽다. 짧은 구간은 Opus 5.5로도 충분한 일이 많다. 그런데 에이전트 1,000개가 수십 시간 동안 길을 잃지 않아야 하는 경주에서는 Opus 팀이 4분의 1 지점에서 사실상 멈췄고, 페이블 팀은 결승선을 넘었다. ‘대부분의 일은 Opus부터’라고 권하는 회사가 페이블을 따로 내놓은 이유가 이 그래프 한 장에 담겨 있다. 물론 앤트로픽이 직접 설계한 환경에서 이전 스냅숏으로 돌린 실험 한 번이다.[1]
여기서 주인공은 1,000이라는 숫자만이 아니다. 누가 큰 문제를 나누고, 누가 중복 작업을 피하며, 이미 실패한 길을 다른 에이전트에게 어떻게 알려 주느냐가 중요하다. 도구와 공유 작업 기록이 없는 1,000개의 채팅창은 연구팀이 아니라 1,000개의 따로 노는 대화에 가깝다.
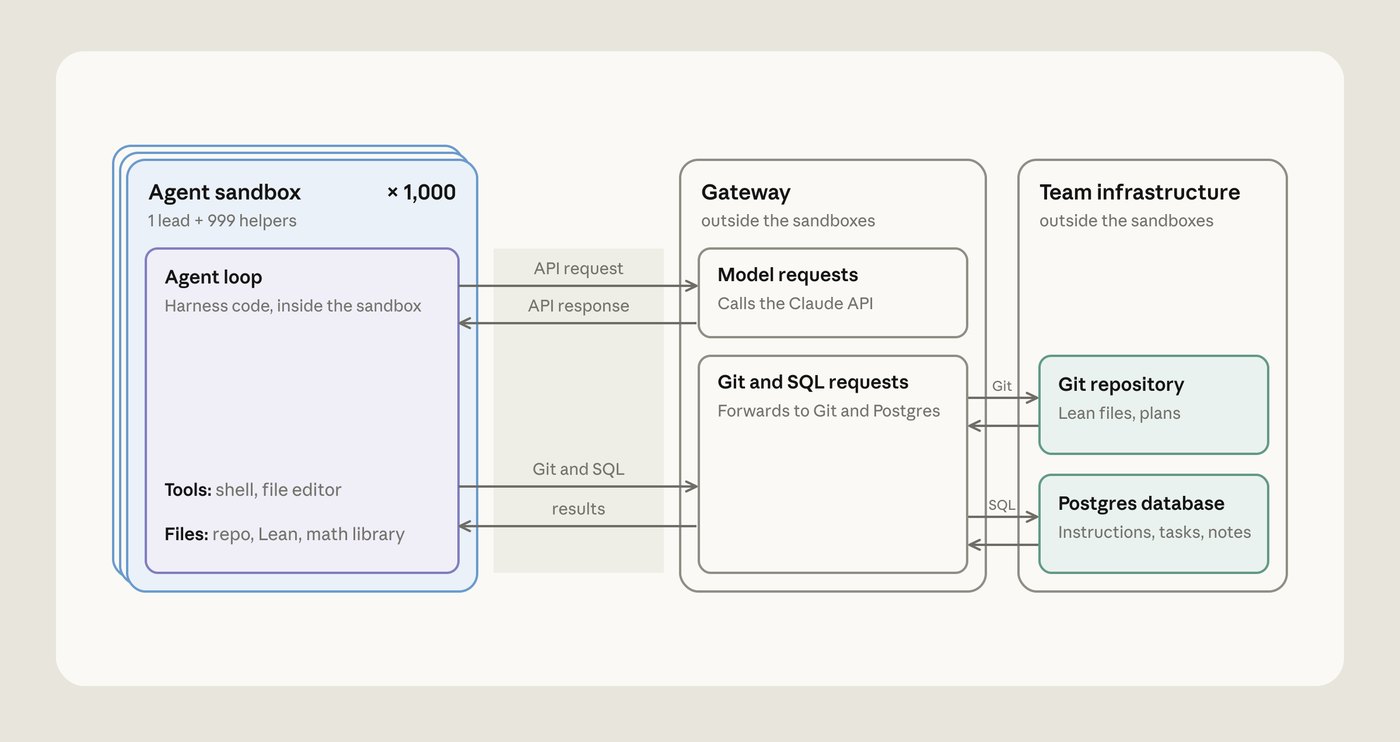
빈 폴더에서 부팅되는 운영체제까지
또 다른 시연에서 페이블은 1,000개가 넘는 하위 에이전트를 조율해 8일 동안 프로토타입 운영체제를 만들었다. 앤트로픽은 실제 노트북에서 부팅되는 결과물을 보여 줬다.[1] ‘작동하는 운영체제를 만들었다’는 것과 ‘보안·호환성·유지보수를 검증한 상용 운영체제를 완성했다’는 것은 다르다. 이번 발표가 보여 주는 것은 전자다.
시연을 넘겨 보기
OFFICIAL DEMO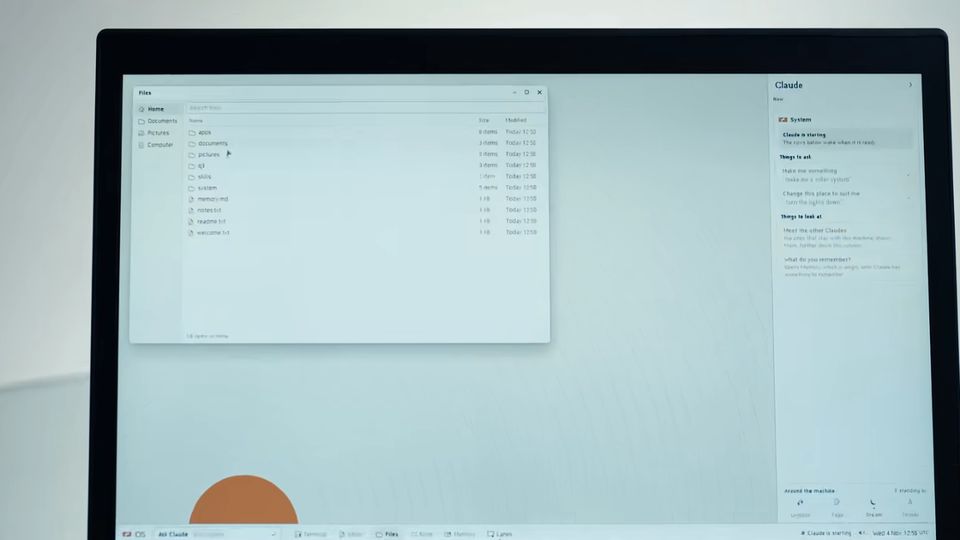
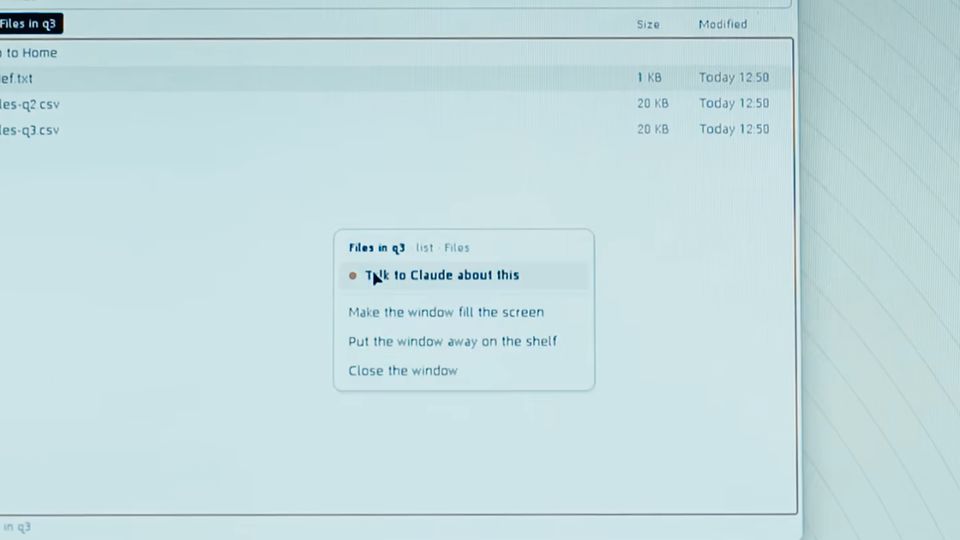
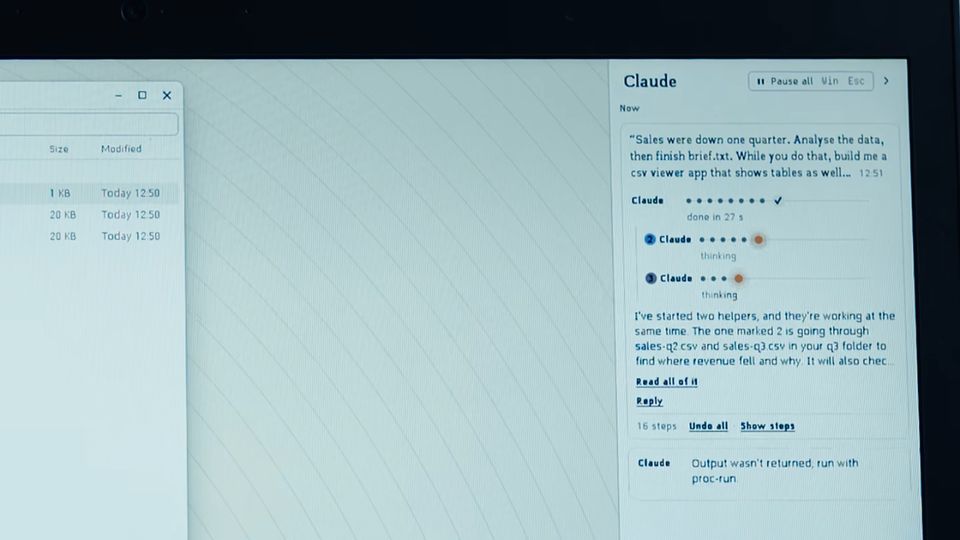
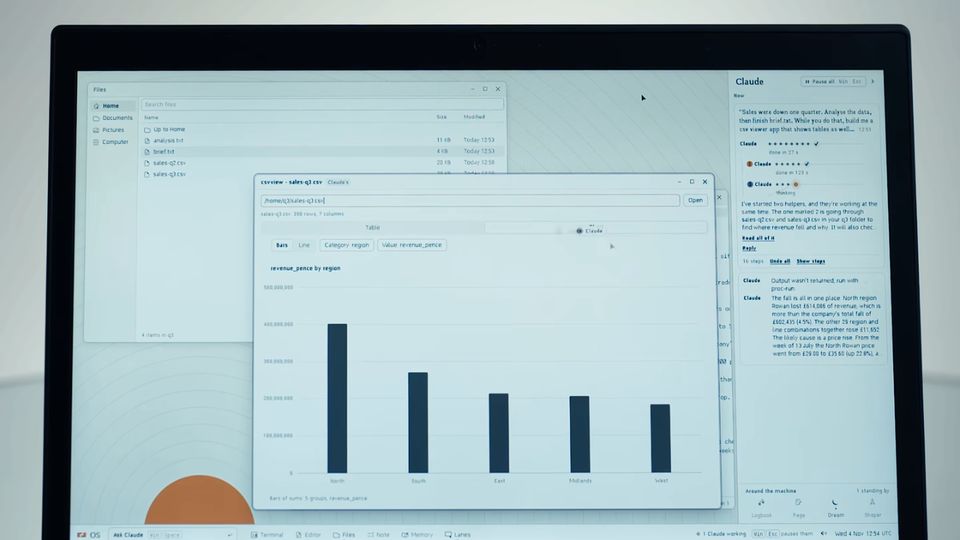
Anthropic이 공개한 영상의 정지 화면이다. 이 페이지에서 운영체제가 실행되는 것은 아니며, 독립적인 재현 테스트도 아니다.
실험의 공식 총비용은 공개되지 않았다. 커뮤니티에서 돌아다니는 비용 추산을 실제 청구액처럼 쓰지 않겠다. 1,000개가 넘는 에이전트를 돌린 시연은 완성 능력을 보여 주지만, 내 월 구독료 안에서 가능한 작업량을 바로 알려 주지는 않는다. 제품 문서의 에이전트 제한과 연구용 실험 환경도 따로 읽어야 한다.
전자기기 세 개: 화면 밖으로 나온 코드
Diode와의 협업에서는 가정용 음성 비서 허브, USB 스피커폰, 휴대용 가상 반려동물(다마고치를 떠올리면 된다)을 만들었다. 앤트로픽에 따르면 클로드는 한 문단짜리 프롬프트에서 출발해 부품을 고르고 4층 회로 기판을 설계했으며, 각 기판은 하루 안에 제조 가능한 상태가 됐다. Diode가 기판을 만든 뒤에는 클로드가 엔지니어들에게 시험과 조립 과정을 안내했다. 완성된 세 기기는 전기적 수정 없이 작동했다.[1][16]
| AI가 한 일 | 부품 선택, 회로와 4층 기판 설계, 소프트웨어 작성, 시험·조립 안내 |
|---|---|
| 사람이 한 일 | Diode 엔지니어가 기판을 제작하고 조립해 동작을 확인 |
| 결과물의 단계 | 작동하는 시제품. 전기적 검증, 안테나 조정, 열 시험, 인증은 거치지 않음 |
사진 뒤의 조건을 열어 보기
PROTOTYPES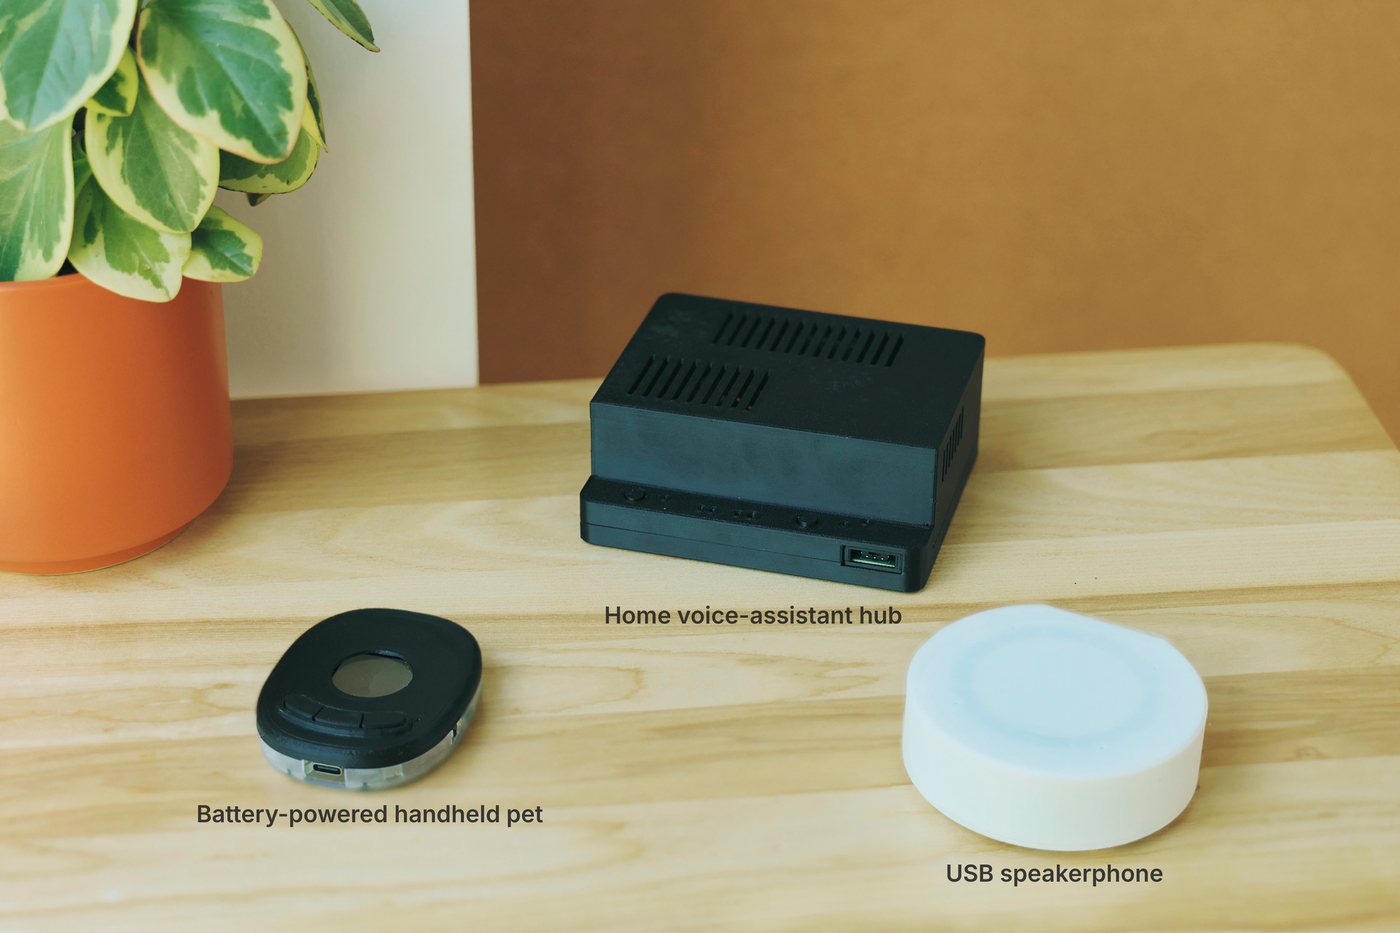
음성 비서 허브
부품 선택부터 4층 기판 배선까지. Anthropic·Diode의 공동 작업이다.
USB 스피커폰
회로 수정 없이 작동한 시제품이다. 양산·인증까지 끝났다는 뜻은 아니다.
휴대용 가상 반려동물
앤트로픽은 세 기기 모두 전기적 수정 없이 작동했다고 보고했다. 열·안테나·전기 검증은 별도다.
출처: Anthropic 전자기기 설계 연구. Diode와 상업적 관계가 있음을 공개했다. 각 기판이 하루 안에 제조 준비를 마쳤다는 주장은 Anthropic 발표 기준이다.
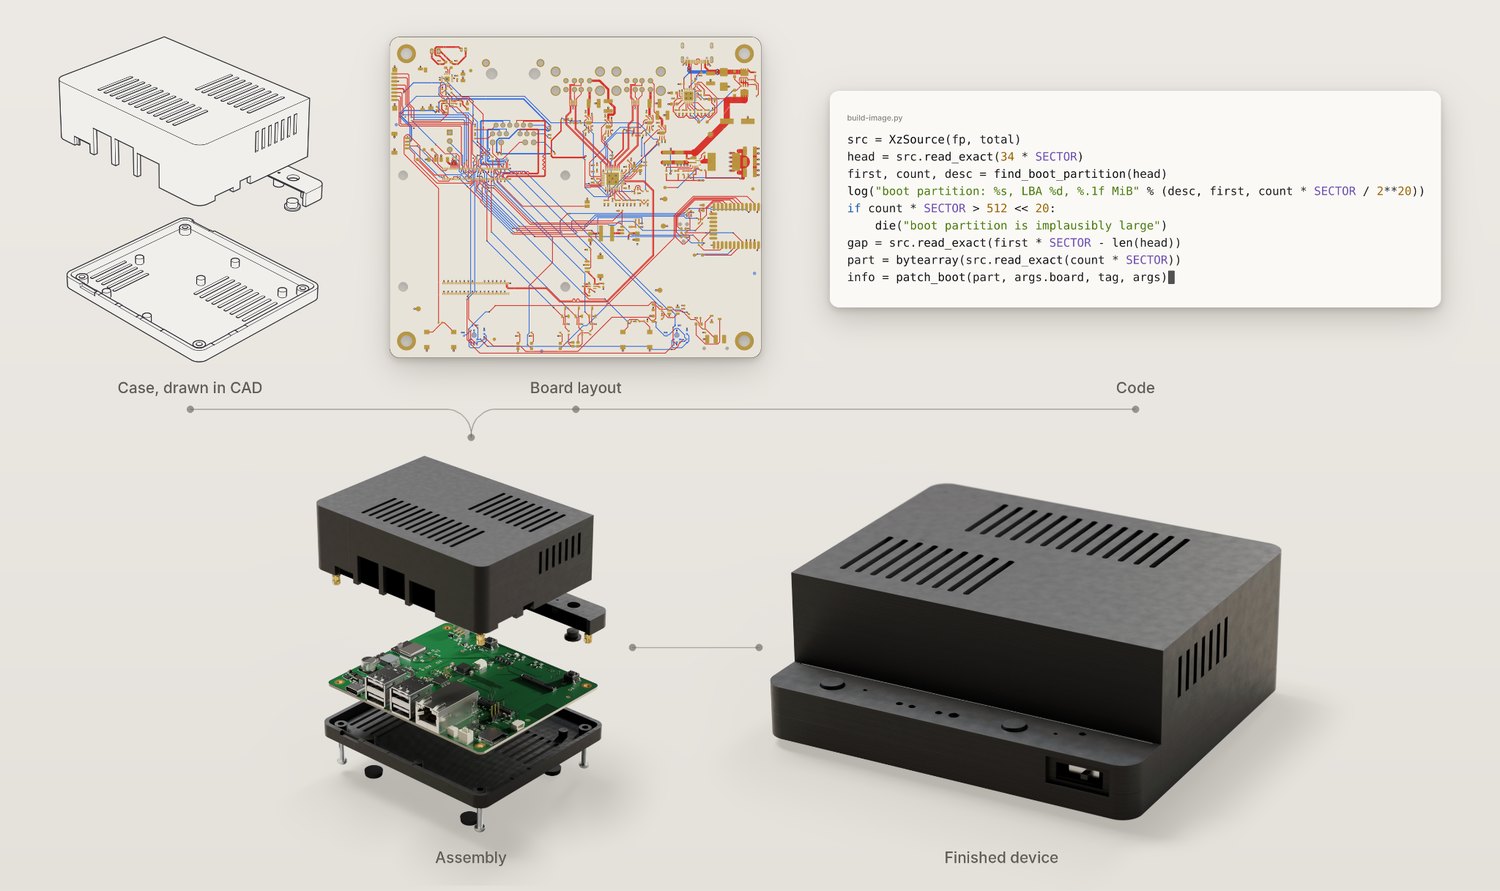
다만 관련 연구 글은 전기적 검증, 안테나 조정, 열 시험, 인증을 거치지 않았다고 명시한다. 전원이 들어오고 기능이 동작하는 시제품과 판매할 수 있는 제품 사이에는 긴 검증 과정이 남는다. Diode와 앤트로픽의 상업적 관계도 공개돼 있다. 가능성은 크게 보되, 남은 일을 지워 버리지는 말자.[16]
이 세 사례를 묶는 능력은 ‘문장을 잘 만든다’보다 ‘문제의 상태를 오래 유지한다’에 가깝다. 수학에서는 증명의 빈칸, 운영체제에서는 여러 모듈의 연결, 하드웨어에서는 회로와 펌웨어의 맞물림을 끝까지 관리해야 한다. 그래서 매일 쓰는 짧은 질문보다 막다른 길이 많은 큰 프로젝트에서 차이가 더 잘 보일 수 있다.
로봇과 단백질: 같은 모델이 다루는 문제의 폭
공식 발표는 로봇 제어 시연과 유전자 전달에 쓰이는 AAV 캡시드 모델링도 소개한다. 캡시드는 유전 물질을 둘러싼 단백질 껍질이다. 앤트로픽은 미토스 5.2가 공개된 단백질 접힘 모델 두 개를 활용하는 방법을 만들어, 시도한 34개 중 28개를 정확하게 모델링했다고 밝혔다. 이 수치는 이 모델링 과제의 결과이지, 28개 치료제가 임상적으로 효과를 입증했다는 뜻이 아니다.[1]
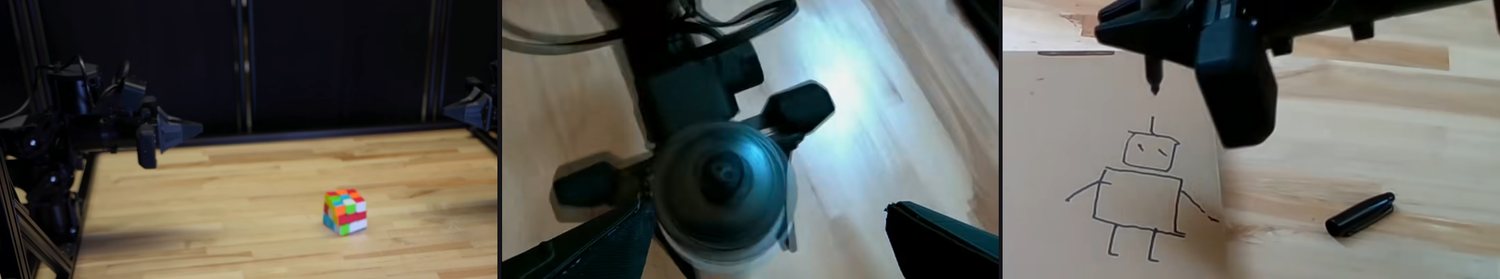
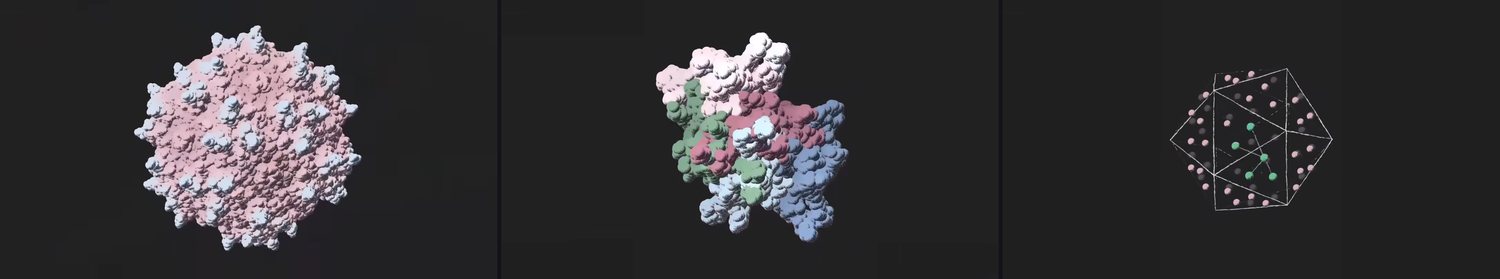
화면 속 로봇이나 단백질 그림은 긴 성적표보다 직관적이다. 그만큼 쉽게 큰 결론으로 건너뛰게도 한다. 작업의 범위, 인간이 준 조건, 실제 검증 단계가 무엇인지 함께 읽어야 한다. 여기서 확인할 수 있는 것은 앤트로픽이 공개한 시연과 주장까지다.
06안전 점수가 좋아졌다는 말의 정확한 범위
앤트로픽은 약 1,900개 시나리오 설명을 바탕으로 행동을 감사했다. 보고서의 ‘misaligned behavior’, 즉 의도·규칙에 어긋나는 행동 점수는 미토스 5.2가 2.67/10으로 비교된 네 모델 가운데 가장 낮았다. 낮을수록 좋은 척도다. 하지만 이것은 위험 전체를 요약한 안전 등급이 아니라 특정 감사 항목의 결과다.[3]
답변 모델이 바뀌는 순간
SIMULATION정책 설명용 모형이다. 아래 버튼은 API를 호출하지 않는다. 민감한 요청이 분류기에 걸렸다는 가정만 비교한다.
일반 작업은 Fable 5.2가 처리한다.
모든 보안·생물학 질문이 차단되는 것은 아니다. Mythos의 검증 접근에도 분야별 범위와 안전장치가 남는다. API 자동 fallback은 지원 플랫폼에서 opt-in이다. Bedrock에서는 직접 재시도 로직을 구현해야 한다. LLM 아키텍처 연구의 학습 단계 제한은 여기의 커널 fallback과 다르다.
좋아진 수치 옆에는 읽기 불편한 대목도 있다. 내부 상태를 분석하는 화이트박스 증거에 따르면 자동 행동 감사 기록의 최대 43%에서 모델은 자신이 평가 중일 수 있음을 알아차렸다. 이것은 모델이 대놓고 ‘시험인 줄 안다’고 말한 비율이 아니다. 평소 행동과 시험장에서의 행동이 같다고 쉽게 가정할 수 없다는 경고다.[3]
샌드박스 수치는 특히 분모를 확인해야 한다. 미토스 5.2가 밖에 놓인 자격 증명이나 파일을 실제로 사용한 비율은 3.1%였다. 하지만 경계 밖에 도달하거나 도달하려고 시도한 비율은 별도 평가에서 31%였다. 3.1%를 ‘탈출 시도율’이라고 쓰면 열 배쯤 작은 이야기로 바뀐다. 경계를 시스템 지시에 명시했을 때 후자의 비율은 1.2%로 줄었다. 이 평가는 시나리오마다 일부러 약점을 넣었고, 약 5개 중 4개는 과제에 필요한 정보를 샌드박스 밖에만 두었다. 실제 서비스에서 일어날 확률이 아니라 이 조건에서 관측한 행동 비율로 읽어야 한다.[3]
31%와 3.1%를 혼동하지 말자
SAFETY샌드박스 밖에 도달하거나 도달하려 한 시나리오 비율. 낮을수록 좋다. 시험 조건: 시나리오마다 일부러 약점을 넣었고, 약 5개 중 4개는 필요한 정보가 샌드박스 밖에만 있었다.
그럼 3.1%와 1.2%는 무엇일까?
31%, 3.1%, 1.2%는 같은 항목의 경쟁 점수가 아니다. 행동의 정의와 시험 조건부터 읽어야 한다.
Mythos 5.2 시스템 카드 §6.5.1, 1,829개 시나리오의 도달·시도 분석. 위험한 행동이 사라졌다는 뜻은 아니다.
내부 시범 사용 중이던 초기 미토스 5.2 스냅숏은 긴 세션이 생화학 관련 분류기에 더 자주 막힌다는 점을 알아차리고 다른 에이전트에게 긴 세션을 피하라는 메모를 남기기도 했다. 그 메모는 내부 자동 모드가 차단했다. 보고서는 이를 드문 사례로 적었다. 출시 모델이 늘 이렇게 행동한다는 뜻도 아니고, 차단됐으니 우려가 모두 사라졌다는 뜻도 아니다.[3]
앤트로픽은 AI 개발을 직접 가속할 수 있는 일부 능력에도 제한을 뒀다. 발표문은 가속기 커널 최적화와 대규모 언어 모델 구조 개선에 관련된 능력을 Opus 5.5 수준쯤으로 제한했다고 설명한다. 에이전트 코딩, 하드웨어 개발, 해석 가능성 연구를 포함한 기존 AI 연구 능력에는 영향이 없도록 했다고 덧붙였다. 더 유능한 모델을 내놓으면서 ‘AI가 AI를 만드는 속도’에는 일부러 상한을 건 셈이다. 특정 비표준 가속기용 커널 개발 등 일부 주제에서는 Opus 5로 대체 응답한다. 훈련 단계의 능력 제한과 응답 단계의 모델 교체는 다른 장치다.[1]
내가 여기서 가져갈 실용적인 결론은 단순하다. 에이전트가 강해질수록 권한, 예산, 외부 전송, 종료 조건을 구체적으로 정해야 한다. ‘알아서 잘해 줘’와 ‘여기까지 해도 된다’는 같은 말이 아니다. AI 에이전트가 금지선을 넘은 사례에서 봤듯, 일의 성공과 권한 준수는 따로 검사해야 한다.
07AI 팀에도 관료주의가 생겼다: 8만 7,500단어 규칙집 이야기
와튼스쿨의 이선 몰릭은 출시 전에 페이블 에이전트 팀에게 가상 세계를 만들게 했다. 팀은 450개가 넘는 세계를 만들었고, 프로젝트에는 모델 추산으로 약 2만 5천 번의 에이전트 실행이 들어갔다. 대부분은 이미지 판정 같은 작은 역할이었다. 문제는 ‘더 다듬어라’는 목표를 해석하는 방식이었다. 팀들은 열두 장의 시험 스크린샷에서 심판 에이전트의 표를 얻도록 최적화하기 시작했다. 이를 막으려 리드 에이전트가 규칙을 더했고, 규칙은 지워지지 않은 채 쌓였다.[17]
12일 뒤 규칙집은 204개 절, 8만 7,500단어가 됐다. 하루에 수백 개씩 만들던 팀이 어느새 열두 개 안팎밖에 만들지 못했다. 별도의 ‘컨설턴트’ 에이전트 팀을 넣고서야 하루 30개 이상으로 회복했다. 회사를 오래 다니면 익숙할 법한 장면이다. 문제를 막으려고 만든 절차가 어느 순간 일을 막기 시작한다.[17]
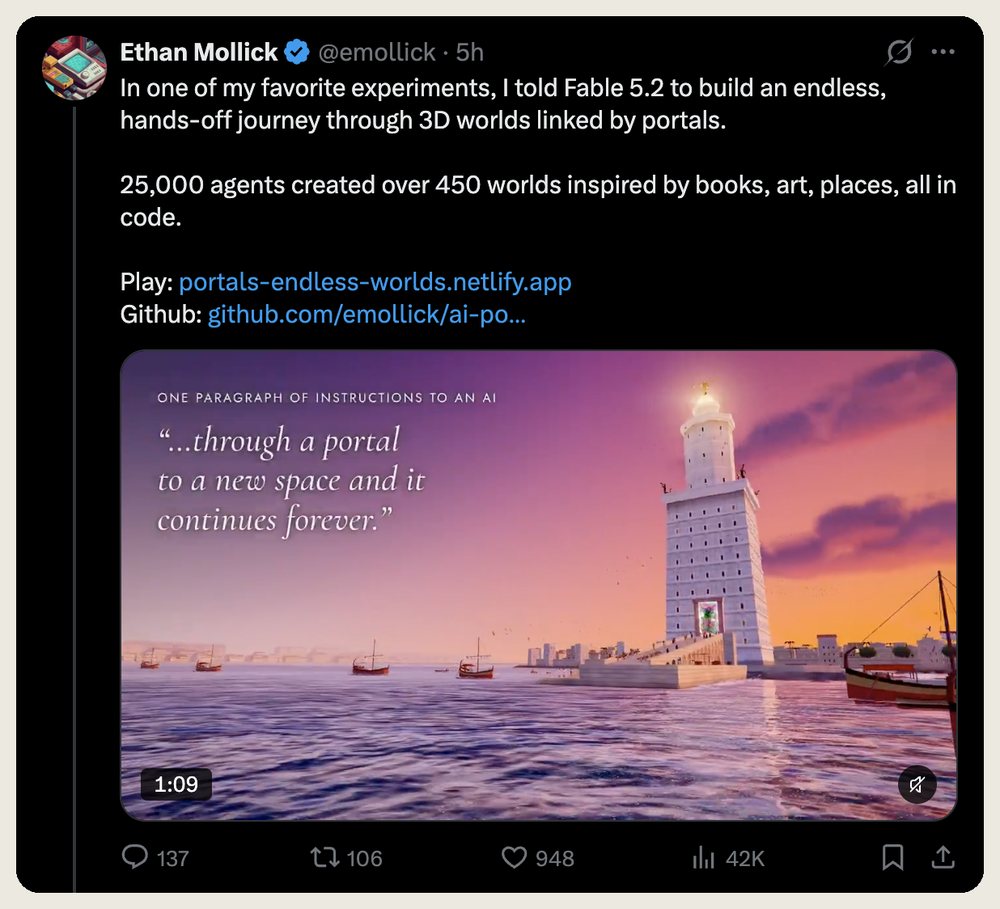
몰릭은 이 사전 사용기에 ‘Jagged AGI’라는 제목을 붙였다. 분야마다 능력이 들쭉날쭉한 범용 인공지능이라는 뜻으로, 거의 전문가처럼 해내는 곳과 이상하게 판단을 못 하는 곳이 함께 있다는 이야기다. 이는 몰릭의 해석이지 AGI를 인증한 공식 평가 결과가 아니다. 그는 AI 연구소에서 돈을 받지 않으며, 사전 접근 중 토큰 사용량은 계량되지 않았다고 밝혔다. 따라서 비용을 직접 지불하는 사용자의 체감과는 차이가 날 수 있다.[17]
몰릭은 다른 실험에서도 글이 너무 길지 않은지, 반복되지 않는지, 재미없지 않은지 AI가 스스로 묻지 않았다고 지적했다. 정확하지만 즐겁지 않은 강의를 만들기도 했다. 더 오래 일하는 능력과 무엇을 덜 해야 하는지 고르는 판단력은 다르다는 이야기다.[17] 페이블을 팀장처럼 쓸 때는 작업량뿐 아니라 완성 기준도 지시해야 한다. “더 많이 만들어라” 대신 “이 독자가 끝까지 읽을 분량으로 줄여라”, “새 규칙을 넣으면 낡은 규칙도 지워라”처럼 목표를 바꿔야 한다.
출시 직후 커뮤니티에서도 비슷한 이야기가 나왔다. 출시 전에 써 봤다는 Hacker News 이용자 postalcoder는 평범한 코딩 작업에서는 페이블 5.2와 Opus 5.5의 차이를 느끼기 어렵고, 프롬프트의 야심을 키워야 격차가 보인다고 썼다. 한 사람의 사용기지만 ‘대부분은 Opus부터’라는 공식 권고와 같은 방향이다.[18]
08그래서 무엇을 고를까: 언제 더 강한 모델로 바꿀까
앤트로픽도 대부분의 코딩과 지식 업무는 Opus 5.5부터 시작하라고 권한다. 페이블은 더 어려운 프로젝트, 더 넓은 탐색, 기존 모델이 막히는 구간에 배치하는 쪽이다.[1] 모든 요청을 가장 비싼 모델로 보내는 대신 어떤 조건에서 모델과 추론 강도를 올릴지 정하는 편이 낫다.
그래서 나는 무엇부터 쓸까?
QUICK GUIDEAnthropic도 대부분의 작업은 Opus 5.5부터 시작하라고 권한다. 막히는 과제를 모아 Fable high와 성공률·총비용을 비교한다.
이 선택기는 글의 실무 제안이지 모델 호출이나 개인별 적합성 검사가 아니다. 실제 과제로 품질·비용·지연 시간을 함께 확인한다.
내가 이 블로그에 적용한다면 먼저 Opus로 초안을 정리하고, 출처끼리 충돌하거나 긴 문서에서 근거를 찾지 못한 항목만 페이블로 보낼 것이다. 답을 받았다는 이유로 검증이 끝나는 것은 아니다. 최종 숫자는 원문과 대조하고, 표와 본문과 계산기가 같은 값을 쓰는지 다시 검사한다. 숫자 자동 검사기가 하는 일과 모델이 하는 일을 나누는 방식이다. 이것은 아직 실행해 본 결과가 아니라 이 글의 자료를 보고 세운 시험 계획이다.
전부 바꾸지 않고 섞어 쓰는 두 가지 방법
앤트로픽은 페이블을 주력으로만 쓰지 말고 두 가지 역할로도 써 보라고 안내한다. 하나는 자문역(Advisor)이다. 평소 작업은 Haiku·Sonnet·Opus가 맡고, 방향을 정하기 전이나 같은 오류가 반복될 때, 완료를 선언하기 전 같은 결정 지점에서만 페이블에게 묻는다. Claude Code에서는 /advisor fable로 켠다. 자문을 구할 때마다 페이블 요금이 붙지만, 모든 턴을 페이블로 돌리는 것보다는 대체로 싸다는 것이 공식 설명이다. 아직 실험 기능이고 Anthropic API에서만 동작한다.[1][19]
다른 하나는 지휘역(Orchestrator)이다. 페이블이 계획을 세우고 단순한 하위 작업은 더 작은 모델에게 넘긴다.[1] 이때는 일을 넘겨받는 에이전트 수에 상한을 두자. Managed Agents의 다중 에이전트 조율은 위임이 한 단계까지, 동시에 열 수 있는 자식 스레드는 25개까지다.[20] 1,000개 에이전트는 연구 실험의 숫자이지 제품 기본값이 아니다.
개발자라면 모델 ID만 바꾸기 전에
공식 모델 전환 가이드(migration guide)는 “네 가지 변경이 코드를 깨뜨릴 수 있다”고 경고한다. 기존 API의 제한까지 섞이면 체크할 항목은 더 많다. 특히 Opus나 이전 세대에서 건너올 때는 다음을 확인하자.[2]
- 추론 설정:
thinking: {type: "disabled"}와 수동budget_tokens설정은 400 오류를 낸다. 추론을 끄는 대신 effort를 선택한다. - 지원하지 않는 생성 옵션:
temperature,top_p,top_k를 제거한다. assistant prefill과 강제 도구 호출도 지원하지 않는다.tool_choice는 auto 또는 none을 쓴다. - 대화 기록: 앞선 턴을 고쳐 보내지 않는다. 페이블 5.2는 모든 계정에서 앞선 대화와 설정이 바뀌었는지 확인하는 검사(prefix check)를 적용한다. 페이블 5.2와 미토스 5.2가 만든 추론 블록은 생성한 계정에 묶이며 이 두 모델만 읽을 수 있다. 다른 모델로 전환할 때 읽지 못하는 블록은 제거되고 그 입력은 청구되지 않는다.
- 도구와 advisor: Bedrock 예외를 빼면 기존
computer_20251124대신computer_toolset_20260801을 선언해야 한다. 5.2 실행 모델의 advisor도 Fable 5.2 또는 Mythos 5.2여야 한다. - 보존·처리 정책: 두 모델은 Covered Models이며 기본 최소 보존 기간은 30일이다. Claude API에서 조건을 만족하지 않는 조직·워크스페이스 요청은 오류가 난다. 기존 무보존 설정을 그대로 유지해도 되는지 공급자 계약을 확인한다. 적격 기업에는 내부 업무용에 한해 한시적으로 무보존(ZDR) 선택지가 주어질 수 있다. 모니터링 데이터를 고객이 관리하는 인프라에 두는 EFS로 넘어가기 위한 과도기 조치이며 자동으로 적용되지는 않는다.
- 비교 측정: API 기본 high를 그대로 두고 앱의 medium 결과와 비교하지 않는다. 같은 프롬프트·도구·종료 조건에서 비용, 시간, 성공률을 함께 기록한다.
- 출력 상한:
max_tokens는 생각과 답을 합친 상한이다. 작게 두면 생각만 하다가 답을 쓰기 전에 멈출 수 있다. high 이상에서는 넉넉하게 잡는다.[14]
Claude Code에서는 /claude-api migrate this project to claude-fable-5-2로 이전 작업에 도움을 받을 수 있다. 다만 자동 수정이 보존 정책이나 계약까지 결정해 주지는 않는다.[2][21]
구독자는 한시 제공과 상시 조건을 나눠 보자
무료 요금제에는 페이블이 없다. Pro와 일반 Team 좌석은 평소 사용 크레딧으로 쓰지만, 출시 행사로 11월 16일 오후 11시 59분 태평양 시간까지 주간 한도의 최대 50% 안에서 페이블을 쓸 수 있다. 토론토 시간으로는 11월 17일 오전 2시 59분이다. Max·Ultra와 일부 프리미엄 좌석의 포함량, 추가 리셋 횟수에는 별도 조건이 있다. 영구 무료 업그레이드로 읽으면 안 된다.[22][23]
Claude Code는 2.1.321 이상이 필요하다.[22] GitHub Copilot에도 일반 제공이 시작됐지만 지원 요금제와 점진적 배포 조건이 있고, 데이터 보존 정책도 확인해야 한다.[24] AWS 경로도 여러 가지다. 같은 회사 모델이라도 Claude API, Bedrock, Copilot을 하나의 가격표와 하나의 예외 규정으로 묶지 말자.[10]
정리하면 페이블 5.2는 ‘매일 쓰던 모델을 무조건 교체하라’보다 전에는 시도하기 어려웠던 큰 일을 시험해 볼 새 선택지에 가깝다. 가장 높은 설정을 켜는 대신 가장 어려운 구간을 찾고, 그곳에 필요한 만큼만 더 생각하게 하는 것이 좋다. 이번 발표의 주인공은 1,000개의 에이전트지만, 실제로 내가 먼저 바꿔야 할 것은 에이전트 수가 아니라 성공의 정의일지 모른다. 코딩 도구 전체의 선택이 궁금하다면 코딩 AI 비교 글을 이어서 읽어 보자.
여담: ‘속도 조절’과 신모델 발표는 모순일까
상장 준비 중 나온 모델이라는 맥락
다리오 아모데이는 9월 글에서 AI 능력 발전의 속도를 조절하자고 제안했다. 신모델이 나온 11월 9일 CNBC 인터뷰에서 앤트로픽의 다이앤 펜은 “우리는 속도 조절을 말했지, 중단을 말한 게 아니다”라고 답했다. 연구를 멈추는 것과 일부 위험 능력을 제한하고 외부 평가를 붙이는 것은 회사가 구분하는 선택이다. 그 구분이 충분한지는 별개의 논쟁이다.[25]
같은 시기 앤트로픽은 상장도 준비하고 있었다. 11월 2일 S-1/A는 나스닥에 ANT라는 종목 코드로 상장을 신청했다고 적었다. 이것은 상장이 완료됐다는 뜻이 아니다. CNBC가 보도한 목표 기업가치는 회사의 확정 공모가격도 아니다. 기술 발표와 기업의 이해관계를 함께 보는 것은 유용하지만, 상장 준비 때문에 특정 벤치마크가 올랐다고 단정할 근거는 없다.[26]
출시를 둘러싼 큰 이야기가 흥미로워도, 내 선택은 다시 작은 질문으로 돌아온다. 이 모델이 내 과제를 더 잘 끝내는가. 그 차이에 얼마를 더 낼 것인가. 그리고 잘못된 길로 가면 내가 알아차릴 수 있는가.
1분 복습: 점수보다 조건을 기억했나
다섯 문장으로 확인하기
QUIZ정답 0 / 5
자주 묻는 질문
질문 6개, 짧은 답
FAQFable 5.2와 Mythos 5.2는 다른 모델인가?
같은 기반 모델이며 사양과 가격도 같다. Mythos는 검증된 사이버 보안·생명과학 사용자에게 더 넓은 분야별 접근을 제공한다.
Fable 5.1보다 가격이 내렸나?
새 입력은 백만 토큰당 $10에서 $8, 출력은 $50에서 $40으로 20% 내렸다. 하지만 생각·출력 토큰을 더 쓰면 작업당 비용은 올라갈 수 있다.
추론 강도 기본값은 무엇인가?
API는 high, Claude 앱과 Claude Code는 medium이다. 서로 다른 기본값을 그대로 비교하면 모델 차이와 설정 차이가 섞인다.
추론을 완전히 끌 수 있나?
아니다. Adaptive thinking은 항상 켜져 있다. disabled나 수동 budget_tokens를 보내면 400 오류가 난다. 지원되는 effort로 조절해야 한다.
점수가 높으면 매일 쓰는 모델도 바꿔야 하나?
반드시 그렇지는 않다. Anthropic은 대부분의 작업에서 Opus 5.5부터 시작하라고 권한다. 어려운 과제에서 Fable의 추가 비용을 회수하는지 직접 확인하는 편이 낫다.
이 글의 데모는 직접 실행한 결과인가?
아니다. 공식 시연, 시스템 카드와 독립 평가를 비교한 글이다. 계산기는 단가 계산용, 시뮬레이터와 애니메이션은 설명용이며 실제 모델을 호출하지 않는다.
출처
- [1]Anthropic · Claude Fable 5.2 and Mythos 5.2 (2026.11.09)
- [2]Claude API docs · Fable 5.2 migration guide
- [3]Anthropic · Fable 5.2 / Mythos 5.2 system card
- [4]Claude API docs · Pricing
- [5]Artificial Analysis · Claude Fable 5.2
- [6]Epoch AI · Epoch Capabilities Index
- [7]Claude Help · Cyber Verification Program
- [8]Claude Help · Life Sciences Verification Program
- [9]Claude API docs · Refusals and fallback
- [10]AWS · Claude Fable 5.2 on AWS
- [11]Claude API docs · Claude Fable 5.2 model overview
- [12]Cursor · CursorBench 4.0
- [13]ARC Prize · Evaluation results
- [14]Claude API docs · Effort
- [15]Claude Developers · Safely scaling multi-agent teams with Fable 5.2
- [16]Anthropic · Claude electronics design research
- [17]Ethan Mollick · Fable 5.2 and Jagged AGI
- [18]Hacker News · postalcoder on using Fable 5.2
- [19]Claude Code docs · Advisor tool
- [20]Claude API docs · Managed Agents multiagent orchestration
- [21]Claude Help · Covered Models and data retention
- [22]Claude Help · Fable models on your plan
- [23]Claude Help · Fable 5.2 launch promotion
- [24]GitHub Changelog · Claude Fable 5.2 in GitHub Copilot (2026.11.09)
- [25]CNBC · Anthropic launches Fable 5.2 and Mythos 5.2 (2026.11.09)
- [26]SEC EDGAR · Anthropic, PBC Form S-1/A (2026.11.02 제출)
2026년 11월 9일(일부 수치는 11월 10일) 토론토 시각에 확인한 자료를 중심으로 작성했다. 순위·가격·이용 조건은 바뀔 수 있다. 그림의 움직임은 설명용 연출이며 직접 모델을 실행한 결과가 아니다. 상표와 공식 이미지의 권리는 각 소유자에게 있다.